Tipos de bases de datos: relacionales, NoSQL y más
Lección 1.2 · Tiempo de lectura: ~15 min · Tareas de práctica ↓
Existen muchos tipos de bases de datos, y cada uno está optimizado para un tipo concreto de datos, un patrón de consultas o un requisito de escalabilidad. En esta lección conocerás los principales modelos de bases de datos (relacional, clave-valor, documental, de columnas anchas, de grafos, de series temporales y columnar), sus diferencias clave, sus usos típicos y ejemplos de sistemas reales.
En la lección anterior presentamos la idea general de base de datos y de SGBD. En la práctica, no todas las bases de datos están construidas de la misma manera. Los distintos tipos están optimizados para distintas clases de datos, patrones de consulta, requisitos de escalabilidad y necesidades de consistencia.
También veremos más de cerca las bases de datos relacionales, porque seguirán siendo nuestro tema principal durante todo el curso.
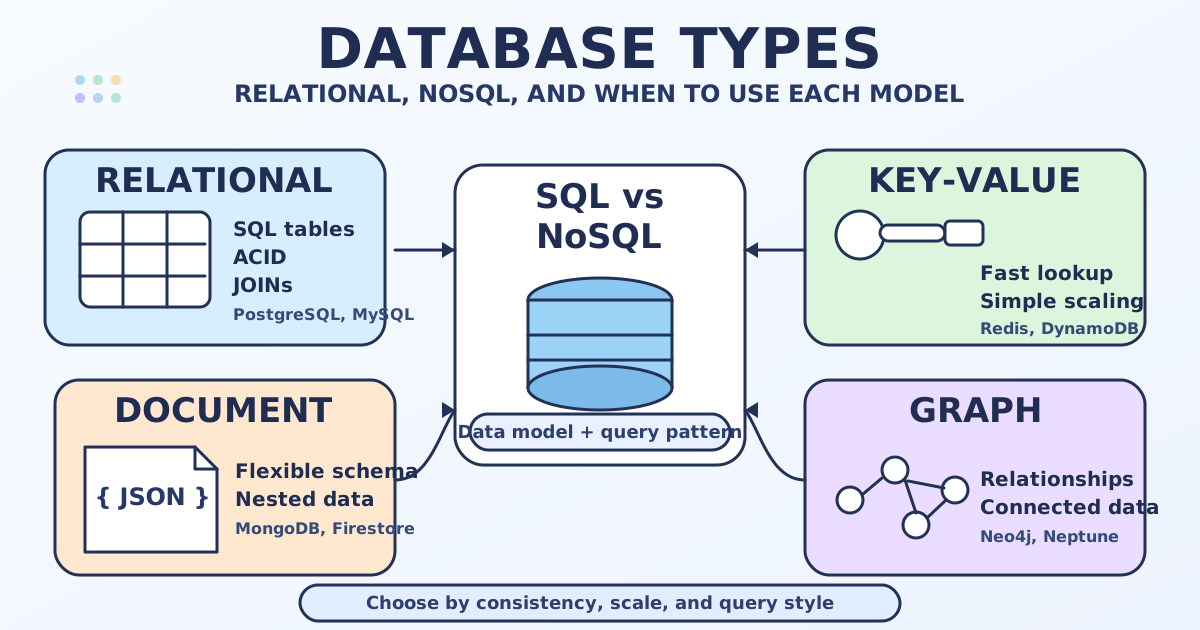
¿Por qué existen distintos tipos de bases de datos?
Ningún diseño de base de datos es perfecto para todas las aplicaciones.
Por ejemplo:
- Un sistema bancario necesita consistencia estricta y transacciones fiables.
- Un sistema de caché necesita búsquedas por clave extremadamente rápidas.
- Una red social puede necesitar un almacenamiento de documentos flexible y un análisis de relaciones al estilo de un grafo.
- Una plataforma de análisis puede necesitar recorrer miles de millones de valores de forma eficiente para sus informes.
Como cada sistema resuelve problemas distintos, con el tiempo han surgido varios modelos de bases de datos.
Principales tipos de bases de datos: tabla comparativa
Una comparación rápida antes de ver cada tipo con más detalle:
| Tipo | Modelo de datos | Puntos fuertes | Usos habituales | Ejemplos |
|---|---|---|---|---|
| Relacional | Tablas con filas y columnas | Consistencia estricta, SQL, joins, datos estructurados | Banca, ERP, CRM, comercio electrónico, informes | PostgreSQL, MySQL, MariaDB, SQLite, Oracle |
| Clave-valor | Una clave asociada a un valor | Búsquedas muy rápidas, escalado sencillo | Caché, sesiones, feature flags, carritos de compra | Redis, Amazon DynamoDB, Riak |
| Documental | Documentos de tipo JSON | Esquema flexible, datos anidados | Gestión de contenidos, perfiles de usuario, catálogos, aplicaciones web | MongoDB, Couchbase, Firestore |
| Columnas anchas | Filas con columnas flexibles agrupadas en familias | Alto rendimiento de escritura, escalado horizontal | Registro de eventos, IoT, cargas distribuidas a gran escala | Apache Cassandra, HBase, ScyllaDB |
| Grafos | Nodos y aristas | Consultas centradas en relaciones | Redes sociales, detección de fraude, motores de recomendación | Neo4j, Amazon Neptune, ArangoDB |
| Series temporales | Registros con marca de tiempo | Ingesta y agregación eficientes a lo largo del tiempo | Monitorización, métricas, sensores, cotizaciones | InfluxDB, TimescaleDB, OpenTSDB |
| Columnar analítica | Datos guardados por columna en lugar de por fila | Lecturas analíticas y agregaciones rápidas | BI, paneles, almacenes de datos, OLAP | ClickHouse, DuckDB, Amazon Redshift, BigQuery |
| En memoria | Datos guardados principalmente en la RAM | Latencia extremadamente baja | Caché, clasificaciones, contadores en tiempo real | Redis, Memcached, SAP HANA |
Bases de datos relacionales
Las bases de datos relacionales guardan los datos en tablas formadas por filas y columnas. Las tablas pueden conectarse entre sí mediante relaciones, normalmente con claves primarias y claves foráneas.
Este modelo es especialmente adecuado cuando los datos están bien estructurados y cuando importan la exactitud, la consistencia y las consultas complejas.
Propiedades principales de las bases de datos relacionales
1. Esquema estructurado
Las bases de datos relacionales suelen exigir un esquema claramente definido. Antes de guardar datos, defines las tablas, las columnas, los tipos de datos, las restricciones y las relaciones.
Así la estructura es predecible y más fácil de validar.
2. Relaciones entre tablas
Una gran ventaja de los sistemas relacionales es que permiten modelar las relaciones de forma explícita.
Por ejemplo:
- Una tabla
customerspuede relacionarse con una tablaorders. - Una tabla
orderspuede relacionarse con una tablaorder_items.
Por eso las bases de datos relacionales encajan muy bien en sistemas de negocio donde las entidades están interconectadas.
3. Soporte de SQL
Las bases de datos relacionales se consultan habitualmente con SQL (Structured Query Language). SQL ofrece una forma estándar de filtrar, combinar, agregar, ordenar y modificar datos estructurados.
4. Transacciones ACID
Las bases de datos relacionales son conocidas por cumplir las propiedades ACID:
- Atomicidad: una transacción se completa entera o falla entera.
- Consistencia: los datos deben seguir siendo válidos según las reglas definidas.
- Aislamiento: las transacciones simultáneas no deben interferir incorrectamente entre sí.
- Durabilidad: una vez confirmados, los datos siguen guardados incluso después de un fallo.
Estas propiedades son críticas en sistemas como la banca, la facturación, las reservas y el control de inventario.
5. Restricciones de integridad de datos
Las bases de datos relacionales pueden aplicar reglas directamente en la capa de la base de datos, por ejemplo:
- claves primarias
- claves foráneas
- restricciones de unicidad
- restricciones
NOT NULL - restricciones de comprobación (check)
Estas funciones ayudan a evitar datos no válidos o inconsistentes.
6. Joins potentes e informes
Las bases de datos relacionales destacan cuando hay que combinar información de varias tablas. Es una de las razones por las que siguen siendo centrales en informes, analítica, finanzas, operaciones y muchos sistemas transaccionales.
7. Normalización y menos redundancia
El diseño relacional suele usar la normalización, es decir, organizar los datos en tablas relacionadas para reducir la duplicación y mejorar la consistencia.
Por ejemplo, los datos de un cliente pueden guardarse una sola vez en una tabla customers en lugar de repetirse en cada pedido.
Usos habituales de las bases de datos relacionales
Una base de datos relacional suele ser la mejor opción cuando:
- los datos están estructurados y claramente definidos
- las relaciones entre entidades son importantes
- las transacciones deben ser fiables
- la consistencia importa más que la flexibilidad del esquema
- la aplicación necesita consultas e informes complejos
Ejemplos de bases de datos relacionales
- PostgreSQL: potente base de datos relacional de código abierto, con buen soporte de los estándares y funciones avanzadas.
- MySQL: base de datos relacional muy popular, muy usada en aplicaciones web.
- MariaDB: fork de MySQL desarrollado por la comunidad.
- SQLite: base de datos relacional ligera e integrada que se guarda en un solo archivo.
- Oracle Database: base de datos relacional de nivel empresarial.
- Microsoft SQL Server: base de datos relacional muy usada en entornos empresariales.
Bases de datos clave-valor
Las bases de datos clave-valor guardan los datos como un par sencillo: una clave y su valor asociado.
La clave funciona como un identificador único, y la base de datos obtiene el valor directamente a partir de ella. Este modelo es muy sencillo y muy rápido.
Diferencias clave
- El acceso a los datos suele basarse en una sola clave y no en joins complejos.
- A menudo la base de datos no conoce la estructura interna del valor.
- Está optimizada para lecturas y escrituras extremadamente rápidas.
Usos típicos
- caché de resultados de consultas
- almacenamiento de sesiones de usuario
- carritos de compra
- feature flags
- limitación de peticiones (rate limiting)
- clasificaciones y contadores
Ejemplos
- Redis
- Amazon DynamoDB
- Riak
Bases de datos documentales
Las bases de datos documentales guardan los datos como documentos, normalmente en un formato similar a JSON. Cada documento puede contener campos, arrays y objetos anidados.
A diferencia de las bases de datos relacionales, no todos los documentos tienen que tener exactamente la misma estructura.
Diferencias clave
- El esquema es flexible o semiflexible.
- Los datos relacionados a menudo pueden guardarse juntos en un solo documento.
- Son cómodas para aplicaciones cuya estructura cambia con frecuencia.
Usos típicos
- sistemas de gestión de contenidos
- catálogos de productos
- perfiles de usuario
- aplicaciones móviles y web
- prototipos de sistemas con requisitos cambiantes
Ejemplos
- MongoDB
- Couchbase
- Google Firestore
Bases de datos de columnas anchas
Las bases de datos de columnas anchas, también llamadas bases de datos de familias de columnas, guardan los datos en filas, pero cada fila puede tener un conjunto de columnas muy grande y flexible. Están diseñadas para repartirse entre muchos servidores y para soportar un gran volumen de escrituras.
Diferencias clave
- El esquema es más flexible que en las bases de datos relacionales.
- Están optimizadas para el almacenamiento distribuido a gran escala.
- Manejan bien conjuntos de datos enormes y cargas de escritura intensas.
- Normalmente no admiten joins relacionales como las bases de datos SQL.
Usos típicos
- registro de eventos
- telemetría de IoT
- sistemas de mensajería
- aplicaciones con muchas escrituras
- sistemas distribuidos geográficamente
Ejemplos
- Apache Cassandra
- Apache HBase
- ScyllaDB
Bases de datos columnares analíticas
Una base de datos columnar guarda juntos en el disco los valores de una misma columna, en lugar de guardar juntas las filas completas. No es lo mismo que una base de datos de columnas anchas.
El almacenamiento por columnas es especialmente eficiente para consultas analíticas que leen pocas columnas de un conjunto de datos muy grande.
Diferencias clave
- Están optimizadas para recorrer y agregar grandes volúmenes de datos.
- Son muy eficientes para informes y analítica.
- Suelen ser menos adecuadas para cargas transaccionales intensas con muchas actualizaciones pequeñas de filas.
Usos típicos
- inteligencia de negocio
- paneles
- almacenes de datos (data warehousing)
- informes analíticos
- análisis de registros a gran escala
Ejemplos
- ClickHouse
- DuckDB
- Amazon Redshift
- Google BigQuery
Bases de datos de grafos
Las bases de datos de grafos están pensadas para datos en los que las relaciones son la parte más importante del modelo. Guardan nodos (entidades) y aristas (relaciones).
Diferencias clave
- Recorrer relaciones es rápido y natural.
- Son ideales para consultar caminos, redes y datos conectados.
- A menudo encajan mejor que las bases de datos relacionales en consultas que siguen muchos saltos de relaciones.
Usos típicos
- redes sociales
- detección de fraude
- sistemas de recomendación
- topología de redes
- grafos de conocimiento
Ejemplos
- Neo4j
- Amazon Neptune
- ArangoDB
Bases de datos de series temporales
Las bases de datos de series temporales están especializadas en datos asociados a un momento en el tiempo. Están optimizadas para altas tasas de ingesta, políticas de retención, compresión y agregación por tiempo.
Diferencias clave
- Cada registro está asociado a una marca de tiempo.
- Las consultas suelen centrarse en rangos como la última hora, el último día o el último mes.
- Ofrecen agregación eficiente por ventanas de tiempo.
Usos típicos
- monitorización de servidores
- métricas de aplicaciones
- datos de sensores
- datos bursátiles
- mediciones industriales
Ejemplos
- InfluxDB
- TimescaleDB
- OpenTSDB
Bases de datos en memoria
Las bases de datos en memoria guardan la mayoría de los datos, o todos, en la RAM en lugar del disco. Eso las hace extremadamente rápidas, aunque la memoria es más cara que el almacenamiento en disco.
Algunas bases de datos en memoria se usan solo como caché temporal, mientras que otras también pueden persistir los datos en disco.
Usos típicos
- caché
- almacenamiento de sesiones
- contadores en tiempo real
- clasificaciones de videojuegos
- sistemas de latencia ultrabaja
Ejemplos
- Redis
- Memcached
- SAP HANA
Cómo elegir el tipo de base de datos adecuado
Al elegir una base de datos, hazte preguntas como estas:
- ¿Los datos están muy estructurados o son flexibles?
- ¿Necesito transacciones ACID estrictas?
- ¿Voy a ejecutar joins complejos?
- ¿La prioridad es una búsqueda por clave de baja latencia?
- ¿La carga es transaccional o analítica?
- ¿El sistema tendrá que escalar a muchos servidores?
- ¿Las relaciones entre entidades son centrales en la aplicación?
En muchos sistemas reales, las organizaciones usan más de un tipo de base de datos. Por ejemplo:
- una base de datos relacional para los datos principales del negocio
- Redis como caché
- una base de datos documental para el contenido flexible
- un almacén columnar para la analítica
Esto se suele llamar persistencia políglota.
Resumen: diferencias clave entre los tipos de bases de datos
Las principales diferencias entre los tipos de bases de datos suelen estar en:
- el modelo de datos: tablas, documentos, pares clave-valor, grafos o registros con marca de tiempo
- la flexibilidad del esquema: estructura fija frente a flexible
- el estilo de consulta: SQL, búsqueda por clave, consultas sobre documentos, recorrido de grafos, análisis por ventanas de tiempo
- el modelo de consistencia: garantías transaccionales estrictas frente a compromisos orientados a la escalabilidad
- el perfil de rendimiento: optimizado para transacciones, analítica, relaciones o acceso ultrarrápido
Puntos clave:
- Existen distintos tipos de bases de datos porque cada aplicación tiene requisitos técnicos y de negocio diferentes.
- Las bases de datos relacionales destacan por sus esquemas estructurados, SQL, relaciones, restricciones de integridad y transacciones ACID.
- Las bases de datos clave-valor son excelentes para búsquedas rápidas y caché.
- Las bases de datos documentales son útiles cuando la estructura de los datos es flexible o cambia a menudo.
- Las bases de datos de columnas anchas están hechas para cargas distribuidas, a gran escala y con muchas escrituras.
- Las bases de datos columnares analíticas están optimizadas para informes y analítica a gran escala.
- Las bases de datos de grafos son ideales para datos con muchas relaciones.
- Las bases de datos de series temporales se especializan en métricas y eventos basados en el tiempo.
- Muchos sistemas modernos usan varios tipos de bases de datos a la vez (persistencia políglota).
Preguntas frecuentes
¿Qué diferencia hay entre las bases de datos relacionales y las NoSQL?
Las bases de datos relacionales usan un esquema fijo basado en tablas, aplican transacciones ACID y se consultan con SQL. NoSQL es un término general que abarca los modelos clave-valor, documental, de columnas anchas y de grafos: sacrifican parte de las garantías de consistencia a cambio de flexibilidad en el esquema o escalabilidad horizontal. Ninguno es mejor en todos los casos; la elección correcta depende de tus datos y de tu carga de trabajo.
¿Cuándo usar una base de datos documental en lugar de una relacional?
Usa una base de datos documental cuando tus datos tienen una estructura anidada y variable por naturaleza (por ejemplo, catálogos de productos con atributos distintos para cada producto) y rara vez necesitas combinar colecciones. Usa una base de datos relacional cuando los datos están estructurados, las entidades están relacionadas entre sí y necesitas transacciones fiables y consultas complejas sobre varias tablas.
¿Puede una misma aplicación usar varios tipos de bases de datos?
Sí, y se llama persistencia políglota. Es habitual en sistemas en producción: por ejemplo, PostgreSQL para los datos transaccionales, Redis como caché y ClickHouse para la analítica. Cada tipo de base de datos se usa donde mejor rinde.
Preguntas de entrevista
¿Qué tipo de base de datos elegirías para un caso concreto y por qué?
Parte de la carga de trabajo y de las restricciones: la estructura de los datos, las necesidades de consistencia, los patrones de consulta, los objetivos de latencia y la escala. Por ejemplo, elige una base de datos relacional para sistemas transaccionales con muchos requisitos ACID, una base de datos documental para registros flexibles de tipo JSON y una base de datos de series temporales para métricas con marca de tiempo y políticas de retención.
¿Qué ventajas e inconvenientes tiene un tipo de base de datos frente a otro?
Cada modelo es un compromiso. Las bases de datos relacionales ofrecen consistencia estricta, joins y herramientas SQL maduras, pero los cambios de esquema pueden ser más rígidos a gran escala. Los modelos NoSQL suelen ofrecer más flexibilidad o mejor escalado horizontal, pero pueden limitar los joins o exigir un diseño cuidadoso de la consistencia.
¿Se pueden usar distintos tipos de bases de datos en una misma aplicación?
Sí. Es la persistencia políglota: usar varias bases de datos, cada una para la carga que mejor maneja. Un patrón habitual es PostgreSQL para las transacciones principales, Redis como caché y ClickHouse (u otro sistema columnar) para la analítica.