Subconsultas correlacionadas en SQL
Lección 6.3 · Tiempo de lectura: ~6 min · Tareas de práctica ↓
Una subconsulta correlacionada en SQL es una subconsulta que hace referencia a una columna de la consulta externa, por lo que su resultado depende de la fila externa actual. En esta lección aprenderás cómo se evalúa una subconsulta correlacionada, cómo comparar una fila con su propio grupo, cómo usar subconsultas correlacionadas en SELECT y con EXISTS, y cuándo conviene más un JOIN.
Las subconsultas de las lecciones anteriores eran independientes: se podía seleccionar la consulta interna y ejecutarla sola. Una subconsulta correlacionada no se puede ejecutar sola, porque usa un valor de la fila que la consulta externa está revisando en ese momento. Esto permite hacer preguntas relativas a cada fila: "¿esta película es más cara que el promedio de su clasificación?", "¿cuál es la película más larga de esta categoría?".
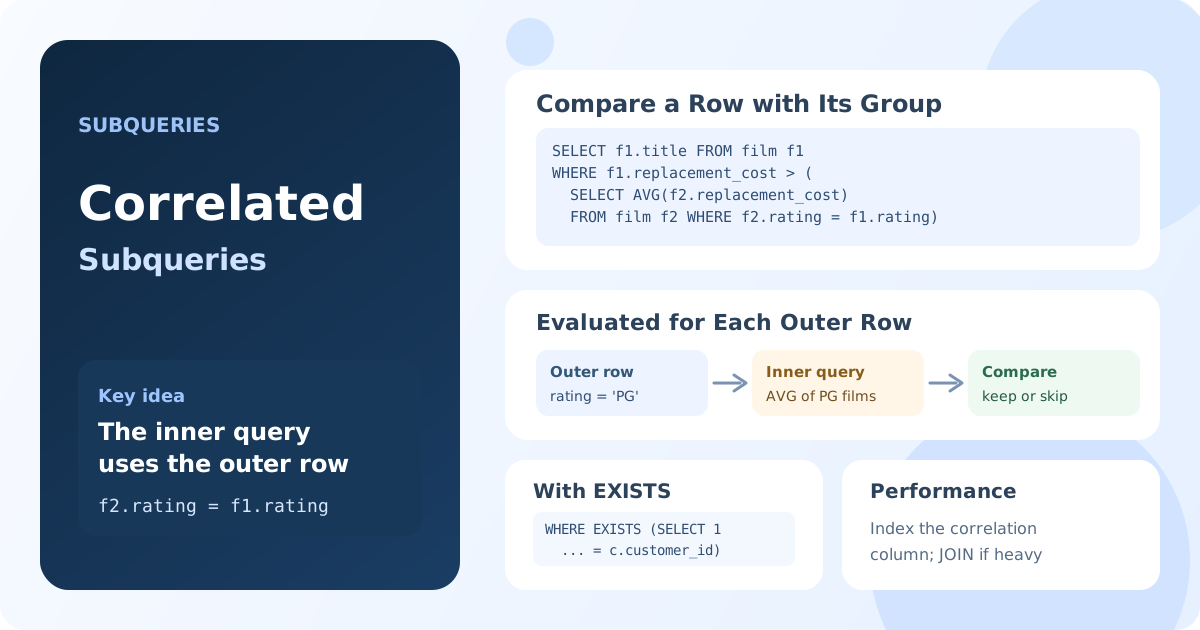
Cómo funciona una subconsulta correlacionada
Lógicamente, la base de datos evalúa una subconsulta correlacionada así:
- Toma una fila de la consulta externa.
- Ejecuta la consulta interna reemplazando los valores de esa fila.
- Usa el resultado para evaluar la condición o la columna de la fila.
- Pasa a la fila siguiente y repite.
El vínculo entre las consultas es una condición en la consulta interna que usa un alias externo, por ejemplo f2.rating = f1.rating. Los alias son esenciales: sin ellos no queda claro a qué copia de la tabla pertenece una columna.
Comparar una fila con su grupo
Películas cuyo costo de reposición es mayor que el promedio de su clasificación:
SELECT f1.title, f1.rating, f1.replacement_cost
FROM film AS f1
WHERE f1.replacement_cost > (
    SELECT AVG(f2.replacement_cost)
    FROM film AS f2
    WHERE f2.rating = f1.rating
)
ORDER BY f1.rating, f1.replacement_cost DESC;
Resultado: las películas cuya reposición cuesta más que la de la película promedio de la misma clasificación.
Para una película con clasificación PG, la consulta interna calcula el promedio de las películas PG; para una película R, el de las R. Una subconsulta no correlacionada solo podría comparar con un único promedio general.
Subconsultas correlacionadas en SELECT
Una subconsulta correlacionada en la lista del SELECT devuelve un valor para cada fila. La cantidad de películas de cada categoría:
SELECT c.name AS category,
       (SELECT COUNT(*)
        FROM film_category AS fc
        WHERE fc.category_id = c.category_id) AS films
FROM category AS c
ORDER BY films DESC;
Resultado: 16 categorías con su cantidad de películas, empezando por Sports (74 películas).
También puede devolver un valor difícil de obtener con GROUP BY, como el título de la película más larga de cada categoría:
SELECT c.name AS category,
       (SELECT f.title
        FROM film AS f
        INNER JOIN film_category AS fc ON fc.film_id = f.film_id
        WHERE fc.category_id = c.category_id
        ORDER BY f.length DESC, f.title
        LIMIT 1) AS longest_film
FROM category AS c
ORDER BY c.name;
Resultado: cada categoría con el título de su película más larga; los empates se resuelven por título.
Una subconsulta en SELECT debe devolver una fila y una columna; si no, la consulta falla.
Subconsultas correlacionadas con EXISTS
EXISTS comprueba si la consulta interna devuelve al menos una fila, y casi siempre es correlacionada. Clientes que alquilaron al menos una copia de la tienda 2:
SELECT c.customer_id, c.first_name, c.last_name
FROM customer AS c
WHERE EXISTS (
    SELECT 1
    FROM rental AS r
    INNER JOIN inventory AS i ON i.inventory_id = r.inventory_id
    WHERE r.customer_id = c.customer_id
      AND i.store_id = 2
)
ORDER BY c.customer_id;
Resultado: los clientes con al menos un alquiler de una copia de la tienda 2. SELECT 1 es una convención: EXISTS solo comprueba si existe una fila, no qué contiene.
NOT EXISTS encuentra filas sin coincidencia, como el anti-join LEFT JOIN ... IS NULL de la lección 5.3.
Rendimiento
La descripción "se ejecuta para cada fila" es el modelo lógico. Los optimizadores modernos suelen reescribir las subconsultas correlacionadas como joins o semijoins, sobre todo EXISTS e IN. Aun así:
- Una subconsulta correlacionada en
SELECTo en unWHEREcomplejo puede ejecutarse de verdad una vez por fila externa y volverse lenta en tablas grandes. - Un índice en la columna de correlación (aquí
film_category.category_id,rental.customer_id) hace que cada ejecución interna sea rápida. - Si el mismo resultado interno se necesita para muchas columnas, un
JOINcon una subconsulta agrupada o un CTE (lección 6.4) suele ser más claro y más rápido.
Si una consulta con una subconsulta correlacionada es lenta, revisa el plan con EXPLAIN.
Conclusiones clave:
- Una subconsulta correlacionada hace referencia a una columna de la consulta externa y no se puede ejecutar sola.
- Lógicamente, se evalúa una vez por cada fila externa.
- Es la herramienta natural para comparar una fila con su propio grupo.
- En
SELECT, debe devolver exactamente un valor. EXISTSyNOT EXISTSson subconsultas correlacionadas típicas.- Indexa la columna de correlación; considera un
JOINo un CTE para consultas pesadas.
Preguntas frecuentes
¿Cuál es la diferencia entre una subconsulta correlacionada y una no correlacionada?
Una subconsulta no correlacionada es independiente: se ejecuta una vez y su resultado sirve para todas las filas. Una subconsulta correlacionada usa valores de la fila externa, así que su resultado puede ser distinto para cada fila.
¿Las subconsultas correlacionadas son lentas?
Pueden serlo, porque lógicamente se ejecutan para cada fila externa. En la práctica, los optimizadores suelen convertirlas en joins, y un índice en la columna de correlación ayuda mucho. Revisa el plan de ejecución con EXPLAIN.
¿Se puede reemplazar una subconsulta correlacionada por un JOIN?
Por lo general, sí. Por ejemplo, la comparación con el promedio del grupo se puede escribir como un join con una subconsulta agrupada: JOIN (SELECT rating, AVG(replacement_cost) AS avg_cost FROM film GROUP BY rating) AS r ON r.rating = f.rating.