Cómo leer EXPLAIN
Lección 10.4 · Tiempo de lectura: ~12 min · Tareas de práctica ↓
EXPLAIN muestra cómo la base de datos va a ejecutar tu consulta: qué tablas lee, en qué orden, si usa un índice y cuántas filas espera. En esta lección leerás línea a línea planes reales de MySQL y PostgreSQL, compararás las estimaciones del optimizador con las cifras reales de EXPLAIN ANALYZE y aprenderás las señales de una consulta lenta.
En la lección anterior creaste índices. Pero un índice solo ayuda si la base de datos realmente lo usa, y la única forma de saberlo es mirar el plan de ejecución. El plan cambia las suposiciones por hechos: en lugar de "la consulta es lenta, quizá falte un índice", ves exactamente qué paso lee demasiadas filas.
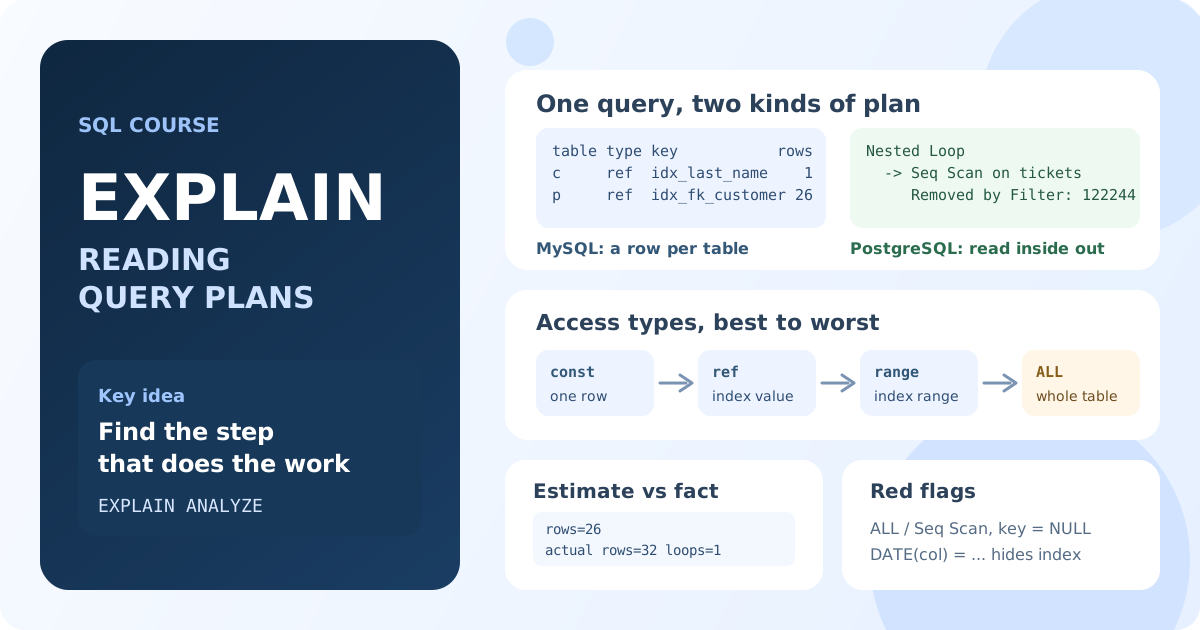
Qué es un plan de ejecución
Antes de ejecutar una consulta, el optimizador elige cómo hacerlo: qué tabla leer primero, si usa un índice o recorre toda la tabla, cómo unir las tablas y cómo ordenar. El resultado de esa elección es el plan de ejecución. El optimizador escoge el plan con el menor coste (cost) estimado, y calcula el coste a partir de estadísticas: cuántas filas tiene cada tabla y cómo se distribuyen los valores.
El plan se obtiene poniendo una palabra clave delante de la consulta:
| SGBD | Solo el plan | Plan y ejecución real |
|---|---|---|
| MySQL, MariaDB | EXPLAIN | EXPLAIN ANALYZE (MySQL 8.0.18+), ANALYZE (MariaDB) |
| PostgreSQL | EXPLAIN | EXPLAIN ANALYZE, a menudo con BUFFERS |
| SQLite | EXPLAIN QUERY PLAN | no hay |
| SQL Server | SET SHOWPLAN_TEXT ON o "Display Estimated Execution Plan" en SSMS | SET STATISTICS PROFILE ON o "Include Actual Execution Plan" |
| Oracle | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | DBMS_XPLAN.DISPLAY_CURSOR |
EXPLAIN solo construye el plan y no ejecuta la consulta. EXPLAIN ANALYZE la ejecuta y añade el tiempo y el número de filas reales.
MySQL: el formato de tabla
Busquemos los pagos de los clientes apellidados Smith en la base Sakila:
EXPLAIN
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
Resultado (MySQL 8.0):
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| id | select_type | table | type | possible_keys         | key                | ref                  | rows | filtered | Extra |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| 1  | SIMPLE      | c     | ref  | PRIMARY,idx_last_name | idx_last_name      | const                | 1    | 100.00   | NULL  |
| 1  | SIMPLE      | p     | ref  | idx_fk_customer_id    | idx_fk_customer_id | sakila.c.customer_id | 26   | 100.00   | NULL  |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
Cada fila es una tabla, en el orden en que MySQL la lee: primero customer y, para cada cliente encontrado, payment. Esto significan las columnas:
table: la tabla (o su alias) que se lee en este paso.type: cómo se accede a las filas. Es la columna más importante.possible_keys: índices que podrían usarse;key: el índice elegido.NULLenkeysignifica que no se usa ningún índice.ref: con qué se compara el índice: una constante (const) o una columna de la tabla anterior (sakila.c.customer_id).rows: cuántas filas espera leer MySQL en este paso. Es una estimación, no un hecho.filtered: el porcentaje de esas filas que se espera que pase el resto de condiciones.Extra: detalles adicionales, ver más abajo.
Lectura del plan: MySQL encuentra al cliente por el índice de last_name (espera 1 fila) y, para ese cliente, busca los pagos por el índice de customer_id (espera 26 filas). Los dos pasos usan índices, así que la consulta lee unas decenas de filas entre más de 16 000 pagos.
Tipos de acceso de la columna type
Del mejor al peor:
type | Qué ocurre | Ejemplo |
|---|---|---|
const, eq_ref | como mucho una fila por clave primaria o única | WHERE customer_id = 1 en customer |
ref | varias filas por un valor del índice | WHERE last_name = 'SMITH' |
range | un rango del índice | BETWEEN, >, <, IN (...) |
index | se lee el índice entero | el índice contiene todas las columnas necesarias, pero no hay filtro por su primera columna |
ALL | se lee la tabla entera (full table scan) | una condición sobre una columna sin índice |
ALL en una tabla de referencia pequeña no es un problema. ALL en una tabla grande, en una consulta que necesita pocas filas, es lo primero que hay que corregir.
La columna Extra
Using index: todas las columnas necesarias están en el índice y la tabla no se lee (índice de cobertura). Bien.Using where: las filas se filtran después de leerlas. Normal por sí solo, un problema junto conALLen una tabla grande.Using index condition: la condición se comprueba dentro del índice antes de leer la fila (index condition pushdown).Using temporary: se crea una tabla temporal intermedia, normalmente paraGROUP BYoDISTINCT.Using filesort: las filas se ordenan aparte, en lugar de leerse en el orden del índice.
Por ejemplo, los cinco clientes que más pagaron:
EXPLAIN
SELECT customer_id, SUM(amount) AS total
FROM payment
GROUP BY customer_id
ORDER BY total DESC
LIMIT 5;
Resultado: type = index, rows = 15577, Extra = Using temporary; Using filesort. MySQL lee el índice entero, agrupa los pagos en una tabla temporal y ordena las sumas. Aquí no se puede evitar: el orden por una suma calculada solo se conoce cuando todas las filas están agrupadas. Con 16 000 filas es rápido; con 100 millones, un informe así se calcularía de antemano (por ejemplo, en una tabla resumen).
Cómo una función esconde un índice
La tabla rental tiene un índice sobre rental_date. Compara dos consultas que devuelven los mismos 504 alquileres del 6 de julio de 2005:
EXPLAIN
SELECT *
FROM rental
WHERE rental_date >= '2005-07-06' AND rental_date < '2005-07-07';
Resultado: type = range, key = rental_date, rows = 504.
EXPLAIN
SELECT *
FROM rental
WHERE DATE(rental_date) = '2005-07-06';
Resultado: type = ALL, key = NULL, rows = 15831.
El índice está ordenado por rental_date, no por DATE(rental_date). Cuando la columna va dentro de una función, la base de datos no puede buscar en el índice y revisa cada fila. La solución es dejar la columna "desnuda" y pasar el cálculo al otro lado de la comparación, como en la primera consulta. Las condiciones que pueden usar así un índice se llaman SARGable.
Árboles de plan: FORMAT=TREE y EXPLAIN ANALYZE en MySQL
El formato de tabla oculta cómo se anidan los pasos. MySQL 8 puede mostrar el plan como un árbol:
EXPLAIN FORMAT=TREE
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
-> Nested loop inner join  (cost=9.45 rows=26)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26)
Un árbol se lee de dentro hacia fuera: las líneas con más sangría se ejecutan primero, y cada una pasa sus filas a la línea de arriba. Aquí el primer hijo encuentra al cliente, el segundo encuentra los pagos de cada cliente y el Nested loop inner join de arriba combina las filas.
EXPLAIN ANALYZE ejecuta la consulta y añade las cifras reales a cada paso:
-> Nested loop inner join  (cost=9.45 rows=26) (actual time=0.139..0.157 rows=32 loops=1)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1) (actual time=0.0572..0.0586 rows=1 loops=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26) (actual time=0.0555..0.0688 rows=32 loops=1)
rows=26es la estimación,actual ... rows=32es el hecho. El señor Smith hizo 32 pagos, mientras que las estadísticas sugerían 26 de media por cliente.actual time=0.0555..0.0688: milisegundos hasta la primera y hasta la última fila de este paso.loops: cuántas veces se ejecutó el paso. El lado interno de un nested loop se ejecuta una vez por cada fila del lado externo.
Una estimación que falla un 20 % es normal. Una que falla 100 veces significa que el optimizador eligió el plan con datos erróneos, y el plan también puede ser erróneo.
PostgreSQL: leer el árbol del plan
PostgreSQL siempre muestra un árbol. Una consulta por clave primaria en la base Bookings:
EXPLAIN
SELECT *
FROM bookings.flights
WHERE flight_id = 1001;
Index Scan using flights_pkey on flights  (cost=0.29..8.31 rows=1 width=63)
  Index Cond: (flight_id = 1001)
Cada nodo indica:
- la operación:
Seq Scan(toda la tabla),Index Scan(índice más filas de la tabla),Index Only Scan(solo el índice),Bitmap Heap Scan(primero reúne las filas mediante el índice y luego las lee de la tabla en el orden de almacenamiento); cost=0.29..8.31: el coste estimado hasta la primera fila y para todas las filas, en unidades abstractas (no en milisegundos);rows: el número estimado de filas de salida;width: el tamaño medio de la fila en bytes;- las líneas de debajo: la condición del índice (
Index Cond) o el filtro (Filter).
No hay índice sobre departure_airport, así que una búsqueda por aeropuerto lee toda la tabla:
EXPLAIN
SELECT flight_id, scheduled_departure
FROM bookings.flights
WHERE departure_airport = 'DME';
Seq Scan on flights  (cost=0.00..806.01 rows=3217 width=12)
  Filter: (departure_airport = 'DME'::bpchar)
Aquí el recorrido completo es razonable: la consulta devuelve cerca del 10 % de la tabla, y leer 33 000 filas seguidas es barato.
EXPLAIN ANALYZE en PostgreSQL
Los billetes de una reserva:
EXPLAIN ANALYZE
SELECT t.passenger_name, tf.fare_conditions, tf.amount
FROM bookings.tickets t
JOIN bookings.ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '00000F';
Gather  (cost=1000.42..9103.17 rows=6 width=30) (actual time=409.864..415.535 rows=2.00 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Nested Loop  (cost=0.42..8102.57 rows=2 width=30) (actual time=388.369..389.800 rows=0.67 loops=3)
        ->  Parallel Seq Scan on tickets t  (cost=0.00..8086.07 rows=1 width=30) (actual time=386.664..387.206 rows=0.33 loops=3)
              Filter: (book_ref = '00000F'::bpchar)
              Rows Removed by Filter: 122244
        ->  Index Scan using ticket_flights_pkey on ticket_flights tf  (cost=0.42..16.47 rows=3 width=28) (actual time=5.061..7.713 rows=2.00 loops=1)
              Index Cond: (ticket_no = t.ticket_no)
Planning Time: 45.638 ms
Execution Time: 415.774 ms
Leyendo de dentro hacia fuera:
Parallel Seq Scan on tickets: tres procesos (loops=3, el principal y dos workers) recorren toda la tablatickets. Cada uno descarta unas 122 000 filas (Rows Removed by Filter) para encontrar un solo billete.Index Scan on ticket_flights: para el billete encontrado, sus tramos de vuelo se leen mediante el índice de la clave primaria. Rápido: menos de 8 ms.Nested Looplos une yGatherreúne los resultados de los workers paralelos.
La consulta completa tarda 415 ms, y casi todo ese tiempo es del primer paso. El cuello de botella es el nodo con el mayor tiempo real y más filas descartadas. La solución es un índice sobre tickets (book_ref).
En PostgreSQL, rows y loops van juntos: un nodo informa las filas por ejecución, así que el total es rows × loops. rows=0.33 loops=3 significa una fila en total.
Antes y después de un índice
El mismo diagnóstico en una tabla de prueba orders con 200 000 filas (10 000 clientes, 20 pedidos cada uno):
EXPLAIN ANALYZE
SELECT id, amount, created_at
FROM orders
WHERE customer_id = 42;
Sin índice:
Seq Scan on orders  (cost=0.00..3774.00 rows=20 width=14) (actual time=0.030..19.330 rows=20.00 loops=1)
  Filter: (customer_id = 42)
  Rows Removed by Filter: 199980
Execution Time: 19.379 ms
Después de CREATE INDEX orders_customer_id_idx ON orders (customer_id);:
Bitmap Heap Scan on orders  (cost=4.45..77.18 rows=20 width=14) (actual time=0.142..0.188 rows=20.00 loops=1)
  Recheck Cond: (customer_id = 42)
  ->  Bitmap Index Scan on orders_customer_id_idx  (cost=0.00..4.45 rows=20 width=0) (actual time=0.120..0.120 rows=20.00 loops=1)
        Index Cond: (customer_id = 42)
Execution Time: 0.293 ms
Las 199 980 filas descartadas pasaron a cero, y la consulta es unas 65 veces más rápida. Ahora escribe la condición como customer_id + 0 = 42: el plan vuelve a Parallel Seq Scan y la estimación pasa a rows=1000 en lugar de 20, porque el optimizador no tiene estadísticas de la expresión.
Métodos de unión
Un plan con varias tablas muestra cómo se unen:
- Nested Loop: para cada fila de la entrada externa, busca las filas correspondientes en la interna. Rápido cuando la entrada externa es pequeña y la interna tiene un índice en la columna de unión, como en todos los ejemplos anteriores.
- Hash Join: construye una tabla hash con la entrada más pequeña y pasa la más grande por ella. Bueno para entradas grandes sin un índice útil.
- Merge Join: ambas entradas se ordenan por la clave de unión y se mezclan. Bueno cuando los datos ya están ordenados, por ejemplo leídos de índices.
MySQL usa sobre todo nested loops y, desde la 8.0.18, hash joins; PostgreSQL y SQL Server usan los tres.
Señales de alarma en un plan
| Señal | Qué suele significar | Qué probar |
|---|---|---|
type = ALL / Seq Scan en una tabla grande con una condición selectiva | no hay un índice adecuado | un índice en la columna del WHERE o del JOIN |
key = NULL aunque existe un índice | la condición no es SARGable: función, expresión, LIKE '%...', tipos distintos | reescribir la condición para dejar la columna "desnuda" |
un Rows Removed by Filter grande | se leen muchas filas y se descartan | un índice o un índice compuesto que incluya el filtro |
rows estimado muy distinto del real | estadísticas desactualizadas o ausentes | ANALYZE TABLE (MySQL), ANALYZE (PostgreSQL) |
Using temporary; Using filesort, Sort con external merge | agrupación u ordenación de un resultado grande, quizá en disco | un índice en el orden necesario, menos filas antes de ordenar |
un nested loop con un loops grande sobre un recorrido completo | el lado interno se busca sin índice | un índice en la columna de unión del lado interno |
Mira el plan en conjunto. El objetivo no es eliminar cada recorrido completo, sino encontrar el paso en el que se va la mayor parte del tiempo.
Usar EXPLAIN ANALYZE con seguridad
EXPLAIN ANALYZE ejecuta la consulta de verdad. Para un SELECT solo cuesta tiempo, pero EXPLAIN ANALYZE UPDATE ... o DELETE ... modifica los datos. En PostgreSQL, haz esa comprobación dentro de una transacción:
BEGIN;
EXPLAIN ANALYZE
UPDATE orders SET amount = amount * 1.1 WHERE customer_id = 42;
ROLLBACK;
Recuerda también que la primera ejecución puede leer los datos del disco y las siguientes, de la memoria. Compara planes y tiempos tras varias ejecuciones y con datos de un volumen parecido al de producción: en una tabla de 100 filas casi cualquier plan es rápido.
Ideas clave de la lección:
EXPLAINmuestra el plan que eligió el optimizador;EXPLAIN ANALYZEejecuta la consulta y añade el tiempo y las filas reales.- En MySQL empieza por
type,key,rowsyExtra;ALLykey = NULLen una tabla grande son los primeros sospechosos. - Los árboles de plan se leen de dentro hacia fuera: los pasos anidados se ejecutan primero y pasan las filas hacia arriba.
- El cuello de botella es el paso con el mayor tiempo real y más filas descartadas.
- Una gran diferencia entre filas estimadas y reales indica estadísticas desactualizadas.
- Una función o expresión sobre una columna indexada suele convertir la búsqueda por índice en un recorrido completo.
EXPLAIN ANALYZEdeUPDATEoDELETEmodifica los datos: ejecútalo en una transacción y deshazla con rollback.
Preguntas frecuentes
¿Qué diferencia hay entre EXPLAIN y EXPLAIN ANALYZE?
EXPLAIN solo muestra el plan con las estimaciones del optimizador y no ejecuta la consulta. EXPLAIN ANALYZE ejecuta la consulta y muestra el tiempo, las filas y las ejecuciones reales de cada paso, para comparar las estimaciones con la realidad.
¿Un recorrido completo de la tabla siempre es malo?
No. El recorrido completo es la mejor opción para tablas pequeñas y para consultas que devuelven gran parte de la tabla: leer las filas seguidas es más barato que ir y venir entre el índice y la tabla. El problema es recorrer una tabla grande para encontrar unas pocas filas.
¿Por qué la base de datos no usa mi índice?
Motivos habituales: la columna está dentro de una función o expresión, el LIKE empieza por %, los tipos de los valores comparados no coinciden, la condición abarca gran parte de las filas o las estadísticas están desactualizadas. El plan muestra cuál es el caso.
¿Qué significa cost en un plan?
Cost es la estimación del trabajo que hace el optimizador, en unidades abstractas (lecturas de páginas y operaciones de CPU), no en milisegundos. Sirve para comparar planes de la misma consulta; el tiempo real lo da EXPLAIN ANALYZE.
Preguntas de entrevista
¿Cómo averiguas por qué una consulta es lenta?
Ejecuto EXPLAIN ANALYZE (o miro el plan de ejecución real) y busco el paso con más tiempo y más filas leídas y descartadas. Después compruebo si usa un índice, si la condición es SARGable y si las filas estimadas coinciden con las reales.
¿Qué significan los tipos de acceso ALL, index, range y ref en MySQL?
ALL lee toda la tabla; index lee todo el índice; range lee un rango del índice para BETWEEN, > o IN; ref encuentra filas por un valor del índice. const y eq_ref encuentran como mucho una fila por una clave única.
El optimizador esperaba 10 filas y obtuvo 100 000. ¿Qué haces?
El plan se construyó con estimaciones erróneas, así que el método o el orden de las uniones pueden ser incorrectos. Actualizo las estadísticas (ANALYZE), compruebo que la condición no esconda la columna en una expresión y vuelvo a comparar el plan. Si los datos están desequilibrados, pueden ayudar las estadísticas extendidas o una consulta reescrita.