Cómo funcionan los índices B-tree
Lección 10.5 · Tiempo de lectura: ~11 min · Tareas de práctica ↓
Esta lección explica en detalle cómo funcionan los índices B-tree en SQL a nivel físico y lógico. Aprenderás de qué nodos se compone la estructura, cómo recorre el árbol la base de datos y por qué este enfoque acelera el filtrado y la ordenación. Veremos ejemplos prácticos con las tablas de Sakila y repasaremos las reglas clave de uso. Al terminar, entenderás mejor cuándo un índice B-tree acelera de verdad las consultas.
En las lecciones anteriores aprendiste a crear índices y a comprobar en el plan de ejecución que una consulta los usa. Ahora veamos cómo está organizado un índice por dentro y por qué acelera la búsqueda.
Entender el B-tree te ayudará a ver cuándo un índice funciona de verdad y cuándo no se puede usar. Este conocimiento te será útil al optimizar consultas lentas.
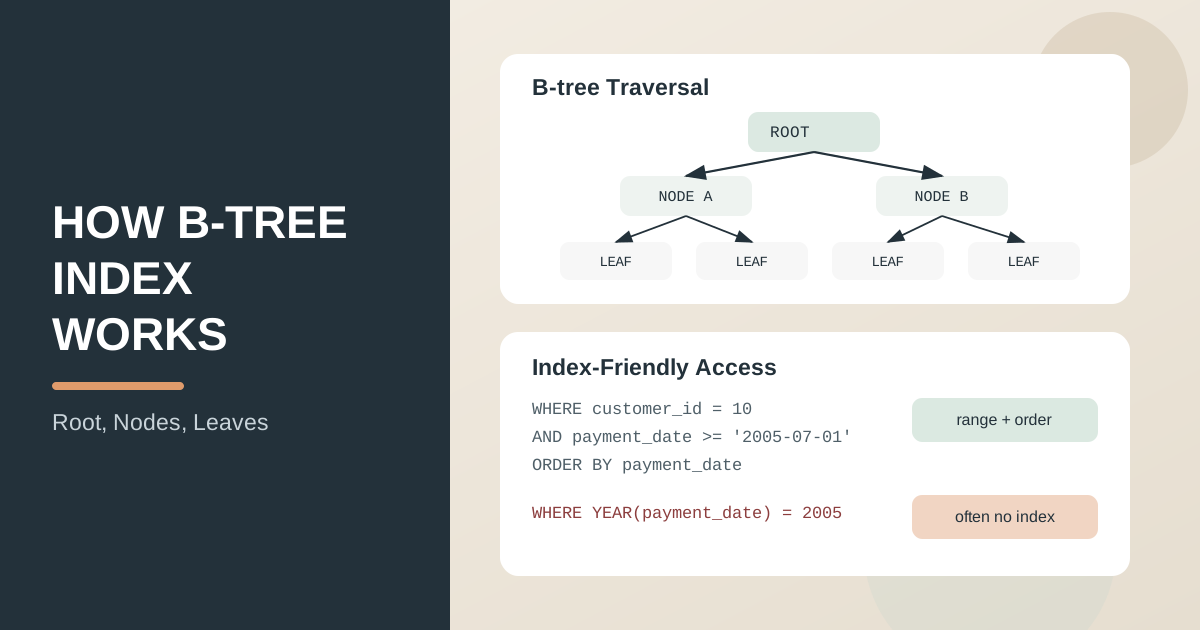
Qué es un índice B-tree
Un índice B-tree es como el índice de un libro. En lugar de leer todas las páginas en orden, abres el índice, encuentras el capítulo que necesitas y vas directamente a él.
Un B-tree tiene tres niveles:
- nodo raíz: el punto de partida de la búsqueda, como la portada del índice;
- nodos intermedios: indican hacia dónde seguir;
- nodos hoja: contienen los valores buscados y los enlaces a las filas de la tabla.
Toda la estructura está ordenada, así que la base de datos puede elegir rápidamente la dirección correcta en cada nivel.
Este es su aspecto:
                    [ ROOT ]
                   /   |   \
                  /    |    \
            [NODE A] [NODE B] [NODE C]
            / |  \    / | \    / | \
           /  |   \  /  |  \  /  |  \
         [L1][L2][L3][L4][L5][L6][L7][L8]
Cada nodo contiene valores que ayudan a elegir el siguiente nodo. Los nodos hoja (L1–L8) contienen los datos que necesitas.
Cómo funciona la búsqueda en un B-tree
Cuando buscas WHERE last_name = 'SMITH', la base de datos:
- empieza por el nodo raíz;
- elige la rama en la que pueden estar los apellidos que empiezan por 'S';
- desciende y afina la búsqueda en cada nivel;
- encuentra el apellido buscado en un nodo hoja.
Gracias a este algoritmo la búsqueda es muy rápida: incluso en una tabla con millones de filas, solo hay que revisar unos pocos niveles.
Qué operaciones acelera mejor un B-tree
Igualdad (=)
El B-tree es muy adecuado para buscar valores exactos.
SELECT
   customer_id,
   first_name,
   last_name
FROM customer
WHERE last_name = 'SMITH';
Rangos (>, <, BETWEEN)
Como las claves están ordenadas, el B-tree es eficiente con las condiciones de rango.
SELECT
   payment_id,
   amount,
   payment_date
FROM payment
WHERE payment_date >= '2005-07-01'
  AND payment_date < '2005-08-01';
Ordenación (ORDER BY)
Si el orden pedido coincide con el del índice, la base de datos a menudo puede evitar una ordenación aparte y costosa.
SELECT
   payment_id,
   customer_id,
   payment_date
FROM payment
WHERE customer_id = 10
ORDER BY payment_date;
Ejemplo de índice B-tree compuesto
Creemos un índice para un patrón habitual de filtrado y ordenación:
CREATE INDEX idx_payment_customer_date
ON payment (customer_id, payment_date);
Comprobemos el plan:
EXPLAIN
SELECT
   payment_id,
   customer_id,
   payment_date,
   amount
FROM payment
WHERE customer_id = 10
  AND payment_date >= '2005-07-01'
ORDER BY payment_date;
Resultado: normalmente la base de datos usa el índice para filtrar por customer_id y por el rango de payment_date, y también para leer las filas ya ordenadas.
La regla del prefijo izquierdo en los índices compuestos
Si un índice se crea como (customer_id, payment_date), la base de datos lo aprovecha mejor cuando la condición filtra primero por customer_id.
Funciona bien:
WHERE customer_id = 10
Funciona bien:
WHERE customer_id = 10 AND payment_date >= '2005-01-01'
Funciona mal:
WHERE payment_date >= '2005-01-01'
Esta regla se llama del "prefijo izquierdo": el índice funciona mejor cuando usas las condiciones de izquierda a derecha.
Cuándo no ayuda un índice
Un índice no se usa si:
- aplicas una función a la columna:
WHERE YEAR(payment_date) = 2005, y el índice no funciona; - usas un comodín al principio:
WHERE name LIKE '%SMITH', y el índice no ayuda; - la condición es demasiado general y devuelve muchas filas: el índice puede ser más lento que leer la tabla entera.
Mal (la función impide usar el índice):
SELECT payment_id, payment_date
FROM payment
WHERE YEAR(payment_date) = 2005;
Bien (el índice puede funcionar):
SELECT payment_id, payment_date
FROM payment
WHERE payment_date >= '2005-01-01'
  AND payment_date < '2006-01-01';
Recomendaciones prácticas
- Indexa los campos que aparecen con frecuencia en
WHERE,JOINyORDER BY. - En los índices compuestos, pon primero la columna más importante para el filtrado.
- Comprueba el uso real de los índices con
EXPLAIN. - No crees índices redundantes: encarecen las escrituras.
Puntos clave de esta lección:
- El B-tree es una estructura equilibrada que acelera la búsqueda por clave.
- Su principal punto fuerte: igualdades, rangos y ordenación en el orden del índice.
- Los índices compuestos siguen la regla del prefijo izquierdo.
- Una forma inadecuada de escribir la condición puede privar a la consulta de las ventajas del índice.
EXPLAINayuda a ver si el B-tree se usa en el plan de ejecución real.
Preguntas frecuentes
¿Qué significa la B de B-tree?
Suele leerse como "balanced" (equilibrado): todas las hojas están a la misma distancia de la raíz, así que cualquier búsqueda requiere el mismo número de pasos. Rudolf Bayer y Edward McCreight, que describieron la estructura en 1972, nunca explicaron la letra. En la práctica, la mayoría de los SGBD usan la variante B+tree, cuyas hojas están enlazadas en una lista, lo que acelera las búsquedas por rango.
¿Qué diferencia hay entre un índice B-tree y un índice hash?
Un índice hash solo encuentra coincidencias exactas (=). Un B-tree además maneja rangos (>, <, BETWEEN), ORDER BY y búsquedas por prefijo como LIKE 'SM%', porque sus claves están ordenadas. Por eso B-tree es el tipo de índice por defecto en MySQL (InnoDB) y PostgreSQL.
¿Cuántos niveles tiene un índice B-tree?
Normalmente tres o cuatro, incluso con millones de filas. Cada nodo es una página de disco (16 KB en InnoDB, 8 KB en PostgreSQL) que contiene cientos de claves, así que cada nivel multiplica por cientos el número de filas alcanzables. Encontrar una fila solo requiere unas pocas lecturas de página.
Preguntas de entrevista
¿Por qué un índice B-tree suele ser más rápido que un recorrido completo?
Porque la base de datos recorre el árbol por sus ramas y encuentra el rango necesario en un número logarítmico de pasos, en lugar de revisar todas las filas de la tabla.
¿Qué es la regla del prefijo izquierdo en un índice compuesto?
Significa que el optimizador aprovecha mejor el índice cuando las condiciones empiezan por la primera columna de la clave y siguen en orden.
¿Cómo compruebas en la práctica que se usa un índice B-tree?
Ejecutas EXPLAIN y miras el tipo de acceso, la clave elegida y el número esperado de filas en cada etapa de la ejecución.