Algoritmos de join en SQL: cómo ejecuta los joins la base de datos
Lección 5.9 · Tiempo de lectura: ~9 min · Tareas de práctica ↓
Los algoritmos de join en SQL son los métodos que usa una base de datos para ejecutar un join: nested loop join, hash join y merge join. En esta lección aprenderás cómo funciona cada algoritmo, cuándo lo elige el planificador de consultas, qué bases de datos admiten cuáles y cómo ver el elegido con EXPLAIN.
En las lecciones anteriores escribiste joins pensando en qué filas devuelven. El mismo join se puede ejecutar de maneras muy distintas, y en tablas grandes la diferencia entre ellas es de segundos contra horas. El algoritmo no se elige en SQL: lo elige el planificador de consultas. Pero saber cómo funcionan los algoritmos explica por qué importan los índices en las columnas de join y cómo leer los planes de ejecución.
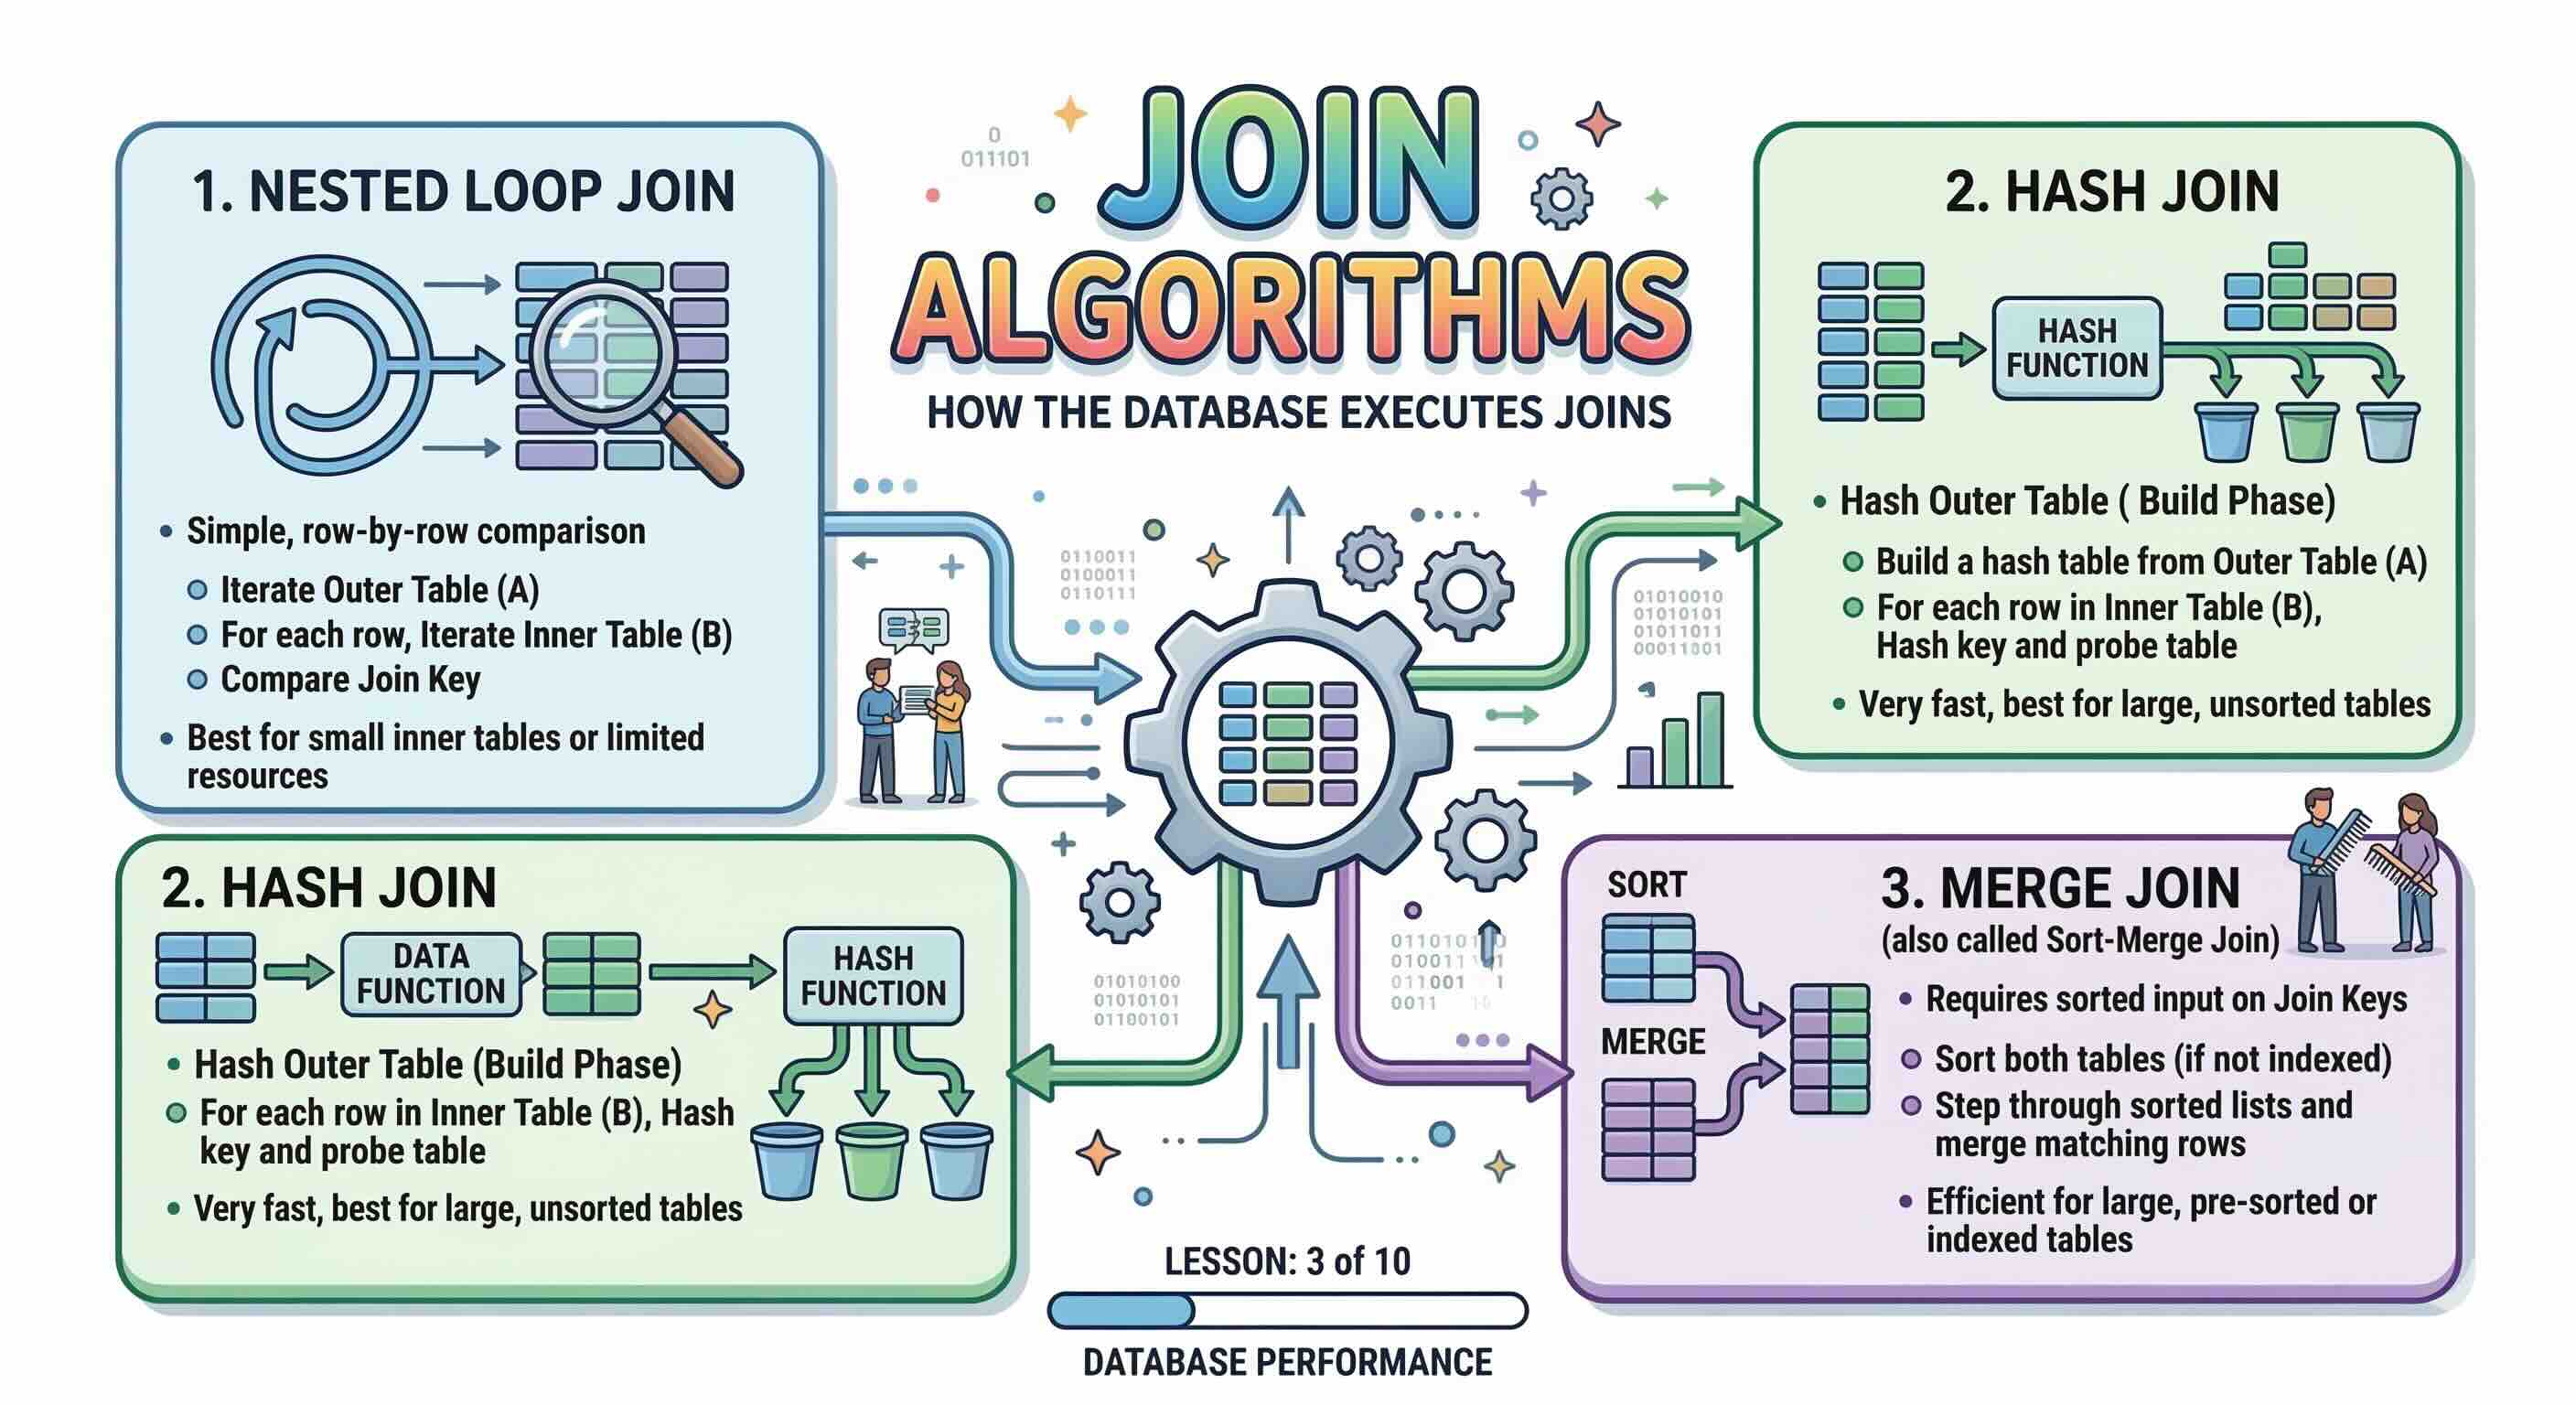
Nested Loop Join
Cómo funciona
La base de datos toma una tabla como externa (conductora) y, para cada una de sus filas, busca coincidencias en la tabla interna: dos bucles anidados.
for each row R1 in outer_table:
    for each row R2 in inner_table:
        if R1.key = R2.key:
            output(R1, R2)
Sin índice, la tabla interna se recorre entera para cada fila externa: N × M comparaciones. Con un índice en la columna de join de la tabla interna, cada búsqueda se convierte en una búsqueda rápida en el índice. Este index nested loop join es uno de los planes más eficientes cuando el lado externo es chico.
Cuándo lo usa el planificador
- La tabla externa, o el lado externo después del filtro, es chica.
- La tabla interna tiene un índice en la columna de join.
- La condición de join no es una igualdad (
<,>,BETWEEN): los hash y merge joins clásicos solo funcionan con igualdad.
| Ventajas | Desventajas |
|---|---|
| Funciona con cualquier condición de join | Muy lento en tablas grandes sin índice: N × M |
| Muy rápido con un lado externo chico y un índice | El costo crece rápido con el tamaño de ambas tablas |
| Poca memoria; devuelve las primeras filas enseguida |
Hash Join
Cómo funciona
Un hash join tiene dos fases:
- Construcción (build): la base de datos lee la entrada más chica y construye en memoria una tabla hash por la columna de join.
- Sondeo (probe): lee la entrada más grande y busca la clave de cada fila en la tabla hash.
-- build
for each row R1 in smaller_input:
    hash_table[hash(R1.key)].append(R1)

-- probe
for each row R2 in larger_input:
    for each R1 in hash_table[hash(R2.key)]:
        if R1.key = R2.key:
            output(R1, R2)
Cada entrada se lee una vez, así que el costo es de alrededor de N + M: mucho mejor que un nested loop sin índices.
Cuándo lo usa el planificador
- Dos entradas grandes unidas por igualdad.
- No hay un índice útil en las columnas de join.
- Hay memoria suficiente para la tabla hash (
work_memen PostgreSQL,join_buffer_sizeen MySQL).
| Ventajas | Desventajas |
|---|---|
Eficiente para joins grandes sin índices: N + M | El hash join clásico necesita una condición de igualdad |
| No necesita índices ni entrada ordenada | Usa memoria; si la tabla hash no entra, pasa al disco |
| Tiene que construir la tabla hash antes de devolver la primera fila |
Merge Join
Cómo funciona
Un merge join (sort-merge join) necesita que ambas entradas estén ordenadas por la columna de join. Luego recorre las dos listas ordenadas al mismo tiempo, como el paso de mezcla del merge sort:
sort outer by key   -- skipped if read through an ordered index
sort inner by key   -- skipped if read through an ordered index

while neither input is exhausted:
    if outer.key = inner.key: output matches, advance
    elif outer.key < inner.key: advance outer
    else: advance inner
Si ambas entradas se pueden leer en orden mediante índices, el ordenamiento no cuesta nada y la mezcla es muy rápida.
Cuándo lo usa el planificador
- Entradas grandes unidas por igualdad.
- Ambas entradas ya están ordenadas o se pueden leer mediante índices ordenados.
- La consulta igual ordena por la columna de join (
ORDER BY,GROUP BY,DISTINCT).
| Ventajas | Desventajas |
|---|---|
| Muy rápido con entrada ordenada de antemano o indexada | Solo condiciones de igualdad |
| El resultado ya sale ordenado por la clave de join | Ordenar explícitamente una entrada desordenada es caro |
| Uso de memoria predecible |
Qué base de datos usa qué algoritmo
| Base de datos | Nested loop | Hash join | Merge join |
|---|---|---|---|
| PostgreSQL | Sí | Sí | Sí |
| SQL Server, Oracle | Sí | Sí | Sí |
| MySQL 8.0.18+ | Sí | Sí (reemplazó al Block Nested Loop en 8.0.20) | No |
| MariaDB | Sí (incl. block nested loop, BKA) | Sí (block hash join) | No |
| SQLite | Sí | No | No |
En MySQL, el hash join también se usa en joins sin condición de igualdad y en productos cartesianos, así que la regla "solo igualdad" se aplica al algoritmo clásico y no a todas las implementaciones.
Ver el algoritmo en EXPLAIN
EXPLAIN muestra el plan que eligió la base de datos; EXPLAIN ANALYZE (MySQL 8.0.18+, PostgreSQL) además ejecuta la consulta e informa el tiempo real de cada paso:
EXPLAIN ANALYZE
SELECT a.first_name, a.last_name, f.title
FROM actor AS a
INNER JOIN film_actor AS fa ON fa.actor_id = a.actor_id
INNER JOIN film AS f ON f.film_id = fa.film_id;
Resultado: el plan de ejecución en forma de árbol. En MySQL busca Nested loop inner join o Inner hash join; en PostgreSQL, Nested Loop, Hash Join o Merge Join.
Aquí MySQL usa bucles anidados: film_actor y film tienen índices en las columnas de join, así que cada búsqueda es una búsqueda en un índice.
Cómo ayudar al planificador
- Indexa las columnas de claves foráneas que se usan en joins: eso habilita el index nested loop.
- Filtra temprano: un
WHEREselectivo achica el lado externo. - Mantén las estadísticas al día (
ANALYZE TABLEen MySQL,ANALYZEen PostgreSQL): el planificador elige según estimaciones de cantidad de filas. - Revisa la configuración de memoria si un hash join pasa al disco con muchos datos.
Conclusiones clave:
- Nested loop join busca en la tabla interna para cada fila externa; es rápido con un lado externo chico y un índice, y funciona con cualquier condición.
- Hash join construye una tabla hash con la entrada más chica y la sondea; es eficiente para joins grandes por igualdad sin índices, pero usa memoria.
- Merge join mezcla dos entradas ordenadas; ideal cuando los datos ya están ordenados por un índice.
- MySQL y MariaDB no tienen merge join; PostgreSQL, SQL Server y Oracle tienen los tres.
- Influyes en la elección con índices, filtros, estadísticas y configuración de memoria, y la verificas con
EXPLAIN ANALYZE.
Preguntas frecuentes
¿Cuál es la diferencia entre un nested loop join y un hash join?
Un nested loop join busca coincidencias en la tabla interna para cada fila externa, lo que es rápido cuando hay un índice y el lado externo es chico. Un hash join lee cada entrada una sola vez y empareja las filas mediante una tabla hash en memoria, lo que es más rápido para dos entradas grandes sin índices útiles.
¿MySQL admite hash join?
Sí, desde MySQL 8.0.18. Desde la 8.0.20 reemplaza al algoritmo block nested loop en los joins que no pueden usar un índice. MySQL no tiene merge join.
¿Puedo forzar un algoritmo de join concreto?
No en SQL estándar. Algunas bases de datos ofrecen sugerencias: las optimizer hints de MySQL como HASH_JOIN / NO_HASH_JOIN (según la versión), OPTION (HASH JOIN) en SQL Server, parámetros de PostgreSQL como enable_hashjoin. Úsalas para diagnosticar; en consultas de producción, la solución correcta suele ser mejorar los índices y las estadísticas.