Consultas SQL eficientes: cómo escribir SQL más rápido y ligero
Lección 10.2 · Tiempo de lectura: ~10 min · Tareas de práctica ↓
Esta lección presenta los fundamentos para escribir consultas SQL de alto rendimiento. Aprenderás a evitar la carga innecesaria en la base de datos, por qué SELECT * suele perjudicar el rendimiento y cómo filtrar los datos de forma eficaz. Veremos técnicas prácticas que hacen que las consultas se ejecuten más rápido, incluso con grandes volúmenes de datos. Al terminar, podrás escribir SQL eficiente que use los recursos del servidor de forma responsable.
En la lección anterior nos centramos en la legibilidad para las personas. Pero el SQL también debe ser legible y eficiente para el motor de la base de datos. Incluso un código perfectamente formateado puede rendir mal si obliga al servidor a hacer trabajo innecesario.
La eficiencia de las consultas influye directamente en la velocidad de las aplicaciones y de los informes. En sistemas con muchos datos o mucha carga, la diferencia entre "funciona" y "está optimizado" puede ser de minutos o incluso de horas de ejecución.
Los SGBD modernos tienen optimizadores potentes que pueden reescribir las consultas internamente. Aun así, un optimizador no lo puede todo: no conoce la intención de negocio y no siempre puede corregir decisiones de diseño ineficientes de raíz. La calidad del código sigue siendo responsabilidad del desarrollador.
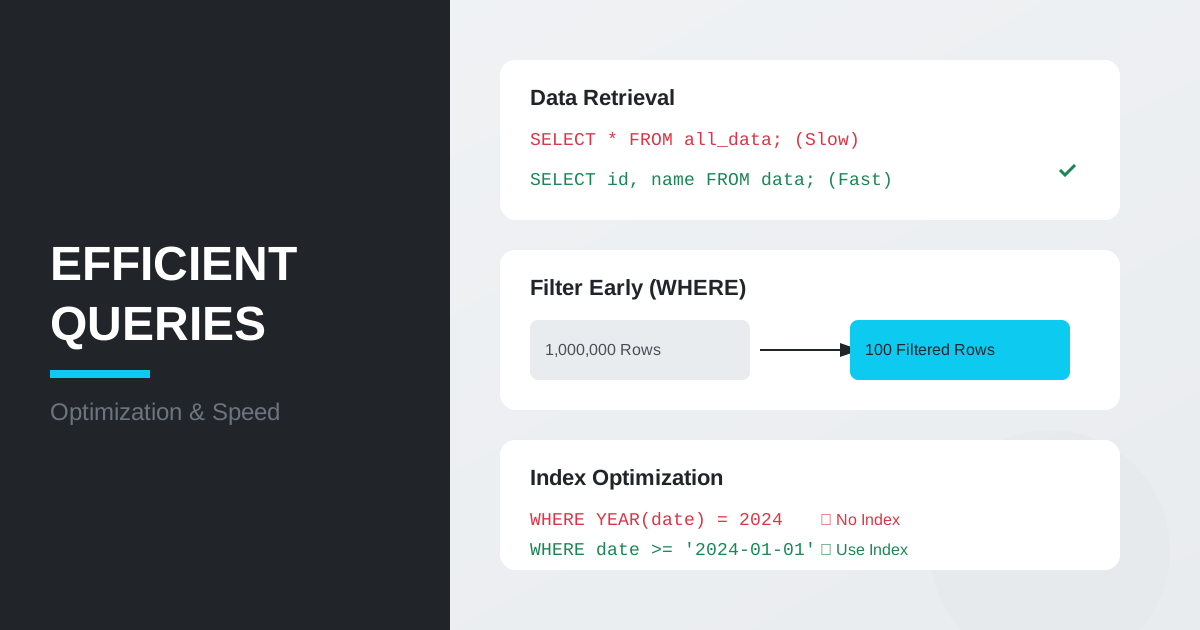
Regla de oro: obtén solo lo que necesitas
La causa más habitual de las consultas lentas es mover demasiados datos innecesarios entre el servidor de base de datos y el cliente.
Evita SELECT *
Aunque SELECT * es cómodo para explorar rápidamente, evítalo en el SQL de producción.
- Tráfico extra: transfieres columnas que no necesitas.
- Limitaciones de los índices: es más difícil aprovechar los índices de cobertura cuando se piden todas las columnas.
- Código frágil: añadir una columna nueva puede cambiar de forma inesperada el comportamiento y el rendimiento.
-- Poor
SELECT * FROM film;

-- Better
SELECT film_id, title, release_year
FROM film;
Optimizar el filtrado
La forma de limitar las filas determina cuántos datos tiene que recorrer y procesar el SGBD.
Filtra en el servidor
Aplica las condiciones WHERE lo antes posible, antes de agregaciones pesadas o de devolver los datos a los clientes. Cuanto antes reduzcas las filas, más rápidos serán los pasos posteriores (JOIN, GROUP BY).
Evita funciones en WHERE (consultas SARGable)
Para usar bien los índices, los predicados de WHERE deben ser SARGable (Search ARGumentable). Si envuelves una columna indexada en una función, el optimizador a menudo no puede usar el índice de forma eficiente y puede recorrer la tabla completa.
-- Slow (Non-SARGable: index on rental_date may not be used)
SELECT count(*)
FROM rental
WHERE YEAR(rental_date) = 2005;

-- Fast (SARGable: index can be used)
SELECT count(*)
FROM rental
WHERE rental_date >= '2005-01-01' AND rental_date < '2006-01-01';
Trabajar con JOIN
Unir tablas es una de las operaciones que más recursos consumen en una consulta.
- Primero filtra, después une: reduce el número de filas de las tablas relacionadas antes de unirlas.
- Comprueba los índices de las claves de unión: normalmente las claves primarias y foráneas.
- Evita los
CROSS JOINinnecesarios: los productos cartesianos crecen muy rápido. - Usa
EXISTSpara comprobar la existencia: si solo necesitas saber si existen filas relacionadas,EXISTSsuele ser más barato queJOIN.
-- Less efficient (JOIN forces matching through all payments)
SELECT DISTINCT c.first_name, c.last_name
FROM customer c
JOIN payment p ON c.customer_id = p.customer_id;

-- More efficient (EXISTS can stop on first match)
SELECT c.first_name, c.last_name
FROM customer c
WHERE EXISTS (
    SELECT 1 FROM payment p WHERE p.customer_id = c.customer_id
);
Usa LIMIT mientras pruebas
Al depurar una consulta, usa siempre LIMIT para no devolver por accidente millones de filas.
SELECT customer_id, first_name, last_name
FROM customer
WHERE active = 1
LIMIT 10;
Ejemplo práctico: optimizar un informe
Supongamos que necesitamos las películas alquiladas más de 30 veces dentro de una categoría.
Enfoque menos eficiente:
SELECT f.title, COUNT(r.rental_id)
FROM film f
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
JOIN film_category fc ON f.film_id = fc.film_id
JOIN category c ON fc.category_id = c.category_id
WHERE c.name = 'Action'
GROUP BY f.title
HAVING COUNT(r.rental_id) > 30;
Enfoque más eficiente: Si conocemos el ID de la categoría, podemos evitar la unión para buscarla por su nombre.
SELECT f.title, COUNT(r.rental_id) AS rental_count
FROM film f
JOIN film_category fc ON f.film_id = fc.film_id
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
WHERE fc.category_id = 1 -- Use ID instead of string lookup
GROUP BY f.film_id, f.title
HAVING COUNT(r.rental_id) > 30;
Nota: filtrar por ID numéricos suele ser más rápido que filtrar por nombres de texto y a menudo permite hacer menos uniones.
Puntos clave de esta lección:
- Evita
SELECT *en las consultas de producción; enumera solo las columnas necesarias. - Filtra lo antes posible con
WHERE. - Escribe predicados SARGable para que se puedan usar los índices.
- Prefiere
EXISTSaJOINcuando solo necesites comprobar la existencia. - Usa
LIMITal explorar y depurar. - Prefiere filtrar por claves numéricas en lugar de por etiquetas de texto.
Preguntas frecuentes
¿Por qué SELECT * es perjudicial en las consultas de producción?
Devuelve columnas innecesarias, aumenta el tráfico y puede impedir planes que aprovechen los índices. Las listas de columnas explícitas suelen ser más rápidas y seguras.
¿Qué significa SARGable en la práctica?
Un predicado SARGable permite buscar mediante un índice. Envolver columnas indexadas en funciones suele impedir un uso eficiente del índice.
¿Cuándo usar EXISTS en lugar de JOIN?
Usa EXISTS cuando solo necesites saber si existen filas relacionadas y no necesites columnas de la segunda tabla.
Preguntas de entrevista
¿Cuáles son tus primeros pasos cuando una consulta SQL es lenta?
Compruebo si usa SELECT *, reviso la selectividad de WHERE e identifico los predicados que no son SARGable. Después reviso la estrategia de unión y el volumen de filas en las primeras etapas de la consulta.
¿Por qué filtrar pronto mejora el rendimiento?
Reduce el número de filas que intervienen en las uniones, la ordenación y la agregación, y así baja el coste total del plan.
¿En qué se diferencian JOIN y EXISTS en cuanto a rendimiento?
JOIN combina conjuntos de filas y es necesario cuando necesitas columnas de las dos tablas. EXISTS suele ser más rápido para comprobaciones de existencia de tipo sí/no, porque puede detenerse en la primera coincidencia.