数据库类型:关系型、NoSQL 及其他
第 1.2 课 · 阅读时间:约 15 分钟 · 练习题 ↓
数据库类型有很多种,每一种都针对特定的数据、查询模式或扩展需求做了优化。在本课中,你将了解主要的数据库模型:关系型、键值、文档、宽列、图、时序和列式,以及它们的主要区别、典型用途和真实系统的例子。
在上一课中,我们介绍了数据库和 DBMS 的基本概念。实际上,并不是所有数据库都以相同的方式构建。不同类型的数据库针对不同的数据、查询模式、扩展需求和一致性要求做了优化。
我们还会进一步了解关系数据库,因为它将是整个课程的重点。
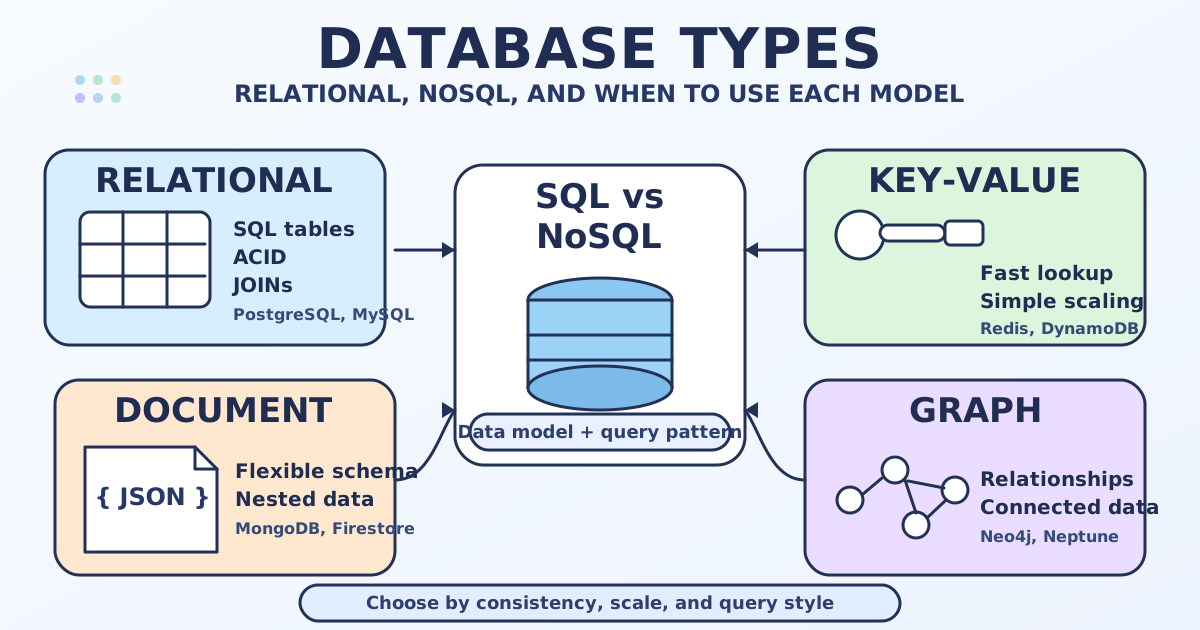
为什么会有不同类型的数据库?
没有一种数据库设计能完美适用于所有应用。
例如:
- 银行系统需要强一致性和可靠的事务。
- 缓存系统需要极快的按键查找。
- 社交网络可能需要灵活的文档存储和图式的关系分析。
- 分析平台可能需要为报表高效扫描数十亿个值。
由于不同的系统解决不同的问题,随着时间推移出现了多种数据库模型。
主要数据库类型对比表
在详细了解每种类型之前,先做一个快速对比:
| 类型 | 数据模型 | 优势 | 常见用途 | 示例 |
|---|---|---|---|---|
| 关系型 | 由行和列组成的表 | 强一致性、SQL、连接、结构化数据 | 银行、ERP、CRM、电商、报表 | PostgreSQL, MySQL, MariaDB, SQLite, Oracle |
| 键值 | 键与值成对存储 | 查找极快,扩展简单 | 缓存、会话、功能开关、购物车 | Redis, Amazon DynamoDB, Riak |
| 文档 | 类似 JSON 的文档 | 模式灵活,支持嵌套数据 | 内容管理、用户档案、商品目录、Web 应用 | MongoDB, Couchbase, Firestore |
| 宽列 | 行中包含按列族分组的灵活列 | 写入吞吐量高,可水平扩展 | 事件日志、物联网、大规模分布式负载 | Apache Cassandra, HBase, ScyllaDB |
| 图 | 节点和边 | 擅长以关系为中心的查询 | 社交网络、欺诈检测、推荐引擎 | Neo4j, Amazon Neptune, ArangoDB |
| 时序 | 带时间戳的记录 | 高效写入并按时间聚合 | 监控、指标、传感器、金融行情 | InfluxDB, TimescaleDB, OpenTSDB |
| 列式分析 | 数据按列而不是按行存储 | 分析扫描和聚合速度快 | BI、看板、数据仓库、OLAP | ClickHouse, DuckDB, Amazon Redshift, BigQuery |
| 内存 | 数据主要存放在内存中 | 延迟极低 | 缓存、排行榜、实时计数器 | Redis, Memcached, SAP HANA |
关系数据库
关系数据库把数据存放在由行和列组成的表中。表与表之间可以通过关系相连,通常使用主键和外键。
当数据结构清晰,并且正确性、一致性和复杂查询很重要时,这种模型尤其合适。
关系数据库的核心特性
1. 结构化模式
关系数据库通常要求明确定义的模式。在存储数据之前,你需要定义表、列、数据类型、约束和关系。
这样结构就是可预期的,也更容易校验。
2. 表之间的关系
关系型系统的一大优势是能够显式地建模关系。
例如:
customers表可以与orders表关联。orders表可以与order_items表关联。
因此,关系数据库非常适合实体之间相互关联的业务系统。
3. 支持 SQL
关系数据库通常使用 SQL(结构化查询语言) 进行查询。SQL 提供了一种标准方式来过滤、连接、聚合、排序和修改结构化数据。
4. ACID 事务
关系数据库以支持 ACID 特性而著称:
- 原子性: 事务要么完全成功,要么完全失败。
- 一致性: 数据必须始终符合定义的规则。
- 隔离性: 并发事务之间不应发生错误的相互干扰。
- 持久性: 数据一旦提交,即使发生故障也会保留。
这些特性对银行、计费、预订和库存管理等系统至关重要。
5. 数据完整性约束
关系数据库可以直接在数据库层强制执行规则,例如:
- 主键
- 外键
- 唯一约束
NOT NULL约束- 检查约束
这些功能有助于防止出现无效或不一致的数据。
6. 强大的连接与报表能力
当需要组合多张表的信息时,关系数据库表现出色。这也是它在报表、分析、财务、运营和众多事务型系统中始终处于核心地位的原因之一。
7. 规范化与减少冗余
关系设计通常采用规范化,即把数据组织到相互关联的表中,以减少重复并提高一致性。
例如,客户信息可以只在 customers 表中存储一次,而不必在每条订单记录中重复。
关系数据库的常见用途
在以下情况下,关系数据库通常是最佳选择:
- 数据结构化且定义明确
- 实体之间的关系很重要
- 事务必须可靠
- 一致性比模式灵活性更重要
- 应用需要复杂的查询和报表
关系数据库示例
- PostgreSQL: 功能强大的开源关系数据库,对标准支持良好,并具备高级功能。
- MySQL: 流行的关系数据库,广泛用于 Web 应用。
- MariaDB: 由社区开发的 MySQL 分支。
- SQLite: 轻量级嵌入式关系数据库,数据存放在单个文件中。
- Oracle Database: 企业级关系数据库。
- Microsoft SQL Server: 在企业环境中广泛使用的关系数据库。
键值数据库
键值数据库以简单的一对形式存储数据:一个键及其对应的值。
键相当于唯一标识符,数据库直接根据键取出值。这种模型非常简单,也非常快。
主要区别
- 数据访问通常基于单个键,而不是复杂的连接。
- 数据库通常并不了解值的内部结构。
- 针对极快的读写做了优化。
典型用途
- 缓存查询结果
- 存储用户会话
- 购物车
- 功能开关
- 限流
- 排行榜和计数器
示例
- Redis
- Amazon DynamoDB
- Riak
文档数据库
文档数据库把数据存储为文档,通常采用类似 JSON 的格式。每个文档可以包含字段、数组和嵌套对象。
与关系数据库不同,并不是每个文档都必须具有完全相同的结构。
主要区别
- 模式灵活或半灵活。
- 相关数据通常可以一起存放在一个文档中。
- 适合结构经常变化的应用。
典型用途
- 内容管理系统
- 商品目录
- 用户档案
- 移动和 Web 应用
- 需求不断变化的原型系统
示例
- MongoDB
- Couchbase
- Google Firestore
宽列数据库
宽列数据库,有时也称为列族数据库,以行的形式存储数据,但每一行都可以拥有非常多且灵活的列。它们的设计目标是分布到多台服务器上并支持高写入吞吐量。
主要区别
- 模式比关系数据库更灵活。
- 针对大规模分布式存储做了优化。
- 能很好地处理海量数据集和繁重的写入负载。
- 通常不像 SQL 数据库那样支持关系型连接。
典型用途
- 事件日志
- 物联网遥测
- 消息系统
- 写入密集型应用
- 地理分布式系统
示例
- Apache Cassandra
- Apache HBase
- ScyllaDB
列式分析数据库
列式数据库在磁盘上把同一列的值存放在一起,而不是把整行存放在一起。这与宽列数据库不同。
对于只从超大数据集中读取少数几列的分析查询,列式存储尤其高效。
主要区别
- 针对扫描和聚合大量数据做了优化。
- 用于报表和分析时非常高效。
- 通常不太适合包含大量小规模行更新的繁重事务型负载。
典型用途
- 商业智能
- 看板
- 数据仓库
- 分析报表
- 大规模日志分析
示例
- ClickHouse
- DuckDB
- Amazon Redshift
- Google BigQuery
图数据库
图数据库专为关系是模型中最重要部分的数据而设计。它们存储节点(实体)和边(关系)。
主要区别
- 遍历关系既快速又自然。
- 非常适合查询路径、网络和相互连接的数据。
- 对于需要跨越多层关系的查询,往往比关系数据库更合适。
典型用途
- 社交网络
- 欺诈检测
- 推荐系统
- 网络拓扑
- 知识图谱
示例
- Neo4j
- Amazon Neptune
- ArangoDB
时序数据库
时序数据库专门处理与时间相关联的数据点。它们针对高速写入、数据保留策略、压缩和按时间聚合做了优化。
主要区别
- 每条记录都与一个时间戳相关联。
- 查询通常关注某个时间范围,例如最近一小时、一天或一个月。
- 能够高效地按时间窗口聚合。
典型用途
- 服务器监控
- 应用指标
- 传感器数据
- 股市数据
- 工业测量
示例
- InfluxDB
- TimescaleDB
- OpenTSDB
内存数据库
内存数据库把大部分或全部数据存放在内存而不是磁盘中。这使它们速度极快,但内存比磁盘存储更昂贵。
有些内存数据库只用作临时缓存,另一些则也能把数据持久化到磁盘。
典型用途
- 缓存
- 会话存储
- 实时计数器
- 游戏排行榜
- 超低延迟系统
示例
- Redis
- Memcached
- SAP HANA
如何选择合适的数据库类型
选择数据库时,可以问自己这样一些问题:
- 数据是高度结构化的,还是灵活的?
- 我需要严格的 ACID 事务吗?
- 我会执行复杂的连接吗?
- 低延迟的按键查找是首要任务吗?
- 负载是事务型的还是分析型的?
- 系统需要扩展到很多台服务器吗?
- 实体之间的关系是应用的核心吗?
在许多真实系统中,企业会同时使用不止一种数据库。例如:
- 用关系数据库存放核心业务数据
- 用 Redis 做缓存
- 用文档数据库存放灵活的内容
- 用列式数据仓库做分析
这通常被称为多语言持久化(polyglot persistence)。
总结:各类数据库的主要区别
不同数据库类型之间的主要区别通常在于:
- 数据模型:表、文档、键值对、图或带时间戳的记录
- 模式灵活性:固定结构还是灵活结构
- 查询方式:SQL、按键查找、文档查询、图遍历、时间窗口分析
- 一致性模型:强事务保证,还是以扩展性为导向的取舍
- 性能特点:针对事务、分析、关系还是超快速访问做了优化
要点:
- 之所以存在不同类型的数据库,是因为不同应用有不同的技术和业务需求。
- 关系数据库以结构化模式、SQL、关系、完整性约束和 ACID 事务而著称。
- 键值数据库非常适合快速查找和缓存。
- 文档数据库适用于数据结构灵活或经常变化的场景。
- 宽列数据库为分布式、大规模、写入密集型负载而构建。
- 列式分析数据库针对报表和大规模分析做了优化。
- 图数据库非常适合关系密集的数据。
- 时序数据库专门处理基于时间的指标和事件。
- 许多现代系统同时使用多种数据库(多语言持久化)。
常见问题
关系数据库和 NoSQL 数据库有什么区别?
关系数据库使用基于表的固定模式,执行 ACID 事务,并通过 SQL 查询。NoSQL 是一个统称,涵盖键值、文档、宽列和图等模型:它们以牺牲部分一致性保证为代价,换取模式灵活性或水平扩展能力。两者没有绝对的优劣,正确的选择取决于你的数据和工作负载。
什么时候应该用文档数据库而不是关系数据库?
当数据天然具有嵌套、多变的结构(例如每种商品属性各不相同的商品目录),并且很少需要跨集合连接时,使用文档数据库。当数据结构化、实体之间相互关联,并且需要可靠的事务和复杂的多表查询时,使用关系数据库。
一个应用可以同时使用多种数据库吗?
可以,这被称为多语言持久化。这在生产系统中很常见:例如用 PostgreSQL 存放事务数据,用 Redis 做缓存,用 ClickHouse 做分析。每种数据库都用在它最擅长的地方。
面试问题
针对某个具体场景,你会选择哪种数据库,为什么?
从工作负载和约束出发:数据结构、一致性要求、查询模式、延迟目标和规模。例如,对 ACID 要求高的事务型系统选择关系数据库,对灵活的类 JSON 记录选择文档数据库,对带时间戳并有保留策略的指标选择时序数据库。
一种数据库相比另一种有哪些优缺点?
每种模型都是一种取舍。关系数据库提供强一致性、连接和成熟的 SQL 工具,但在大规模场景下修改模式可能更受限制。NoSQL 模型通常提供更好的灵活性或水平扩展能力,但可能会限制连接,或者需要仔细设计一致性。
一个应用中可以使用不同类型的数据库吗?
可以。这就是多语言持久化:使用多个数据库,每个都承担它最擅长的负载。常见的做法是用 PostgreSQL 处理核心事务,用 Redis 做缓存,用 ClickHouse(或其他列式系统)做分析。