如何阅读 EXPLAIN
第 10.4 课 · 阅读时间:约 12 分钟 · 练习题 ↓
EXPLAIN 显示数据库打算如何执行你的查询:读取哪些表、按什么顺序、是否使用索引、预计多少行。在本课中,你将逐行阅读 MySQL 和 PostgreSQL 的真实执行计划,把优化器的估算与 EXPLAIN ANALYZE 的实际数字进行对比,并学会识别慢查询的信号。
在上一课中你创建了索引。但只有数据库真正使用索引时它才有帮助,而要知道是否使用,唯一的办法就是查看执行计划。执行计划用事实代替猜测:不再是"查询很慢,也许缺个索引",而是能准确看到哪一步读取了过多的行。
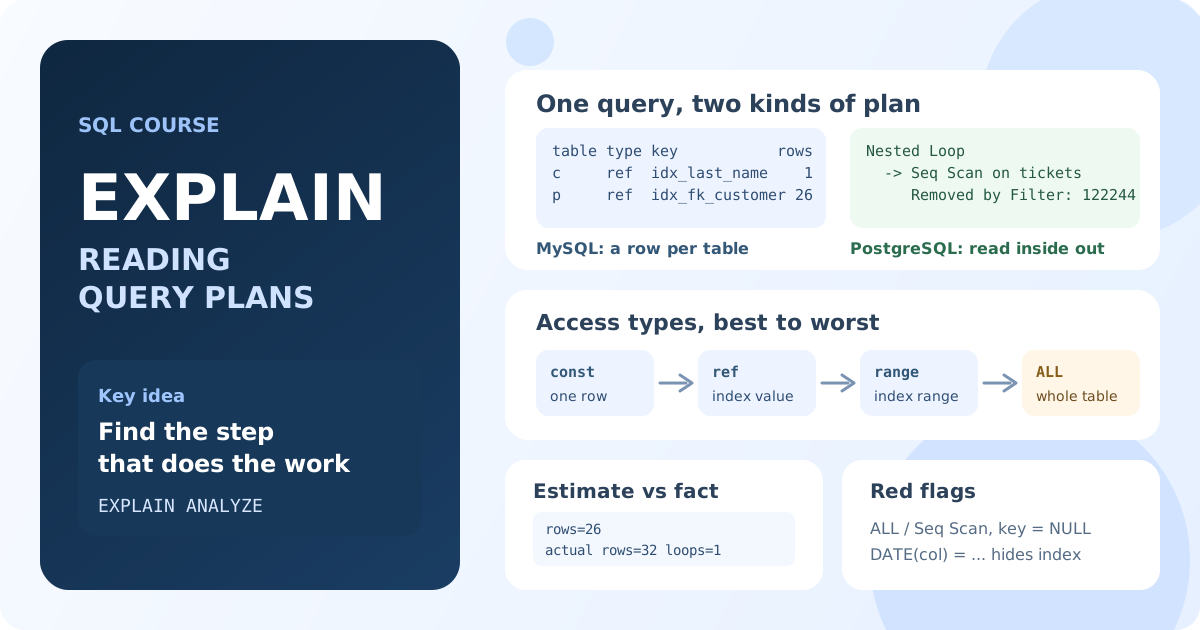
什么是执行计划
在执行查询之前,优化器会决定执行方式:先读哪张表、使用索引还是扫描整张表、如何连接表、如何排序。这个选择的结果就是执行计划。优化器选择估算成本(cost)最低的计划,而成本是根据统计信息估算的:每张表有多少行、值是如何分布的。
在查询前加上关键字即可得到执行计划:
| 数据库 | 只看计划 | 计划加实际执行 |
|---|---|---|
| MySQL、MariaDB | EXPLAIN | EXPLAIN ANALYZE(MySQL 8.0.18+)、ANALYZE(MariaDB) |
| PostgreSQL | EXPLAIN | EXPLAIN ANALYZE,常与 BUFFERS 一起使用 |
| SQLite | EXPLAIN QUERY PLAN | 无 |
| SQL Server | SET SHOWPLAN_TEXT ON 或 SSMS 中的 "Display Estimated Execution Plan" | SET STATISTICS PROFILE ON 或 "Include Actual Execution Plan" |
| Oracle | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | DBMS_XPLAN.DISPLAY_CURSOR |
EXPLAIN 只生成计划,不执行查询。EXPLAIN ANALYZE 会执行查询,并补充实际的时间和行数。
MySQL:表格格式
在 Sakila 数据库中查找姓 Smith 的客户的付款:
EXPLAIN
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
结果(MySQL 8.0):
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| id | select_type | table | type | possible_keys         | key                | ref                  | rows | filtered | Extra |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| 1  | SIMPLE      | c     | ref  | PRIMARY,idx_last_name | idx_last_name      | const                | 1    | 100.00   | NULL  |
| 1  | SIMPLE      | p     | ref  | idx_fk_customer_id    | idx_fk_customer_id | sakila.c.customer_id | 26   | 100.00   | NULL  |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
每一行是一张表,顺序就是 MySQL 读取它们的顺序:先读 customer,再对找到的每个客户读取 payment。各列含义如下:
table:这一步读取的表(或其别名)。type:访问行的方式。这是最重要的一列。possible_keys:可以使用的索引;key:实际选择的索引。key为NULL表示没有使用索引。ref:索引与什么进行比较:常量(const)或前一张表的列(sakila.c.customer_id)。rows:MySQL 预计在这一步读取的行数。这是估算,不是事实。filtered:这些行中预计能通过其余条件的百分比。Extra:附加信息,见下文。
解读这个计划:MySQL 通过 last_name 上的索引找到客户(预计 1 行),然后对这个客户通过 customer_id 上的索引查找付款(预计 26 行)。两步都使用了索引,所以查询只在 16 000 多条付款中读取了几十行。
type 列中的访问类型
从好到差:
type | 发生了什么 | 示例 |
|---|---|---|
const、eq_ref | 按主键或唯一键最多一行 | 在 customer 中 WHERE customer_id = 1 |
ref | 按索引值找到多行 | WHERE last_name = 'SMITH' |
range | 索引的一个范围 | BETWEEN、>、<、IN (...) |
index | 读取整个索引 | 索引包含所需的全部列,但没有按其第一列过滤 |
ALL | 读取整张表(全表扫描) | 条件作用在没有索引的列上 |
对小型参考表来说 ALL 没有问题。而在只需要几行的查询中对大表使用 ALL,是首先需要修复的地方。
Extra 列
Using index:所需的列都在索引中,不读取表本身(覆盖索引)。好。Using where:读取后再过滤行。本身正常,与大表上的ALL一起出现时就是问题。Using index condition:在读取行之前就在索引中检查条件(索引条件下推)。Using temporary:创建了中间临时表,通常用于GROUP BY或DISTINCT。Using filesort:行被单独排序,而不是按索引顺序读取。
例如,付款最多的五位客户:
EXPLAIN
SELECT customer_id, SUM(amount) AS total
FROM payment
GROUP BY customer_id
ORDER BY total DESC
LIMIT 5;
结果:type = index,rows = 15577,Extra = Using temporary; Using filesort。 MySQL 读取整个索引,在临时表中分组付款,再对总额排序。这里无法避免:按计算出的总额排序,必须等所有行分组完成后才知道顺序。16 000 行时很快;如果有 1 亿行,这样的报表会提前计算好(例如存入汇总表)。
函数如何让索引失效
rental 表在 rental_date 上有索引。比较两个都返回 2005 年 7 月 6 日同样 504 笔租赁的查询:
EXPLAIN
SELECT *
FROM rental
WHERE rental_date >= '2005-07-06' AND rental_date < '2005-07-07';
结果:type = range,key = rental_date,rows = 504。
EXPLAIN
SELECT *
FROM rental
WHERE DATE(rental_date) = '2005-07-06';
结果:type = ALL,key = NULL,rows = 15831。
索引是按 rental_date 排序的,而不是按 DATE(rental_date)。当列被包在函数里时,数据库无法在索引中查找,只能逐行检查。解决办法是让列保持"裸露",把计算移到比较的另一侧,就像第一个查询那样。能够这样使用索引的条件称为 SARGable。
计划树:MySQL 的 FORMAT=TREE 和 EXPLAIN ANALYZE
表格格式看不出步骤之间的嵌套关系。MySQL 8 可以把计划显示为一棵树:
EXPLAIN FORMAT=TREE
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
-> Nested loop inner join  (cost=9.45 rows=26)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26)
计划树要由内向外阅读:缩进最深的行最先执行,每一行把它的结果行交给上一层。这里第一个子节点找到客户,第二个子节点为每个客户查找付款,上方的 Nested loop inner join 把这些行合并起来。
EXPLAIN ANALYZE 会执行查询,并为每一步加上实际数字:
-> Nested loop inner join  (cost=9.45 rows=26) (actual time=0.139..0.157 rows=32 loops=1)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1) (actual time=0.0572..0.0586 rows=1 loops=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26) (actual time=0.0555..0.0688 rows=32 loops=1)
rows=26是估算,actual ... rows=32是事实。Smith 先生付了 32 笔款,而统计信息估计每位客户平均 26 笔。actual time=0.0555..0.0688:这一步返回第一行和最后一行所用的毫秒数。loops:这一步执行了多少次。嵌套循环的内侧会对外侧的每一行执行一次。
估算偏差 20% 很正常。偏差 100 倍则说明优化器是根据错误的数据选择计划的,计划本身也可能是错的。
PostgreSQL:阅读计划树
PostgreSQL 总是显示一棵树。在 Bookings 数据库中按主键查询:
EXPLAIN
SELECT *
FROM bookings.flights
WHERE flight_id = 1001;
Index Scan using flights_pkey on flights  (cost=0.29..8.31 rows=1 width=63)
  Index Cond: (flight_id = 1001)
每个节点显示:
- 操作:
Seq Scan(整张表)、Index Scan(索引加表中的行)、Index Only Scan(只用索引)、Bitmap Heap Scan(先通过索引收集匹配的行,再按存储顺序从表中读取); cost=0.29..8.31:返回第一行和全部行的估算成本,单位是抽象单位(不是毫秒);rows:估算的输出行数;width:行的平均大小(字节);- 下面的行:索引条件(
Index Cond)或过滤条件(Filter)。
departure_airport 上没有索引,所以按机场查询会读取整张表:
EXPLAIN
SELECT flight_id, scheduled_departure
FROM bookings.flights
WHERE departure_airport = 'DME';
Seq Scan on flights  (cost=0.00..806.01 rows=3217 width=12)
  Filter: (departure_airport = 'DME'::bpchar)
这里全表扫描是合理的:查询返回约 10% 的数据,按顺序读取 33 000 行的代价很小。
PostgreSQL 中的 EXPLAIN ANALYZE
查询一个预订中的机票:
EXPLAIN ANALYZE
SELECT t.passenger_name, tf.fare_conditions, tf.amount
FROM bookings.tickets t
JOIN bookings.ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '00000F';
Gather  (cost=1000.42..9103.17 rows=6 width=30) (actual time=409.864..415.535 rows=2.00 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Nested Loop  (cost=0.42..8102.57 rows=2 width=30) (actual time=388.369..389.800 rows=0.67 loops=3)
        ->  Parallel Seq Scan on tickets t  (cost=0.00..8086.07 rows=1 width=30) (actual time=386.664..387.206 rows=0.33 loops=3)
              Filter: (book_ref = '00000F'::bpchar)
              Rows Removed by Filter: 122244
        ->  Index Scan using ticket_flights_pkey on ticket_flights tf  (cost=0.42..16.47 rows=3 width=28) (actual time=5.061..7.713 rows=2.00 loops=1)
              Index Cond: (ticket_no = t.ticket_no)
Planning Time: 45.638 ms
Execution Time: 415.774 ms
由内向外阅读:
Parallel Seq Scan on tickets:三个进程(loops=3,主进程和两个工作进程)扫描整张tickets表。为了找到一张机票,每个进程丢弃约 122 000 行(Rows Removed by Filter)。Index Scan on ticket_flights:对找到的机票,通过主键索引取出它的航段。很快:不到 8 毫秒。Nested Loop把两者连接起来,Gather汇总并行进程的结果。
整个查询耗时 415 毫秒,几乎全部花在第一步上。瓶颈就是实际时间最长、丢弃行最多的节点。修复方法是在 tickets (book_ref) 上建索引。
在 PostgreSQL 中,rows 和 loops 要一起看:节点报告的是每次执行的行数,所以总数是 rows × loops。rows=0.33 loops=3 表示总共一行。
加索引前后对比
在一张有 200 000 行的测试表 orders(10 000 位客户,每人 20 个订单)上做同样的诊断:
EXPLAIN ANALYZE
SELECT id, amount, created_at
FROM orders
WHERE customer_id = 42;
没有索引时:
Seq Scan on orders  (cost=0.00..3774.00 rows=20 width=14) (actual time=0.030..19.330 rows=20.00 loops=1)
  Filter: (customer_id = 42)
  Rows Removed by Filter: 199980
Execution Time: 19.379 ms
执行 CREATE INDEX orders_customer_id_idx ON orders (customer_id); 之后:
Bitmap Heap Scan on orders  (cost=4.45..77.18 rows=20 width=14) (actual time=0.142..0.188 rows=20.00 loops=1)
  Recheck Cond: (customer_id = 42)
  ->  Bitmap Index Scan on orders_customer_id_idx  (cost=0.00..4.45 rows=20 width=0) (actual time=0.120..0.120 rows=20.00 loops=1)
        Index Cond: (customer_id = 42)
Execution Time: 0.293 ms
被丢弃的 199 980 行变成了零,查询快了约 65 倍。现在把条件写成 customer_id + 0 = 42:计划又回到 Parallel Seq Scan,估算也变成 rows=1000 而不是 20,因为优化器没有这个表达式的统计信息。
连接方式
包含多张表的计划会显示它们是如何连接的:
- Nested Loop:对外侧输入的每一行,在内侧输入中查找匹配的行。当外侧输入很小、内侧在连接列上有索引时很快,上面所有的例子都是这样。
- Hash Join:用较小的输入构建哈希表,再让较大的输入逐行匹配。适合没有可用索引的大输入。
- Merge Join:两个输入都按连接键排序后合并。适合数据已经有序的情况,例如从索引中读取。
MySQL 主要使用嵌套循环,从 8.0.18 起也支持 hash join;PostgreSQL 和 SQL Server 三种方式都会使用。
计划中的危险信号
| 信号 | 通常意味着什么 | 可以尝试 |
|---|---|---|
大表上带选择性条件时出现 type = ALL / Seq Scan | 没有合适的索引 | 在 WHERE 或 JOIN 的列上建索引 |
有索引但 key = NULL | 条件不是 SARGable:函数、表达式、LIKE '%...'、类型不一致 | 改写条件,让列保持"裸露" |
Rows Removed by Filter 很大 | 读取了很多行又丢弃 | 建索引,或建包含过滤列的复合索引 |
估算的 rows 与实际差距很大 | 统计信息过时或缺失 | ANALYZE TABLE(MySQL)、ANALYZE(PostgreSQL) |
Using temporary; Using filesort,或带 external merge 的 Sort | 对大结果分组或排序,可能用到磁盘 | 按所需顺序建索引,排序前减少行数 |
嵌套循环的 loops 很大,且内侧是全表扫描 | 内侧没有索引可用 | 在内侧表的连接列上建索引 |
要从整体上看计划。目标不是消除每一次全表扫描,而是找到耗时最多的那一步。
安全使用 EXPLAIN ANALYZE
EXPLAIN ANALYZE 会真正执行查询。对 SELECT 来说只是花费时间,但 EXPLAIN ANALYZE UPDATE ... 或 DELETE ... 会修改数据。在 PostgreSQL 中,请把这样的检查放进事务里:
BEGIN;
EXPLAIN ANALYZE
UPDATE orders SET amount = amount * 1.1 WHERE customer_id = 42;
ROLLBACK;
还要记住,第一次执行可能从磁盘读取数据,之后的执行则从内存读取。请在多次执行后、在数据量接近生产环境的数据上比较计划和时间:在只有 100 行的表上,几乎任何计划都很快。
本课要点:
EXPLAIN显示优化器选择的计划;EXPLAIN ANALYZE执行查询并补充实际时间和行数。- 在 MySQL 中先看
type、key、rows和Extra;大表上的ALL和key = NULL是首要怀疑对象。 - 计划树由内向外阅读:嵌套的步骤先执行,并把行向上传递。
- 瓶颈是实际时间最长、丢弃行最多的那一步。
- 估算行数与实际行数差距很大,说明统计信息过时。
- 在索引列上使用函数或表达式,通常会把索引查找变成全表扫描。
- 对
UPDATE或DELETE使用EXPLAIN ANALYZE会修改数据:请在事务中执行并回滚。
常见问题
EXPLAIN 和 EXPLAIN ANALYZE 有什么区别?
EXPLAIN 只显示带有优化器估算的计划,不执行查询。EXPLAIN ANALYZE 会执行查询,并显示每一步实际的时间、行数和执行次数,方便把估算和实际情况进行对比。
全表扫描总是不好吗?
不是。对小表以及返回表中大部分数据的查询来说,全表扫描是最好的选择:按顺序读取行比在索引和表之间来回跳转更便宜。问题在于为了找几行数据而扫描一张大表。
为什么数据库不使用我的索引?
常见原因:列被包在函数或表达式里、LIKE 以 % 开头、比较值的类型不一致、条件匹配了大部分行,或统计信息过时。计划会显示具体是哪种情况。
计划中的 cost 是什么意思?
cost 是优化器对工作量的估算,单位是抽象单位(页读取和 CPU 操作),不是毫秒。它适合用来比较同一个查询的不同计划;实际时间要看 EXPLAIN ANALYZE。
面试问题
你如何找出查询慢的原因?
我会运行 EXPLAIN ANALYZE(或查看实际执行计划),找出耗时最长、读取和丢弃行数最多的那一步。然后检查它是否使用了索引、条件是否 SARGable,以及估算行数是否与实际一致。
MySQL 中的访问类型 ALL、index、range 和 ref 分别是什么意思?
ALL 读取整张表;index 读取整个索引;range 为 BETWEEN、> 或 IN 读取索引的一个范围;ref 按索引值查找行。const 和 eq_ref 按唯一键最多找到一行。
优化器预计 10 行,实际却有 100 000 行。你会怎么做?
计划是基于错误的估算构建的,所以连接方式或连接顺序可能都不对。我会更新统计信息(ANALYZE),检查条件是否把列藏在表达式里,然后再次比较计划。如果数据分布不均,扩展统计信息或改写查询会有帮助。