SQL 相关子查询
第 6.3 课 · 阅读时间:约 6 分钟 · 练习题 ↓
SQL 相关子查询是引用了外层查询某一列的子查询,因此它的结果取决于当前的外层行。在本课中,你将学习相关子查询如何求值、如何把一行与其所在组进行比较、如何在 SELECT 中以及与 EXISTS 一起使用相关子查询,以及什么时候用 JOIN 更合适。
前面课程中的子查询都是独立的:你可以选中内层查询单独运行。相关子查询无法单独运行,因为它要使用外层查询当前正在处理的那一行的值。这样就可以针对每一行提问:“这部电影是否比它所属分级的平均值更贵?”、“这个类别中最长的电影是哪一部?”
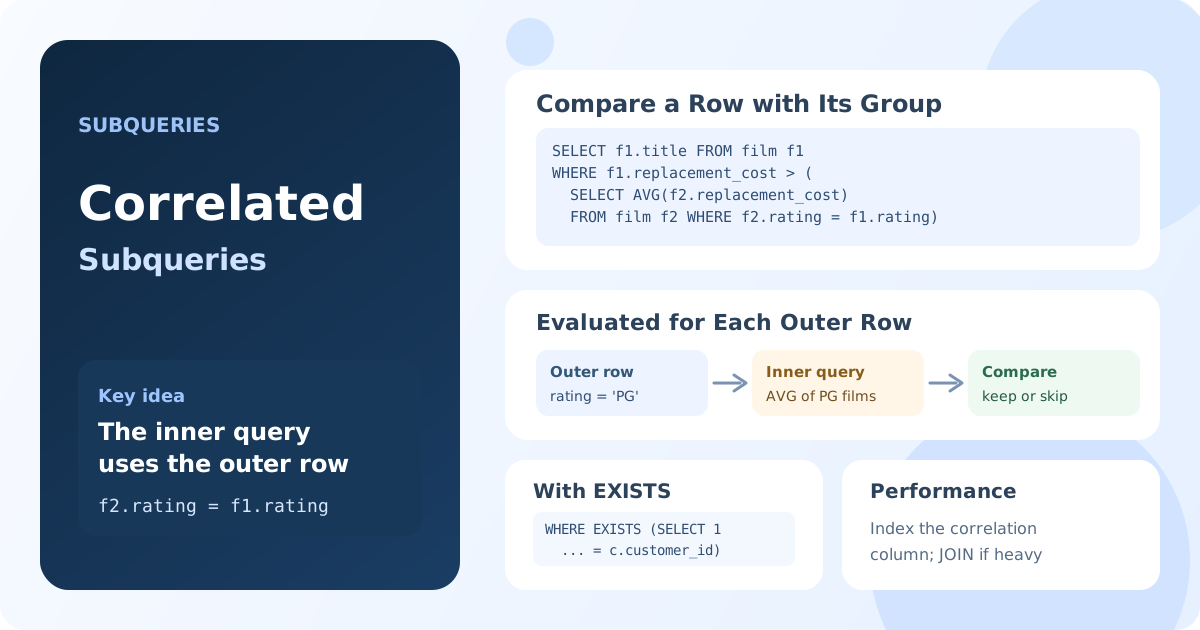
相关子查询如何工作
从逻辑上讲,数据库这样计算相关子查询:
- 取外层查询的一行。
- 代入该行的值,执行内层查询。
- 用结果计算该行的条件或列值。
- 移到下一行并重复。
两个查询之间的联系是内层查询中使用外层别名的条件,例如 f2.rating = f1.rating。别名在这里必不可少:没有别名,就无法判断某一列属于表的哪一份副本。
把一行与其所在组比较
重置成本高于其所属分级平均值的电影:
SELECT f1.title, f1.rating, f1.replacement_cost
FROM film AS f1
WHERE f1.replacement_cost > (
    SELECT AVG(f2.replacement_cost)
    FROM film AS f2
    WHERE f2.rating = f1.rating
)
ORDER BY f1.rating, f1.replacement_cost DESC;
结果:重置成本高于同一分级电影平均值的电影。
对于分级为 PG 的电影,内层查询计算 PG 电影的平均值;对于 R 级电影,则计算 R 级电影的平均值。非相关子查询只能与一个总体平均值进行比较。
SELECT 中的相关子查询
SELECT 列表中的相关子查询会为每一行返回一个值。每个类别中的电影数量:
SELECT c.name AS category,
       (SELECT COUNT(*)
        FROM film_category AS fc
        WHERE fc.category_id = c.category_id) AS films
FROM category AS c
ORDER BY films DESC;
结果:16 个类别及其电影数量,从 Sports(74 部电影)开始。
它还能返回用 GROUP BY 难以得到的值,例如每个类别中最长电影的片名:
SELECT c.name AS category,
       (SELECT f.title
        FROM film AS f
        INNER JOIN film_category AS fc ON fc.film_id = f.film_id
        WHERE fc.category_id = c.category_id
        ORDER BY f.length DESC, f.title
        LIMIT 1) AS longest_film
FROM category AS c
ORDER BY c.name;
结果:每个类别及其最长电影的片名;时长相同时按片名决定。
SELECT 中的子查询必须返回一行一列,否则查询会报错。
与 EXISTS 一起使用的相关子查询
EXISTS 检查内层查询是否至少返回一行,它几乎总是与相关子查询一起使用。查找至少租过一次 2 号门店拷贝的客户:
SELECT c.customer_id, c.first_name, c.last_name
FROM customer AS c
WHERE EXISTS (
    SELECT 1
    FROM rental AS r
    INNER JOIN inventory AS i ON i.inventory_id = r.inventory_id
    WHERE r.customer_id = c.customer_id
      AND i.store_id = 2
)
ORDER BY c.customer_id;
结果:至少有一次租赁了 2 号门店拷贝的客户。SELECT 1 是一种约定:EXISTS 只检查是否存在行,而不关心行的内容。
NOT EXISTS 用于查找没有匹配的行,类似第 5.3 课中的 LEFT JOIN ... IS NULL 反连接。
性能
“对每一行执行一次”只是逻辑模型。现代优化器经常把相关子查询改写为连接或半连接,尤其是 EXISTS 和 IN。尽管如此:
SELECT中或复杂WHERE中的相关子查询可能真的会对每个外层行执行一次,在大表上会变慢。- 在关联列上建立索引(这里是
film_category.category_id、rental.customer_id)可以让每次内层执行都很快。 - 如果同一个内层结果要用于很多列,使用带分组子查询的
JOIN或 CTE(第 6.4 课)通常更清晰、更快。
如果带相关子查询的查询很慢,请用 EXPLAIN 检查执行计划。
要点:
- 相关子查询引用了外层查询的列,不能单独执行。
- 从逻辑上讲,它对每个外层行都计算一次。
- 它是把一行与其所在组进行比较的自然工具。
- 在
SELECT中,它必须恰好返回一个值。 EXISTS和NOT EXISTS是典型的相关子查询。- 为关联列建立索引;对于开销较大的查询,可以考虑使用
JOIN或 CTE。
常见问题
相关子查询和非相关子查询有什么区别?
非相关子查询是独立的:它只执行一次,结果用于所有行。相关子查询使用外层行的值,因此它的结果可能对每一行都不同。
相关子查询很慢吗?
可能会,因为从逻辑上讲它要对每个外层行执行一次。实际上,优化器经常把它们转换为连接,而关联列上的索引也有很大帮助。请用 EXPLAIN 检查执行计划。
相关子查询可以用 JOIN 替代吗?
通常可以。例如,与组平均值的比较可以写成与分组子查询的连接:JOIN (SELECT rating, AVG(replacement_cost) AS avg_cost FROM film GROUP BY rating) AS r ON r.rating = f.rating。