SQL 最佳实践:可读且易于维护的查询
第 10.1 课 · 阅读时间:约 8 分钟
SQL 最佳实践是一组格式化和命名习惯,能让查询易于阅读、评审和修改。在本课中,你将学习如何排列子句和列,如何为表、列和别名命名,什么时候注释有帮助,哪些习惯能防止错误,以及如何把一条写在一行里的查询变成团队能够维护的代码。
在上一个模块中,你使用了视图和临时表,查询也增长到包含多个连接和多个步骤。到了这个规模,代码质量和正确性同样重要:SQL 被阅读的次数远多于被编写的次数,读者包括评审时的同事,也包括几周后的你自己。
结构良好的代码能让错误显而易见、加快评审,并让查询更容易扩展。这些规则都不会改变数据库的行为,它们改变的是人理解查询的速度。
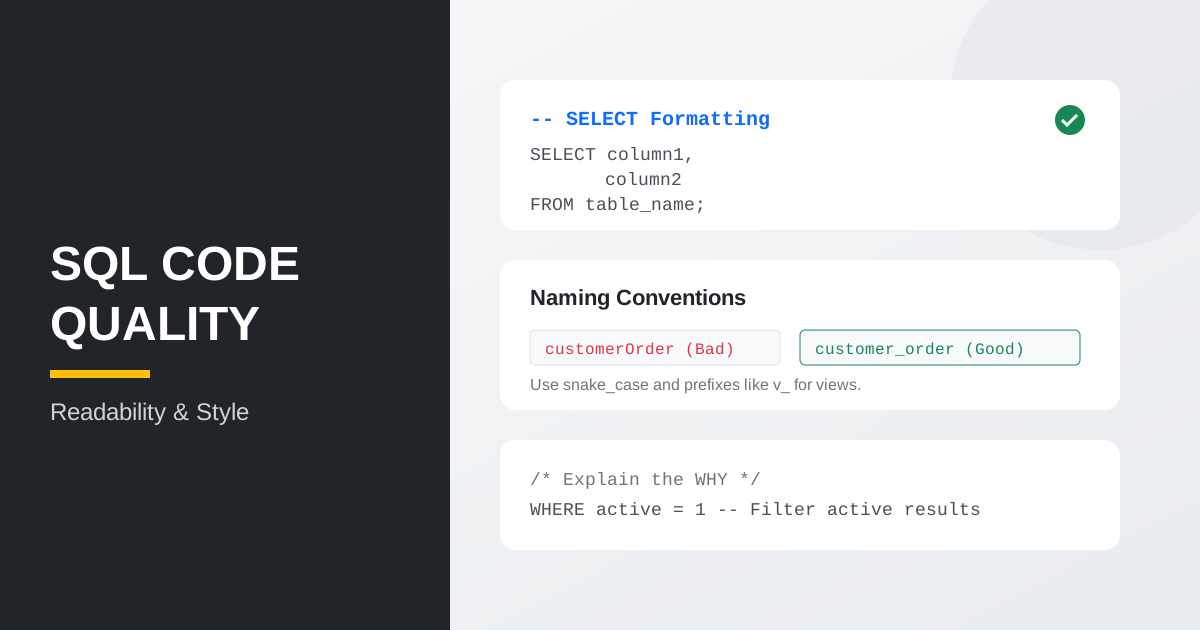
为什么代码风格很重要
5–10 行的查询一眼就能看懂。包含大量 JOIN、子查询或 CTE 的报表则不然,而一致的风格可以帮助你:
- 更快发现错误:在整洁的代码中,错误的过滤条件或遗漏的连接条件会很显眼。
- 安全地扩展查询:新的列或条件都有明确的位置。
- 团队协作:大家用同样的布局阅读代码,评审关注逻辑而不是风格。
格式化与缩进
SQL 不在意空格和关键字的大小写,所以布局由你决定。下面是最常用的约定。
关键字大写
把 SQL 关键字(SELECT、FROM、WHERE、JOIN、GROUP BY)写成大写,名称写成小写。这样查询的结构就能从它所使用的数据中凸显出来。
-- 难以浏览
select title, rental_rate from film where rating = 'G';

-- 更容易浏览
SELECT title, rental_rate
FROM film
WHERE rating = 'G';
结果:两条查询返回同样的 178 部电影,只是布局不同。
每个子句一行
每个主要子句都另起一行。如果 SELECT 或 GROUP BY 中列出很多列,就把每一列单独放一行并缩进:
SELECT
    customer_id,
    first_name,
    last_name,
    email
FROM customer
WHERE active = 1
ORDER BY last_name;
每行一列时,增加或删除一列只会改动一行,代码评审中的 diff 也只显示这一行。
命名约定
小写与 snake_case
事实上的标准是使用小写名称,并用下划线分隔单词:customer_orders、total_amount,而不是 CustomerOrders 或 TotalAmount。不同数据库对标识符大小写的处理不同:PostgreSQL 会把不带引号的名称转换为小写,而 Linux 上的 MySQL 对表名区分大小写。snake_case 可以避免这些意外。
统一的前缀
有些团队用前缀标记对象类型,例如视图用 v_(v_active_customers),临时表用 tmp_(tmp_monthly_report)。Sakila 不使用前缀:它的视图叫 customer_list、film_list、sales_by_film_category。两种做法都可以,关键是整个数据库只采用一种规则。
SELECT category, total_sales
FROM sales_by_film_category
ORDER BY total_sales DESC
LIMIT 3;
结果:销售额最高的三个分类:Sports、Sci-Fi 和 Animation。
清晰的别名
表别名
使用简短但有意义的别名,例如表名的首字母。t1、t2、a、b 这样的别名会迫使读者去查每个别名代表什么:
-- 不清楚:t1 和 t2 是什么?
SELECT t1.first_name, t2.amount
FROM customer t1
JOIN payment t2 ON t1.customer_id = t2.customer_id;

-- 清楚
SELECT c.first_name, p.amount
FROM customer c
JOIN payment p ON c.customer_id = p.customer_id;
计算列的名称
用 AS 给每个聚合和表达式命名。报表中名为 COUNT(*) 的列很难在应用程序或电子表格中使用:
SELECT
    c.name AS category_name,
    COUNT(*) AS film_count,
    AVG(f.replacement_cost) AS avg_replacement_cost
FROM film f
JOIN film_category fc ON f.film_id = fc.film_id
JOIN category c ON fc.category_id = c.category_id
GROUP BY c.name
ORDER BY film_count DESC;
结果:16 个分类,列名清晰;Sports 的电影最多,共 74 部。
注释
当原因无法从代码本身看出时,注释用来解释代码为什么这样做:业务规则、不寻常的过滤条件、已知的数据问题。
- 单行注释(
--)解释某个过滤条件或公式。 - 块注释(
/* ... */)描述脚本的用途。
/*
  报表:2005 年 7 月客户消费
  用于:每月营销邮件
*/
SELECT
    customer_id,
    SUM(amount) AS july_spent
FROM payment
WHERE payment_date >= '2005-07-01'  -- 整个月,
  AND payment_date < '2005-08-01'   -- 包括 7 月 31 日零点之后
GROUP BY customer_id
ORDER BY july_spent DESC;
结果:599 位客户及其 2005 年 7 月的消费额。
不要注释代码已经说明的内容:在 SELECT customer_id 上方写 -- 选择 customer id 只会增加噪音,而过时的注释比没有注释更糟糕。
让查询更安全的习惯
- 在报表、视图和应用代码中列出具体的列,而不是使用
SELECT *。这样表中新增的列就不会改变或拖慢你的结果。 - 使用显式的
JOIN ... ON,而不是在FROM中用逗号列出多张表。连接条件紧挨着表,更不容易被遗漏。 - 对日期时间列,优先使用半开区间(
>= start AND < end)而不是BETWEEN,如上面的示例所示。 - 约定一种风格并让它自动化。像 SQLFluff 这样的格式化工具和 linter 会替你应用规则,评审时就不必再争论空格。
实践示例:整理一条混乱的查询
整理前:全部写在一行,计算列没有名称:
select f.title,c.name,count(r.rental_id) from film f join film_category fc on f.film_id=fc.film_id join category c on fc.category_id=c.category_id join inventory i on f.film_id=i.film_id join rental r on i.inventory_id=r.inventory_id group by f.title,c.name having count(r.rental_id)>30 order by count(r.rental_id) desc;
整理后:每个子句一行,连接对齐,列有名称:
SELECT
    f.title,
    c.name AS category_name,
    COUNT(r.rental_id) AS rental_count
FROM film f
JOIN film_category fc ON f.film_id = fc.film_id
JOIN category c       ON fc.category_id = c.category_id
JOIN inventory i      ON f.film_id = i.film_id
JOIN rental r         ON i.inventory_id = r.inventory_id
GROUP BY f.title, c.name
HAVING COUNT(r.rental_id) > 30
ORDER BY rental_count DESC;
结果:两个版本都返回同样的 16 部被租借超过 30 次的电影,排在首位的是 BUCKET BROTHERHOOD,共 34 次。
在第二个版本中,一眼就能看出连接了哪些表、如何连接、统计了什么,以及结果如何过滤和排序。
要点:
- 关键字用大写,名称用小写的
snake_case。 - 每个子句另起一行,较长的列列表每行一列。
- 使用有意义的表别名,并用
AS为每个计算列命名。 - 注释说明“为什么”,而不是“做什么”:业务规则和不明显的过滤条件。
- 列出具体的列而不是
SELECT *,使用显式的JOIN ... ON和半开日期区间。 - 团队约定统一的风格,并用格式化工具或 linter 来执行。
常见问题
SQL 关键字必须大写吗?
不必。数据库接受任意大小写的关键字。大写关键字是一种约定,能让长查询的结构更清晰;最重要的是整个团队使用同一种风格。
什么样的 SQL 代码易于维护?
一致的格式、清晰的名称和别名、有名称的计算列,以及在逻辑不明显处的简短注释。这样的代码更容易评审、修改和调试,即使不是原作者也能轻松上手。
为什么在生产查询中要避免 SELECT *?
SELECT * 会返回所有列,包括之后新加入表中的列。这可能破坏依赖固定列集合的应用程序,传输不必要的数据,并妨碍使用覆盖索引。请列出你需要的列。
如何整理一条混乱的 SQL 查询?
把它拆成各自独占一行的子句(SELECT、FROM、JOIN、WHERE、GROUP BY、ORDER BY),为列列表加上缩进,替换含义不清的别名,为计算列命名,并在需要解释的逻辑处添加注释。分别运行旧版本和新版本,确认结果一致。