高效的 SQL 查询:编写更快、更精简的 SQL
第 10.2 课 · 阅读时间:约 10 分钟 · 练习题 ↓
本课介绍编写高性能 SQL 查询的基础知识。你将学习如何避免给数据库带来不必要的负载、为什么 SELECT * 往往会损害性能,以及如何高效地过滤数据。我们会介绍一些能让查询运行得更快的实用技巧,即使数据量很大也同样适用。学完本课后,你将能够写出高效、合理使用服务器资源的 SQL。
在上一课中,我们关注的是让人更容易读懂代码。但 SQL 也必须让数据库引擎容易处理、执行高效。即使代码格式完美,如果它迫使服务器做不必要的工作,性能也可能很差。
查询效率直接影响应用和报表的速度。在大数据量或高负载的系统中,“能运行”和“已优化”之间的差距可能是几分钟甚至几小时的运行时间。
现代 DBMS 拥有强大的优化器,可以在内部改写查询。但优化器并非万能:它不了解你的业务意图,也不一定能修正从根本上低效的设计。代码质量仍然是开发人员的责任。
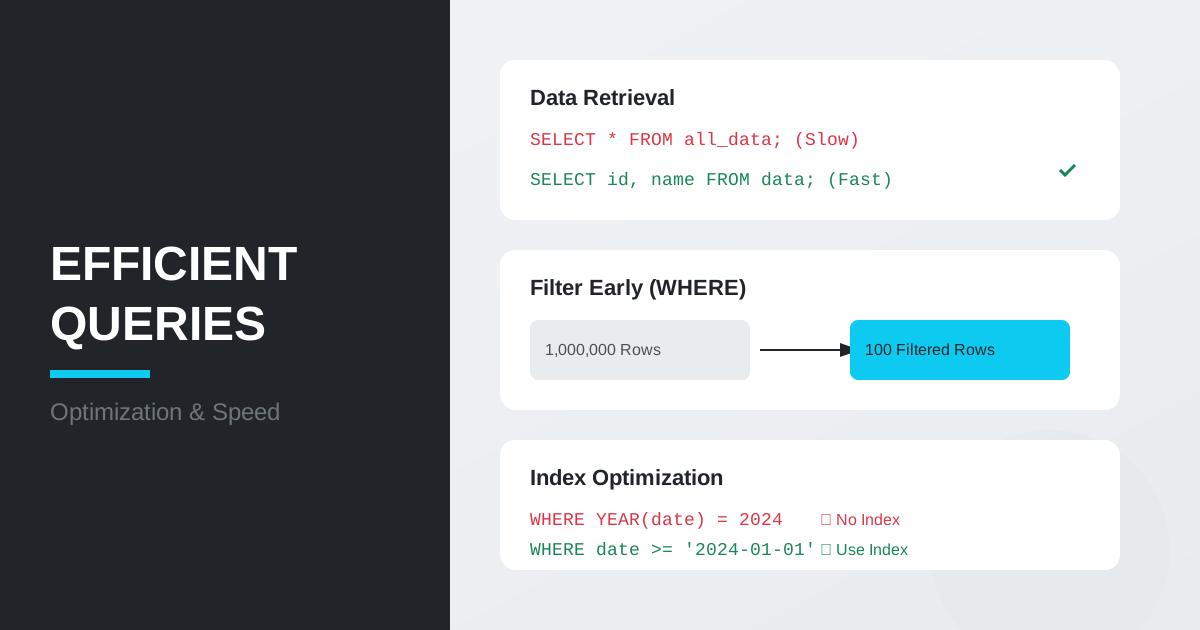
黄金法则:只取需要的数据
查询变慢最常见的原因,是在数据库服务器和客户端之间传输了过多不必要的数据。
避免使用 SELECT *
SELECT * 适合快速探索数据,但在生产环境的 SQL 中应避免使用。
- 额外流量: 传输了你并不需要的列。
- 索引受限: 请求所有列时,更难利用覆盖索引。
- 代码脆弱: 新增一列就可能意外改变行为和性能。
-- Poor
SELECT * FROM film;

-- Better
SELECT film_id, title, release_year
FROM film;
优化过滤
限制行的方式决定了 DBMS 需要扫描和处理多少数据。
在服务器端过滤
尽早应用 WHERE 条件,在繁重的聚合或把数据返回给客户端之前完成。越早减少行数,后续步骤(JOIN、GROUP BY)就越快。
避免在 WHERE 中使用函数(SARGable 查询)
为了有效利用索引,WHERE 中的谓词应当是 SARGable(Search ARGumentable,可用于索引检索)的。如果用函数包裹带索引的列,优化器往往无法高效使用索引,可能会扫描整张表。
-- Slow (Non-SARGable: index on rental_date may not be used)
SELECT count(*)
FROM rental
WHERE YEAR(rental_date) = 2005;

-- Fast (SARGable: index can be used)
SELECT count(*)
FROM rental
WHERE rental_date >= '2005-01-01' AND rental_date < '2006-01-01';
使用 JOIN
连接表是查询中最耗费资源的操作之一。
- 先过滤,再连接: 在连接之前减少关联表中的行数。
- 检查连接键上的索引: 通常是主键和外键。
- 避免不必要的
CROSS JOIN: 笛卡尔积会迅速膨胀。 - 用
EXISTS检查是否存在: 如果只需要知道相关行是否存在,EXISTS通常比JOIN开销更小。
-- Less efficient (JOIN forces matching through all payments)
SELECT DISTINCT c.first_name, c.last_name
FROM customer c
JOIN payment p ON c.customer_id = p.customer_id;

-- More efficient (EXISTS can stop on first match)
SELECT c.first_name, c.last_name
FROM customer c
WHERE EXISTS (
    SELECT 1 FROM payment p WHERE p.customer_id = c.customer_id
);
测试时使用 LIMIT
调试查询时,务必使用 LIMIT,以免意外返回数百万行。
SELECT customer_id, first_name, last_name
FROM customer
WHERE active = 1
LIMIT 10;
实践示例:优化报表
假设我们需要找出某一类别中被租借超过 30 次的电影。
效率较低的写法:
SELECT f.title, COUNT(r.rental_id)
FROM film f
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
JOIN film_category fc ON f.film_id = fc.film_id
JOIN category c ON fc.category_id = c.category_id
WHERE c.name = 'Action'
GROUP BY f.title
HAVING COUNT(r.rental_id) > 30;
效率更高的写法: 如果已知类别 ID,就可以省去按类别名称查找的那次连接。
SELECT f.title, COUNT(r.rental_id) AS rental_count
FROM film f
JOIN film_category fc ON f.film_id = fc.film_id
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
WHERE fc.category_id = 1 -- Use ID instead of string lookup
GROUP BY f.film_id, f.title
HAVING COUNT(r.rental_id) > 30;
说明:按数字 ID 过滤通常比按文本名称过滤更快,而且往往可以减少连接次数。
本课要点:
- 在生产环境的查询中避免使用
SELECT *,只列出需要的列。 - 尽早用
WHERE过滤。 - 编写 SARGable 谓词,以便能够使用索引。
- 只需检查是否存在时,优先使用
EXISTS而不是JOIN。 - 在探索数据和调试时使用
LIMIT。 - 优先按数字键而不是文本标签过滤。
常见问题
为什么 SELECT * 在生产查询中有害?
它会返回不必要的列、增加流量,并可能妨碍使用索引的执行计划。明确列出列名通常更快也更安全。
SARGable 在实践中是什么意思?
SARGable 谓词允许通过索引进行查找。用函数包裹带索引的列,通常会阻止高效地使用索引。
什么时候用 EXISTS 代替 JOIN?
当你只需要知道相关行是否存在、而不需要第二张表的列时,使用 EXISTS。
面试问题
当一条 SQL 查询很慢时,你首先会做什么?
检查它是否使用了 SELECT *,评估 WHERE 的选择性,并找出非 SARGable 的谓词。然后检查连接策略以及查询早期阶段的行数。
为什么尽早过滤能提升性能?
它减少了参与连接、排序和聚合的行数,从而降低了整个执行计划的成本。
从性能角度看,JOIN 和 EXISTS 有什么区别?
JOIN 合并行集,当你需要两边表的列时必须使用它。EXISTS 在做“是/否”存在性检查时通常更快,因为它可以在第一条匹配处停止。