B-tree 索引如何工作
第 10.5 课 · 阅读时间:约 11 分钟 · 练习题 ↓
本课从物理和逻辑两个层面详细讲解 SQL 中的 B-tree 索引如何工作。你将了解它由哪些节点组成、数据库如何遍历这棵树,以及为什么这种方式能加快过滤和排序。我们会在 Sakila 的表上看实际示例,并巩固关键的使用规则。学完本课后,你会更清楚 B-tree 索引在什么时候真正能加速查询。
在前面的课程中,你学习了如何创建索引,以及如何通过执行计划确认查询使用了索引。现在来看看索引的内部结构,以及它为什么能加快查找。
理解 B-tree 能帮你看清索引什么时候真正起作用、什么时候无法使用。这些知识在优化慢查询时会很有用。
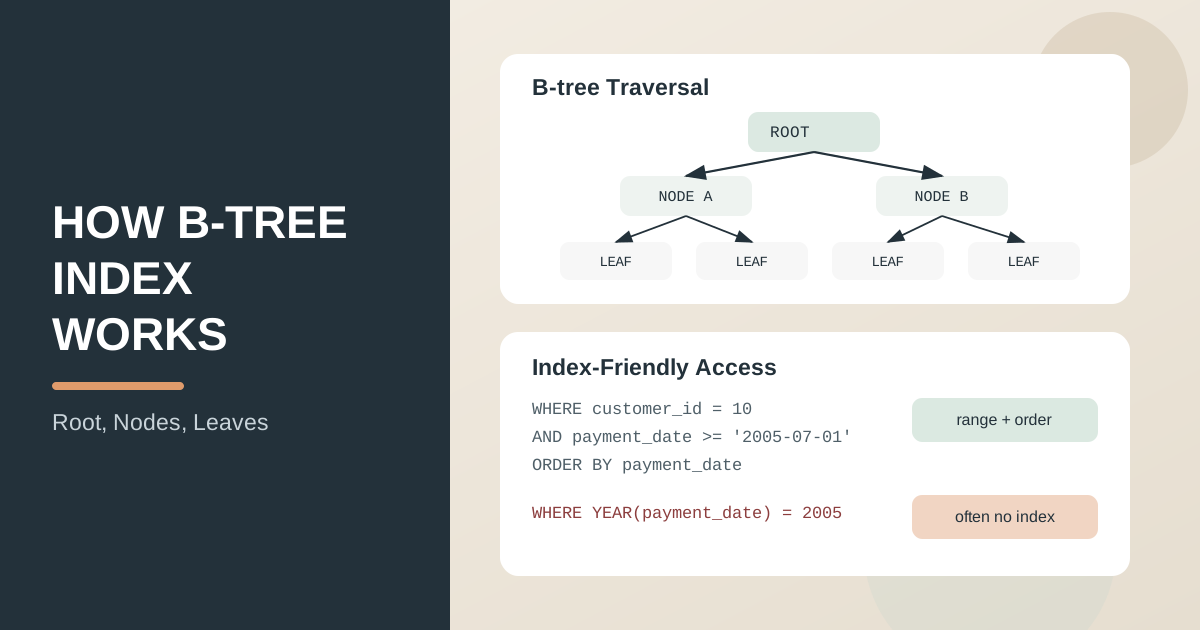
什么是 B-tree 索引
B-tree 索引就像书的目录。你不必按顺序读完所有页面,而是打开目录,找到需要的章节,然后直接翻过去。
B-tree 有三层:
- 根节点:查找的起点,就像目录的封面;
- 中间节点:提示下一步往哪里走;
- 叶子节点:包含要找的值以及指向表中行的链接。
整个结构都是有序的,因此数据库在每一层都能迅速选出正确的方向。
它的样子如下:
                    [ ROOT ]
                   /   |   \
                  /    |    \
            [NODE A] [NODE B] [NODE C]
            / |  \    / | \    / | \
           /  |   \  /  |  \  /  |  \
         [L1][L2][L3][L4][L5][L6][L7][L8]
每个节点都包含帮助选择下一个节点的值。叶子节点(L1–L8)包含你需要的数据。
在 B-tree 中如何查找
当你查找 WHERE last_name = 'SMITH' 时,数据库会:
- 从根节点开始;
- 选择以 'S' 开头的姓氏可能所在的分支;
- 逐层向下,在每一层缩小查找范围;
- 在叶子节点中找到要找的姓氏。
借助这种算法,查找非常快:即使表中有数百万行,也只需检查少数几层。
B-tree 最擅长加速哪些操作
等值(=)
B-tree 非常适合查找精确值。
SELECT
   customer_id,
   first_name,
   last_name
FROM customer
WHERE last_name = 'SMITH';
范围(>、<、BETWEEN)
由于键是有序的,B-tree 处理范围条件很高效。
SELECT
   payment_id,
   amount,
   payment_date
FROM payment
WHERE payment_date >= '2005-07-01'
  AND payment_date < '2005-08-01';
排序(ORDER BY)
如果排序顺序与索引一致,数据库往往可以省去单独的、代价高昂的排序。
SELECT
   payment_id,
   customer_id,
   payment_date
FROM payment
WHERE customer_id = 10
ORDER BY payment_date;
复合 B-tree 索引示例
为一种常见的过滤加排序模式创建索引:
CREATE INDEX idx_payment_customer_date
ON payment (customer_id, payment_date);
查看执行计划:
EXPLAIN
SELECT
   payment_id,
   customer_id,
   payment_date,
   amount
FROM payment
WHERE customer_id = 10
  AND payment_date >= '2005-07-01'
ORDER BY payment_date;
结果:通常数据库会用这个索引按 customer_id 过滤、按 payment_date 的范围过滤,并按顺序读取行。
复合索引的最左前缀规则
如果索引建在 (customer_id, payment_date) 上,当条件首先按 customer_id 过滤时,数据库对它的利用最好。
效果好:
WHERE customer_id = 10
效果好:
WHERE customer_id = 10 AND payment_date >= '2005-01-01'
效果差:
WHERE payment_date >= '2005-01-01'
这条规则叫做“最左前缀”:按从左到右的顺序使用条件时,索引效果最好。
索引什么时候帮不上忙
在以下情况下不会使用索引:
- 对列使用了函数:
WHERE YEAR(payment_date) = 2005,索引不起作用; - 通配符放在开头:
WHERE name LIKE '%SMITH',索引帮不上忙; - 条件太宽泛、返回很多行:使用索引可能比读取整张表还慢。
不好(函数阻止了索引的使用):
SELECT payment_id, payment_date
FROM payment
WHERE YEAR(payment_date) = 2005;
好(索引可以发挥作用):
SELECT payment_id, payment_date
FROM payment
WHERE payment_date >= '2005-01-01'
  AND payment_date < '2006-01-01';
实用建议
- 为经常出现在
WHERE、JOIN、ORDER BY中的字段建立索引。 - 对于复合索引,把对过滤最重要的列放在最前面。
- 用
EXPLAIN检查索引的实际使用情况。 - 不要创建冗余索引:它们会增加写入成本。
本课要点:
- B-tree 是一种平衡结构,可以加快按键查找。
- B-tree 的主要优势:等值查找、范围查找以及按索引顺序排序。
- 复合索引遵循最左前缀规则。
- 不恰当的条件写法会让查询失去索引带来的好处。
EXPLAIN能帮你判断实际执行计划中是否使用了 B-tree。
常见问题
B-tree 中的 B 代表什么?
通常理解为 "balanced"(平衡):所有叶子节点到根节点的距离相同,因此任何查找所需的步数都一样。1972 年提出这种结构的 Rudolf Bayer 和 Edward McCreight 从未解释过这个字母。实际上,大多数数据库使用的是 B+tree 变体,其叶子节点连成链表,使范围扫描更快。
B-tree 索引和哈希索引有什么区别?
哈希索引只能查找精确匹配(=)。B-tree 的键是有序的,因此还能处理范围(>、<、BETWEEN)、ORDER BY 以及 LIKE 'SM%' 这样的前缀搜索。所以 B-tree 是 MySQL(InnoDB)和 PostgreSQL 的默认索引类型。
B-tree 索引有几层?
通常是三到四层,即使有数百万行也是如此。每个节点是一个磁盘页(InnoDB 中为 16 KB,PostgreSQL 中为 8 KB),能容纳数百个键,因此每多一层,可到达的行数就会乘以数百。查找一行只需要读取几个页。
面试问题
为什么 B-tree 索引通常比全表扫描快?
因为数据库沿着树的分支遍历,用对数级的步数就能找到所需范围,而不必扫描表中的所有行。
复合索引的最左前缀规则是什么?
这条规则指的是:当条件从键的第一列开始并按顺序使用后续列时,优化器对索引的利用最好。
在实践中如何确认 B-tree 索引被使用了?
运行 EXPLAIN,查看每个执行阶段的访问类型、选中的键以及预计行数。