ROW_NUMBER、RANK、DENSE_RANK 与 NTILE
第 7.2 课 · 阅读时间:约 8 分钟 · 练习题 ↓
SQL 排名函数按指定顺序为行编号:ROW_NUMBER、RANK 和 DENSE_RANK 分配名次,NTILE 则把行分成若干组。它们的唯一区别在于如何处理并列(值相等的行),而正是这个区别决定了报表是否正确。在本课中,你将在同一份真实数据上比较所有这些函数,了解为什么 ROW_NUMBER 需要用于打破并列的排序依据,并学会针对不同任务选择合适的函数。
在上一课中,你用 ROW_NUMBER() 为付款编号。排名函数遵循同样的模式:一个函数,后面跟着 OVER,其中的 ORDER BY 定义什么是“第一”,可选的 PARTITION BY 让每个组重新开始排名。排名函数会忽略窗口框架:它们总是查看整个分区。
示例在 Sakila 示例数据库(MySQL 8.0)上运行。
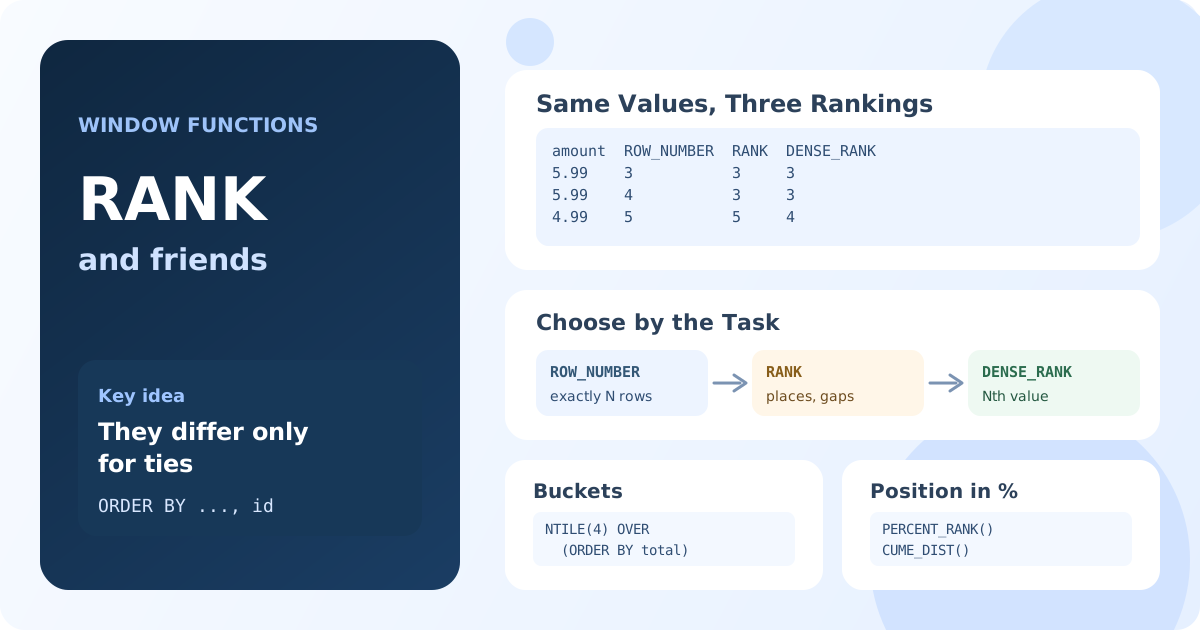
三个函数并排比较
客户 1 一共付款 32 次,其中有几笔金额相同:四笔 5.99 和八笔 4.99。把付款从大到小排名:
SELECT
    payment_id,
    amount,
    ROW_NUMBER() OVER (ORDER BY amount DESC, payment_id) AS row_num,
    RANK()       OVER (ORDER BY amount DESC) AS rnk,
    DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
FROM payment
WHERE customer_id = 1
ORDER BY row_num
LIMIT 8;
结果:客户 1 金额最大的 8 笔付款。
| payment_id | amount | row_num | rnk | dense_rnk |
|---|---|---|---|---|
| 5 | 9.99 | 1 | 1 | 1 |
| 14 | 7.99 | 2 | 2 | 2 |
| 3 | 5.99 | 3 | 3 | 3 |
| 10 | 5.99 | 4 | 3 | 3 |
| 11 | 5.99 | 5 | 3 | 3 |
| 32 | 5.99 | 6 | 3 | 3 |
| 6 | 4.99 | 7 | 7 | 4 |
| 7 | 4.99 | 8 | 7 | 4 |
ROW_NUMBER给每一行一个独立的编号:1、2、3、4……相等的值也会得到不同的编号。RANK给相等的值相同的名次,然后跳过后续编号:四笔付款并列第 3 名,所以下一个名次是 7。这就是“竞赛排名”,就像赛跑中的名次。DENSE_RANK给相等的值相同的名次,但不跳号:第 3 名之后就是第 4 名。不同名次的数量等于不同值的数量。
ROW_NUMBER 需要打破并列的排序依据
即使值相等,ROW_NUMBER 也必须决定一个顺序,而数据库可以任意选择。如果上面的 ORDER BY 中没有 payment_id,MySQL 会把四笔 5.99 的付款编号为 4、5、6、3,而换一次执行或换一个服务器版本,顺序可能又不一样。依赖“第 3 行”的报表就会在每次执行时发生变化。
只要 ROW_NUMBER 的结果有实际用途,例如分页或“保留第一行”,就在 OVER 中的 ORDER BY 里加上一个唯一列,比如主键。RANK 和 DENSE_RANK 不需要这样做:相等的值本来就会得到相同的名次。
NTILE:把行分组
NTILE(n) 并不对值排名,而是把排好序的行分配到 n 个大小几乎相等的组中,并返回组号。这是构建四分位、十分位或“前 10%”分段的标准方法。
把每家门店的客户按消费额分成四分位:
WITH customer_total AS (
    SELECT c.store_id, c.customer_id, SUM(p.amount) AS total_paid
    FROM customer c
    JOIN payment p ON p.customer_id = c.customer_id
    GROUP BY c.store_id, c.customer_id
),
segmented AS (
    SELECT
        store_id,
        total_paid,
        NTILE(4) OVER (PARTITION BY store_id ORDER BY total_paid DESC) AS quartile
    FROM customer_total
)
SELECT
    store_id,
    quartile,
    COUNT(*) AS customers,
    MIN(total_paid) AS min_paid,
    MAX(total_paid) AS max_paid
FROM segmented
GROUP BY store_id, quartile
ORDER BY store_id, quartile;
结果:8 行;门店 1 有 326 位客户,被分成 82、82、81 和 81 人;消费最高的四分位付款金额在 128.73 到 216.54 之间。
| store_id | quartile | customers | min_paid | max_paid |
|---|---|---|---|---|
| 1 | 1 | 82 | 128.73 | 216.54 |
| 1 | 2 | 82 | 111.74 | 128.73 |
| 1 | 3 | 81 | 96.72 | 111.73 |
| 1 | 4 | 81 | 50.85 | 95.78 |
| 2 | 1 | 69 | 127.68 | 221.55 |
| ... | ... | ... | ... | ... |
当行数不能均分时,前面的组会多一行。NTILE 按行数而不是按值来划分:位于边界上的相等值可能被分到不同的组,就像这里的 128.73。
PERCENT_RANK 与 CUME_DIST
还有两个函数把位置表示为 0 到 1 之间的比例:
PERCENT_RANK()= (名次 − 1) / (行数 − 1):严格排在前面的行所占的比例。第一行得到 0。CUME_DIST()= 值不超过当前值(含当前值)的行数 / 总行数:位于当前位置及之前的行所占的比例。
SELECT
    payment_id,
    amount,
    ROUND(PERCENT_RANK() OVER (ORDER BY amount DESC), 2) AS pct_rank,
    ROUND(CUME_DIST() OVER (ORDER BY amount DESC), 2) AS cumulative_share
FROM payment
WHERE customer_id = 1
ORDER BY amount DESC, payment_id
LIMIT 4;
结果:9.99 那笔付款的 pct_rank 为 0,cumulative_share 为 0.03;每笔 5.99 付款的 pct_rank 为 0.06,cumulative_share 为 0.19,因为 32 笔付款中有 6 笔不小于 5.99。
它们适合用于“前 10% 客户”这类筛选:在外层查询中写 WHERE cumulative_share <= 0.1。不要把列命名为 cume_dist 或 rank:在 MySQL 8 中它们是保留字。
该用哪个函数
| 任务 | 函数 |
|---|---|
| 每组恰好 N 行、最近一行、分页 | 带打破并列依据的 ROW_NUMBER |
| 比赛名次:成绩相同共享名次,下一个名次跳过 | RANK |
| 第 N 个不同的值,例如第二高的薪水 | DENSE_RANK |
| 四分位、十分位、大小相等的分段 | NTILE(n) |
| 以百分比表示的相对位置 | PERCENT_RANK、CUME_DIST |
基于这些函数的两道题目在面试题课程中有详细讲解:每组前 N 行(第 12.6 课)和第 N 高的薪水(第 12.4 课)。
要点:
ROW_NUMBER、RANK和DENSE_RANK只在并列时有区别:唯一编号、带空缺的共享名次、无空缺的共享名次。- 对于 9.99、7.99、5.99、5.99、4.99 这些值,它们分别返回 1-2-3-4-5、1-2-3-3-5 和 1-2-3-3-4。
- 使用
ROW_NUMBER时要在ORDER BY中加入唯一的排序依据,否则相等值的编号是任意的。 NTILE(n)按行数把排好序的行分成n个几乎相等的组。PERCENT_RANK和CUME_DIST用 0 到 1 之间的比例表示位置。
常见问题
ROW_NUMBER、RANK 和 DENSE_RANK 有什么区别?
三者都按 OVER 中的 ORDER BY 为行编号。ROW_NUMBER 总是给出唯一编号。RANK 给相等的值相同名次,并跳过后续编号(1、2、2、4)。DENSE_RANK 给相等的值相同名次,但不跳号(1、2、2、3)。
什么时候用 RANK,什么时候用 DENSE_RANK?
当名次需要反映前面有多少行时(如体育比赛成绩:两人并列第 1,下一个是第 3),使用 RANK。当你需要连续的、按不同值划分的层级时(例如“第二高的价格”),使用 DENSE_RANK。
行数不能均分时,NTILE 如何处理?
前面的组会各多一行。326 行使用 NTILE(4) 时,各组分别有 82、82、81 和 81 行。NTILE 按行计数,所以相等的值可能被分到两个相邻的组中。
为什么同一个查询中 ROW_NUMBER 会给出不同的结果?
因为 OVER 中的 ORDER BY 存在并列,数据库在不同执行中可能以不同顺序排列相等的行。把一个唯一列(例如主键)作为最后的排序键,编号就会变得确定。