SQL 连接算法:数据库如何执行连接
第 5.9 课 · 阅读时间:约 9 分钟 · 练习题 ↓
SQL 连接算法是数据库执行连接时使用的方法:nested loop join、hash join 和 merge join。在本课中,你将了解每种算法如何工作、查询规划器何时选择它、哪些数据库支持哪些算法,以及如何用 EXPLAIN 查看所选的算法。
在前面的课程中,你编写连接时关注的是它们返回哪些行。同一个连接可以用非常不同的方式执行,在大表上它们的差别可能是几秒和几小时。你不能在 SQL 中选择算法,这由查询规划器决定。但了解这些算法的工作原理,就能明白为什么连接列上的索引很重要,以及如何阅读执行计划。
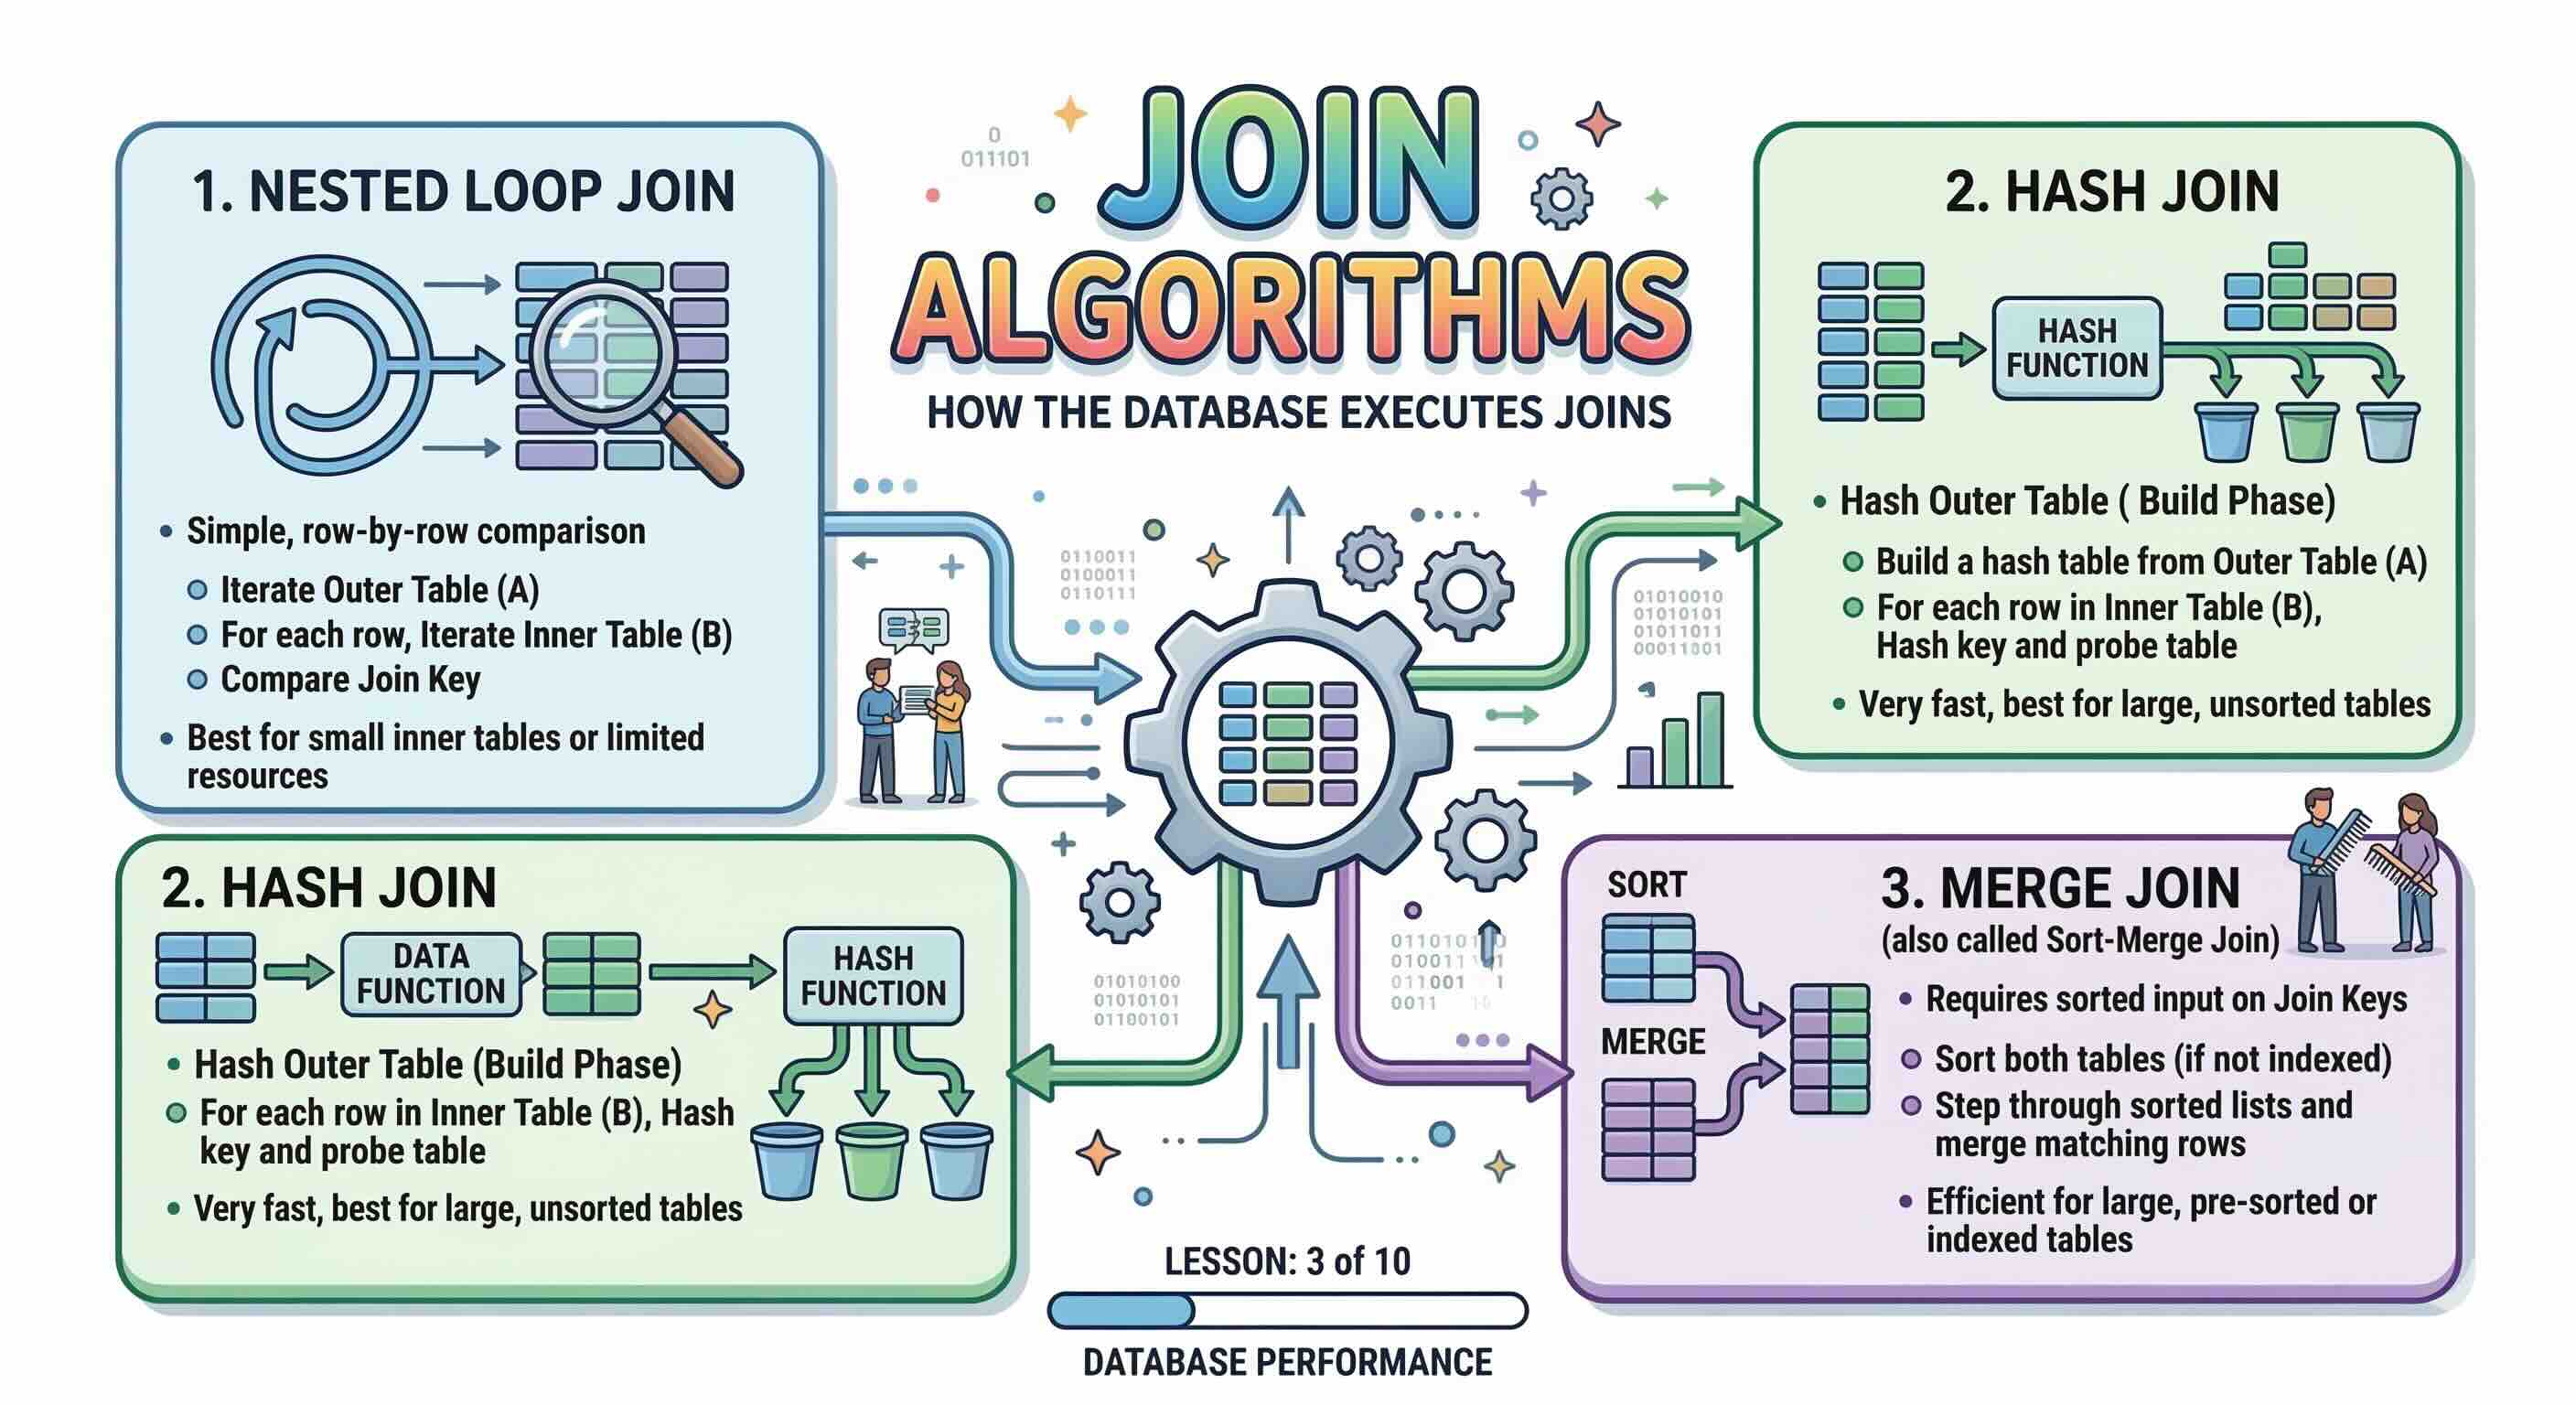
Nested Loop Join
工作原理
数据库选择一张表作为外表(驱动表),对其中的每一行,在内表中查找匹配:也就是两层嵌套循环。
for each row R1 in outer_table:
    for each row R2 in inner_table:
        if R1.key = R2.key:
            output(R1, R2)
没有索引时,每一行外表数据都要完整扫描一遍内表:共 N × M 次比较。如果内表的连接列上有索引,每次查找都会变成快速的索引查找。这种 index nested loop join 在外侧数据量较小时是最高效的计划之一。
规划器何时使用它
- 外表,或者过滤后的外侧数据较小。
- 内表的连接列上有索引。
- 连接条件不是等值条件(
<、>、BETWEEN):经典的 hash join 和 merge join 只适用于等值条件。
| 优点 | 缺点 |
|---|---|
| 适用于任何连接条件 | 在没有索引的大表上非常慢:N × M |
| 外侧数据小且有索引时非常快 | 成本随两张表的规模迅速增长 |
| 内存占用少;能立即返回第一批行 |
Hash Join
工作原理
Hash join 分为两个阶段:
- 构建(build):数据库读取较小的输入,并按连接列在内存中构建哈希表。
- 探测(probe):读取较大的输入,并在哈希表中查找每一行的键。
-- build
for each row R1 in smaller_input:
    hash_table[hash(R1.key)].append(R1)

-- probe
for each row R2 in larger_input:
    for each R1 in hash_table[hash(R2.key)]:
        if R1.key = R2.key:
            output(R1, R2)
每个输入只读取一次,因此成本约为 N + M:比没有索引的 nested loop 好得多。
规划器何时使用它
- 两个大输入按等值条件连接。
- 连接列上没有可用的索引。
- 有足够的内存容纳哈希表(PostgreSQL 中的
work_mem,MySQL 中的join_buffer_size)。
| 优点 | 缺点 |
|---|---|
对没有索引的大型连接很高效:N + M | 经典 hash join 需要等值条件 |
| 不需要索引,也不需要有序输入 | 占用内存;哈希表放不下时会溢出到磁盘 |
| 必须先构建哈希表才能返回第一行 |
Merge Join
工作原理
Merge join(sort-merge join)要求两个输入都按连接列排好序。然后它同时遍历两个有序列表,就像归并排序中的合并步骤:
sort outer by key   -- skipped if read through an ordered index
sort inner by key   -- skipped if read through an ordered index

while neither input is exhausted:
    if outer.key = inner.key: output matches, advance
    elif outer.key < inner.key: advance outer
    else: advance inner
如果两个输入都能通过索引按顺序读取,排序就不需要额外成本,合并会非常快。
规划器何时使用它
- 大输入按等值条件连接。
- 两个输入已经有序,或者可以通过有序索引读取。
- 查询本来就要按连接列排序(
ORDER BY、GROUP BY、DISTINCT)。
| 优点 | 缺点 |
|---|---|
| 对预先排序或有索引的输入非常快 | 只支持等值条件 |
| 输出已按连接键排序 | 对无序输入进行显式排序代价很高 |
| 内存使用可预测 |
哪个数据库使用哪种算法
| 数据库 | Nested loop | Hash join | Merge join |
|---|---|---|---|
| PostgreSQL | 是 | 是 | 是 |
| SQL Server、Oracle | 是 | 是 | 是 |
| MySQL 8.0.18+ | 是 | 是(8.0.20 起取代 Block Nested Loop) | 否 |
| MariaDB | 是(包括 block nested loop、BKA) | 是(block hash join) | 否 |
| SQLite | 是 | 否 | 否 |
在 MySQL 中,hash join 也用于没有等值条件的连接和笛卡尔积,因此“只支持等值条件”这一规则针对的是经典算法,而不是所有实现。
在 EXPLAIN 中查看算法
EXPLAIN 显示数据库选择的计划;EXPLAIN ANALYZE(MySQL 8.0.18+、PostgreSQL)还会实际执行查询,并报告每个步骤的真实耗时:
EXPLAIN ANALYZE
SELECT a.first_name, a.last_name, f.title
FROM actor AS a
INNER JOIN film_actor AS fa ON fa.actor_id = a.actor_id
INNER JOIN film AS f ON f.film_id = fa.film_id;
结果:树形结构的执行计划。在 MySQL 中查找 Nested loop inner join 或 Inner hash join;在 PostgreSQL 中查找 Nested Loop、Hash Join 或 Merge Join。
这里 MySQL 使用的是嵌套循环:film_actor 和 film 的连接列上都有索引,因此每次查找都是索引查找。
如何帮助规划器
- 为连接中使用的外键列建立索引:这样才能使用 index nested loop。
- 尽早过滤:选择性强的
WHERE能让外侧数据变小。 - 保持统计信息最新(MySQL 中的
ANALYZE TABLE,PostgreSQL 中的ANALYZE):规划器根据估算的行数做出选择。 - 检查内存设置:如果大数据量的 hash join 溢出到磁盘,需要调整。
要点:
- Nested loop join 为每一行外表数据在内表中查找;外侧数据小且有索引时很快,并且适用于任何条件。
- Hash join 用较小的输入构建哈希表并进行探测;对没有索引的大型等值连接很高效,但会占用内存。
- Merge join 合并两个有序输入;数据已经通过索引排好序时最理想。
- MySQL 和 MariaDB 没有 merge join;PostgreSQL、SQL Server 和 Oracle 三种都有。
- 你可以通过索引、过滤条件、统计信息和内存设置影响算法的选择,并用
EXPLAIN ANALYZE进行检查。
常见问题
nested loop join 和 hash join 有什么区别?
Nested loop join 为每一行外表数据在内表中查找匹配,在有索引且外侧数据较小时很快。Hash join 只读取每个输入一次,并通过内存中的哈希表匹配行,对于两个没有可用索引的大输入更快。
MySQL 支持 hash join 吗?
支持,从 MySQL 8.0.18 开始。从 8.0.20 起,对于无法使用索引的连接,它取代了 block nested loop 算法。MySQL 没有 merge join。
可以强制使用某种连接算法吗?
标准 SQL 中不可以。一些数据库提供了提示:MySQL 的优化器提示 HASH_JOIN / NO_HASH_JOIN(取决于版本)、SQL Server 的 OPTION (HASH JOIN)、PostgreSQL 的 enable_hashjoin 等设置。可以用它们来诊断问题;对于生产环境的查询,正确的做法通常是改进索引和统计信息。