Lección 9.6 · Tiempo de lectura: ~10 min
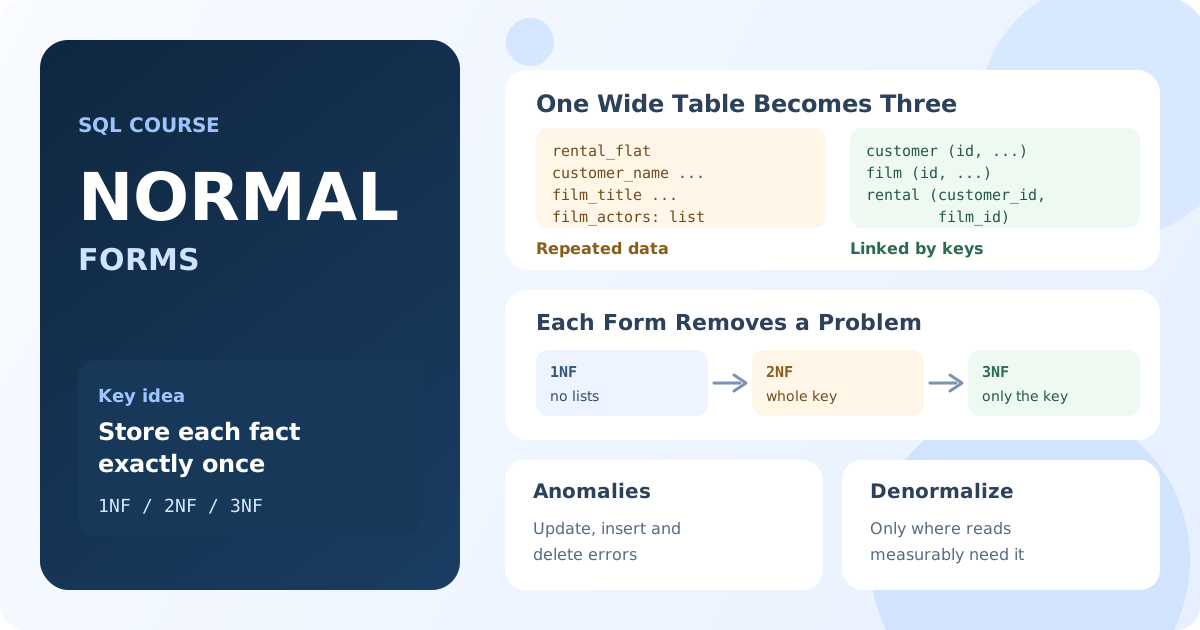
La normalización de bases de datos es una forma de diseñar las tablas para que cada hecho se guarde en un solo lugar. Una base normalizada reparte los datos en tablas relacionadas mediante claves, lo que elimina los duplicados y los errores que provocan. En esta lección conocerás las tres primeras formas normales (1FN, 2FN, 3FN) y la FNBC, verás cómo dividir una tabla ancha con SQL y sabrás cuándo duplicar datos a propósito es la mejor opción.
Normalización de bases de datos: 1FN, 2FN y 3FN
En las lecciones anteriores de este módulo creaste tablas, las modificaste y construiste vistas sobre ellas. Queda una pregunta: qué tablas crear desde el principio, qué va en una misma tabla y qué merece una tabla propia.
La normalización responde a esa pregunta con unas pocas reglas formales llamadas formas normales. Sakila es una base bien normalizada, así que sus tablas sirven de ejemplo a lo largo de la lección.
¿Qué es la normalización de bases de datos?
La normalización es el proceso de organizar columnas y tablas de modo que:
- cada tabla describa un solo tipo de entidad: un cliente, una película, un alquiler;
- cada hecho se guarde una vez y las demás tablas lo referencien por clave;
- cada columna no clave dependa de la clave de su tabla, y solo de ella.
Las reglas se agrupan en formas normales: 1FN, 2FN, 3FN, FNBC (forma normal de Boyce-Codd) y superiores. Cada forma incluye la anterior. En la práctica, un esquema en tercera forma normal (3FN) se considera normalizado; las formas superiores tratan casos poco frecuentes.
Por qué normalizar: anomalías de datos
Imagina que los alquileres se guardan en una sola tabla ancha:
| rental_id | rental_date | customer_email | customer_name | customer_city | film_title | film_actors |
|---|---|---|---|---|---|---|
| 1 | 2026-05-01 | mary@example.org | MARY SMITH | Sasebo | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
| 2 | 2026-05-02 | mary@example.org | MARY SMITH | Sasebo | ACE GOLDFINGER | BOB FAWCETT, MINNIE ZELLWEGER |
| 3 | 2026-05-02 | patricia@example.org | PATRICIA JOHNSON | San Bernardino | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
La tabla es fácil de leer, pero los datos del cliente y de la película se repiten en cada alquiler. Esto provoca tres tipos de problemas, llamados anomalías:
- Anomalía de actualización. Mary se muda a otra ciudad. Hay que actualizar todos sus alquileres; si se olvida una fila, la base tendrá dos ciudades distintas para el mismo cliente.
- Anomalía de inserción. No se puede añadir una película nueva hasta que alguien la alquile, porque cada fila es un alquiler.
- Anomalía de borrado. Al borrar el único alquiler de Patricia se borra también todo lo que se sabe de Patricia.
La normalización elimina estas anomalías llevando cada hecho a la tabla a la que pertenece.
Primera forma normal (1FN)
Una tabla está en primera forma normal cuando:
- cada columna guarda un solo valor (atómico), no una lista;
- no hay grupos de columnas repetidas como
phone1,phone2,phone3; - cada fila se puede identificar por una clave primaria.
La columna film_actors de arriba incumple la 1FN: guarda una lista de nombres en un solo valor. Una columna así es difícil de consultar. Para encontrar las películas con Penelope Guiness hay que buscar dentro del texto con LIKE, que no usa índices y encuentra por error nombres parecidos. Contar películas por actor es aún más difícil.
Sakila tiene un ejemplo real de este compromiso. En MySQL, la columna film.special_features es de tipo SET y guarda valores como Trailers,Commentaries:
SELECT special_features, COUNT(*) AS films
FROM film
GROUP BY special_features
ORDER BY films DESC
LIMIT 3;
Resultado: 15 combinaciones de cuatro extras, empezando por Trailers,Commentaries,Behind the Scenes (79 películas). Para contar películas por cada extra hay que partir estas cadenas.
La solución de la 1FN es una tabla aparte con una fila por valor. Es justo lo que hace Sakila con los actores: la tabla film_actor guarda un par (actor_id, film_id) por fila.
SELECT a.first_name, a.last_name, COUNT(*) AS films
FROM film_actor AS fa
JOIN actor AS a ON a.actor_id = fa.actor_id
GROUP BY a.actor_id, a.first_name, a.last_name
ORDER BY films DESC
LIMIT 3;
Resultado: los actores con más películas; GINA DEGENERES encabeza la lista con 42. Con una lista en una columna de texto, esta consulta sería poco práctica.
Segunda forma normal (2FN)
Una tabla está en segunda forma normal cuando está en 1FN y cada columna no clave depende de toda la clave primaria, no solo de una parte.
La 2FN solo importa en tablas con clave compuesta de varias columnas. Supongamos que film_actor también guardara nombres:
| actor_id | film_id | actor_name | film_title |
|---|---|---|---|
| 1 | 1 | PENELOPE GUINESS | ACADEMY DINOSAUR |
| 1 | 23 | PENELOPE GUINESS | ANACONDA CONFESSIONS |
La clave es (actor_id, film_id), pero actor_name depende solo de actor_id y film_title solo de film_id. Es una dependencia parcial: el nombre del actor se repite en cada una de sus películas.
La solución es mover cada columna a la tabla de cuya clave depende: los nombres a actor y los títulos a film. La tabla film_actor real guarda solo las dos claves y last_update.
Tercera forma normal (3FN)
Una tabla está en tercera forma normal cuando está en 2FN y ninguna columna no clave depende de otra columna no clave. Una cadena así, clave → columna A → columna B, se llama dependencia transitiva.
Por ejemplo, si la tabla address guardara el país:
| address_id | address | city_id | city | country |
|---|---|---|---|---|
| 5 | 1913 Hanoi Way | 463 | Sasebo | Japan |
| 6 | 1121 Loja Avenue | 449 | San Bernardino | United States |
city y country dependen de city_id, no de address_id. Cada dirección de la misma ciudad repite el nombre de la ciudad y el país, y cambiar el nombre de un país obligaría a actualizar miles de direcciones.
Sakila lo resuelve con una cadena de tablas: address guarda city_id, city guarda country_id y solo country guarda el nombre. Cada nombre se guarda una vez y la consulta los reúne con JOIN:
SELECT co.country, COUNT(*) AS customers
FROM customer AS c
JOIN address AS a ON a.address_id = c.address_id
JOIN city AS ci ON ci.city_id = a.city_id
JOIN country AS co ON co.country_id = ci.country_id
GROUP BY co.country
ORDER BY customers DESC
LIMIT 5;
Resultado: India (60), China (53), United States (36), Japan (31) y Mexico (30). Los datos normalizados se leen con joins: es el precio de guardar cada hecho una sola vez.
Una forma corta de recordar de la 1FN a la 3FN: cada columna no clave debe depender de la clave, de toda la clave y de nada más que la clave.
Forma normal de Boyce-Codd (FNBC)
La FNBC (BCNF) es una versión más estricta de la 3FN: toda columna que determina otra columna debe ser una clave candidata. La diferencia solo aparece en tablas con varias claves candidatas que se solapan, algo poco común. La mayoría de las tablas en 3FN ya están en FNBC. La cuarta y la quinta formas normales tratan de dependencias multivaluadas y casi no se discuten fuera de la teoría de bases de datos.
Cómo normalizar una tabla con SQL
Vamos a dividir la tabla ancha del principio, guardada como rental_flat, en tablas normalizadas. Ejecuta estas sentencias en tu propia base: las bases de ejemplo de SQLtest son de solo lectura. Primero, la nueva estructura:
CREATE TABLE customer_n (
    customer_id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(50) NOT NULL UNIQUE,
    name VARCHAR(90) NOT NULL,
    city VARCHAR(50) NOT NULL
);

CREATE TABLE film_n (
    film_id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL UNIQUE
);

CREATE TABLE rental_n (
    rental_id INT PRIMARY KEY,
    rental_date DATE NOT NULL,
    customer_id INT NOT NULL,
    film_id INT NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customer_n (customer_id),
    FOREIGN KEY (film_id) REFERENCES film_n (film_id)
);
Nota: esta es la sintaxis de MySQL. En PostgreSQL, sustituye INT AUTO_INCREMENT por INT GENERATED ALWAYS AS IDENTITY.
Después copiamos los datos. SELECT DISTINCT deja una fila por cliente y por película, y los alquileres encuentran sus claves con JOIN:
INSERT INTO customer_n (email, name, city)
SELECT DISTINCT customer_email, customer_name, customer_city
FROM rental_flat;

INSERT INTO film_n (title)
SELECT DISTINCT film_title
FROM rental_flat;

INSERT INTO rental_n (rental_id, rental_date, customer_id, film_id)
SELECT r.rental_id, r.rental_date, c.customer_id, f.film_id
FROM rental_flat AS r
JOIN customer_n AS c ON c.email = r.customer_email
JOIN film_n AS f ON f.title = r.film_title;
Resultado: 2 clientes, 2 películas y 3 alquileres. La ciudad de Mary ahora se guarda en una sola fila, así que un único UPDATE la cambia en todas partes.
Si SELECT DISTINCT devuelve dos filas con el mismo email, los datos ya son inconsistentes: el mismo cliente tiene nombres o ciudades distintos en distintos alquileres. La restricción UNIQUE sobre email rechazará la segunda fila y tendrás que decidir qué valor es el correcto. La normalización suele sacar a la luz problemas así.
La lista de actores pasa del mismo modo a un par de tablas, actor y film_actor. La ciudad seguiría el ejemplo de la 3FN: una tabla city aparte y una columna city_id en customer_n.
Desnormalización: cuándo se aceptan duplicados
La desnormalización consiste en guardar datos redundantes a propósito para que la lectura sea más rápida o más sencilla. Es un compromiso consciente, no un error de diseño, y la propia Sakila tiene algunos ejemplos:
paymentguardacustomer_id, aunque se puede obtener a través derental_id. El duplicado ahorra un join en los informes de pagos; los dos valores coinciden en los 16 044 pagos vinculados a un alquiler.- La tabla
film_textrepitetitleydescriptiondefilmpara la búsqueda de texto completo. - La vista
film_listdevuelve los actores como una sola cadena separada por comas. Una vista no guarda nada, así que ofrece un formato ancho cómodo sin las anomalías.
Motivos habituales para desnormalizar:
- informes y dashboards que unen muchas tablas grandes en cada petición;
- contadores y totales, como el importe total de pagos de un cliente, costosos de recalcular;
- almacenes de datos con esquema en estrella, que se cargan por lotes y rara vez se actualizan.
La regla práctica: diseña primero un esquema normalizado y desnormaliza solo los puntos concretos donde hayas medido un problema de rendimiento. Cada duplicado necesita una forma de mantenerse sincronizado: un trigger, una tarea programada o el código de la aplicación.
Conclusiones clave:
- La normalización guarda cada hecho una vez y une las tablas por claves; evita las anomalías de actualización, inserción y borrado.
- 1FN: un valor por columna, sin listas ni grupos de columnas repetidas, una clave primaria en cada tabla.
- 2FN: ninguna columna depende de una parte de una clave compuesta.
- 3FN: ninguna columna depende de otra columna no clave; "la clave, toda la clave y nada más que la clave".
- Los datos normalizados se leen con
JOIN; una vista puede mostrarlos en formato ancho. - Desnormaliza de forma deliberada y solo donde la lectura lo requiera, con un plan para mantener las copias sincronizadas.
Esta lección cierra el módulo sobre la creación y modificación de tablas. El siguiente módulo trata de escribir SQL legible y rápido: buenas prácticas, optimización de consultas e índices.
Preguntas frecuentes
¿Qué es la normalización de una base de datos?
La normalización es el proceso de organizar los datos en tablas relacionadas para que cada hecho se guarde una sola vez. Elimina los datos duplicados y las anomalías que provocan, como que un mismo cliente tenga dos direcciones distintas en filas diferentes.
¿Qué diferencia hay entre 1FN, 2FN y 3FN?
La 1FN exige valores atómicos y una clave primaria. La 2FN además prohíbe columnas que dependen solo de una parte de una clave compuesta. La 3FN además prohíbe columnas que dependen de otras columnas no clave, como el nombre de un país guardado junto al ID de una ciudad.
¿Una base normalizada es siempre mejor?
Para datos que cambian, normalmente sí: mantiene los datos coherentes y el esquema flexible. Para informes y análisis, una desnormalización controlada puede hacer las lecturas mucho más rápidas. Empieza con un esquema normalizado y desnormaliza donde hayas medido una necesidad.
¿La normalización hace más lentas las consultas?
Las lecturas necesitan más joins, lo que cuesta algo de tiempo, pero con índices en las columnas clave los joins son rápidos. Las escrituras suelen ser más rápidas, porque cada cambio actualiza una fila en lugar de muchas copias.
Preguntas de entrevista
Explica las anomalías de actualización, inserción y borrado.
Una anomalía de actualización ocurre cuando un hecho se guarda en varias filas y una actualización se salta algunas. Una anomalía de inserción ocurre cuando no se puede añadir un hecho sin datos ajenos, como una película sin alquiler. Una anomalía de borrado ocurre cuando borrar un hecho borra otro, como el único alquiler de un cliente que hace desaparecer al cliente.
¿Qué es una dependencia transitiva? Pon un ejemplo.
Es cuando una columna no clave depende de otra columna no clave en lugar de la clave. En address(address_id, city_id, city_name), city_name depende de city_id, no de address_id. La solución es una tabla city aparte, con lo que el esquema queda en 3FN.
¿Cuándo desnormalizarías un esquema?
Cuando las lecturas son mucho más frecuentes que las escrituras y los joins se han convertido en un cuello de botella medido, por ejemplo en informes, dashboards y almacenes de datos. Guarda los datos redundantes con una forma clara de sincronizarlos, como un trigger o una actualización programada.