Lección 1.5 · Tiempo de lectura: ~7 min
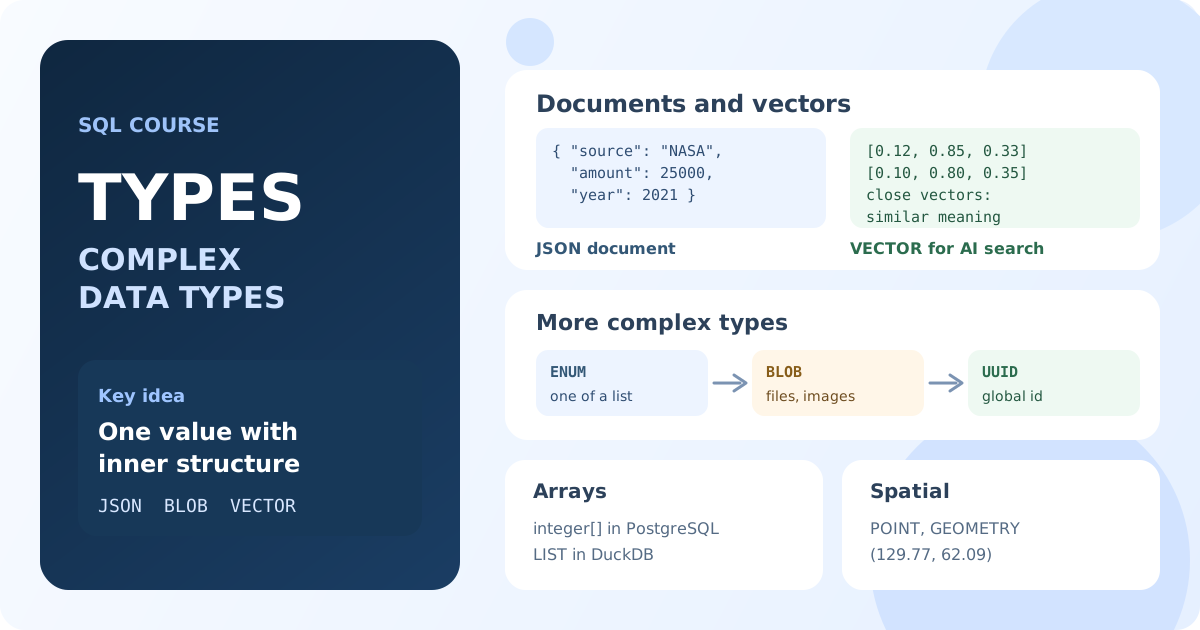
Además de números, texto y fechas, las bases de datos tienen tipos de datos complejos para valores con estructura interna: documentos, listas, archivos, identificadores únicos, ubicaciones y vectores para búsqueda con IA. Esta lección es un recorrido breve: qué guarda cada tipo, un valor de ejemplo y qué bases de datos lo admiten. No hace falta memorizar la sintaxis: el objetivo es reconocer estos tipos cuando los encuentres en una tabla.
Tipos de datos complejos en SQL
En la lección anterior cada columna guardaba un valor simple: un número, una cadena o una fecha. Algunos datos no encajan bien así: el conjunto de atributos de un producto, un contrato escaneado, un punto en un mapa. Para esos datos, las bases de datos ofrecen tipos especiales.
JSON: documentos
Una columna JSON guarda un documento entero con claves, valores, objetos anidados y listas. En la base de datos University, un proyecto de investigación guarda sus subvenciones en una sola columna JSON:
[{ "source": "Private Foundation", "amount": 244542.96, "year": 2020}]
- MySQL y MariaDB tienen el tipo
JSON; PostgreSQL tienejsony el binario, más rápido,jsonb; SQL Server y SQLite guardan el JSON como texto y lo leen con funciones JSON. - El JSON sirve para atributos que cambian de una fila a otra o que llegan de otro sistema como un documento.
XML es el formato de documentos más antiguo, con el mismo fin; PostgreSQL y SQL Server tienen un tipo xml para él.
Arrays y estructuras anidadas
Un array es una lista de valores en una celda, como [1, 2, 3]. PostgreSQL admite arrays de cualquier tipo (integer[], text[]), y las bases de datos analíticas como DuckDB añaden LIST, STRUCT y MAP. MySQL, MariaDB, SQL Server y SQLite no tienen tipo array: una lista va a un JSON o, más a menudo, a una tabla aparte, con una fila por elemento.
ENUM y SET: una lista fija de valores
ENUM permite exactamente un valor de una lista declarada junto con la columna. En Sakila, film.rating es ENUM('G', 'PG', 'PG-13', 'R', 'NC-17'), así que una película no puede recibir una clasificación fuera de esa lista. SET, un tipo de MySQL y MariaDB, permite cualquier combinación de los valores de la lista: film.special_features guarda valores como Trailers,Deleted Scenes.
PostgreSQL crea los tipos enum por separado (CREATE TYPE ... AS ENUM); otras bases de datos usan una columna normal con una comprobación o una tabla de referencia.
BLOB: datos binarios
BLOB (Binary Large Object) guarda bytes: imágenes, archivos PDF, archivos comprimidos. En Sakila, staff.picture es un MEDIUMBLOB con la foto de un empleado. El tipo se llama BLOB en MySQL, MariaDB y SQLite, bytea en PostgreSQL y VARBINARY(MAX) en SQL Server.
Los archivos grandes hacen pesadas las copias de seguridad y lenta la copia de la base de datos, por eso las aplicaciones suelen guardar los archivos en un almacenamiento de archivos y en la base solo la ruta o la URL en una columna de texto.
UUID: identificadores únicos
Un UUID es un identificador de 128 bits como a1c7abde-ccc7-11f1-92da-da8de233f452, único entre tablas, servidores y sistemas. Se usa cuando las filas se crean en muchos sitios a la vez y no se puede compartir un contador simple. PostgreSQL y MariaDB tienen un tipo uuid, SQL Server lo llama UNIQUEIDENTIFIER y MySQL guarda los UUID en CHAR(36) o BINARY(16).
Tipos espaciales: puntos y formas
Los tipos espaciales guardan geometría: puntos, líneas y polígonos. En la base de datos Bookings cada aeropuerto tiene coordinates de tipo point, como (129.77, 62.09) para Yakutsk. MySQL y MariaDB tienen GEOMETRY y POINT, SQL Server tiene geometry y geography, y PostgreSQL obtiene soporte completo con la extensión PostGIS. Las funciones espaciales miden distancias, encuentran lo que hay dentro de un área o qué objetos están más cerca.
VECTOR: embeddings para búsqueda con IA
Un VECTOR es una lista de números de longitud fija, por ejemplo [0.1, 0.2, 0.3]. Los modelos de IA convierten textos, imágenes y productos en esos vectores (embeddings), de modo que las cosas parecidas reciben vectores cercanos. Después, la base de datos puede encontrar las filas cuyos vectores están más cerca de un vector de consulta: «documentos parecidos a esta pregunta». Esa es la base de la búsqueda semántica y de las aplicaciones RAG.
- MariaDB tiene
VECTOR(n)desde la versión 11.7, con funciones comoVEC_DISTANCE_COSINE. - MySQL añadió
VECTORen la versión 9 y SQL Server en la versión 2025. - PostgreSQL obtiene vectores con la extensión pgvector.
Tipos complejos en distintas bases de datos
| Datos | MySQL | MariaDB | PostgreSQL | SQL Server | SQLite |
|---|---|---|---|---|---|
| Documento | JSON | JSON | json, jsonb, xml | texto, xml | texto |
| Lista | — | — | arrays (integer[]) | — | — |
| Lista fija de valores | ENUM, SET | ENUM, SET | CREATE TYPE ... AS ENUM | — | — |
| Datos binarios | BLOB | BLOB | bytea | VARBINARY(MAX) | BLOB |
| Identificador único | CHAR(36), BINARY(16) | UUID | uuid | UNIQUEIDENTIFIER | texto |
| Ubicación | GEOMETRY, POINT | GEOMETRY, POINT | point, PostGIS | geometry, geography | — |
| Vector | VECTOR (9.0+) | VECTOR (11.7+) | pgvector | VECTOR (2025) | — |
Cuándo usar un tipo complejo
Un tipo complejo es una buena elección cuando el valor se usa entero o necesita una búsqueda especial: un documento que se guarda y se devuelve tal cual, una foto, un embedding para la búsqueda por similitud. Si filtras, unes o cuentas a menudo por una parte del valor —una clave dentro del JSON, un elemento de un array—, esa parte suele merecer su propia columna o tabla. Así las consultas siguen siendo simples y la base de datos puede usar índices normales.
Conclusiones clave:
- Los tipos complejos guardan valores con estructura interna: documentos, listas, archivos, identificadores, ubicaciones y vectores.
JSONguarda documentos; PostgreSQL también tienejsonb, arrays yxml.ENUMySETlimitan una columna a una lista de valores declarada.BLOB,byteayVARBINARYguardan archivos binarios; los archivos grandes suelen quedarse fuera de la base de datos.UUIDda identificadores únicos entre sistemas; los tipos espaciales guardan puntos y formas.VECTORguarda embeddings de IA para la búsqueda por similitud; el soporte depende de la base de datos y de su versión.
Preguntas frecuentes
¿Debo guardar imágenes en una columna BLOB?
Las imágenes pequeñas, sí, pero los archivos grandes hacen crecer la base de datos y ralentizan las copias de seguridad. Lo habitual es guardar los archivos en un almacenamiento de archivos y su ruta en la base de datos.
¿Es mejor usar JSON o columnas separadas?
Usa columnas separadas para los datos que tiene cada fila y por los que filtras o unes. Usa JSON para atributos que cambian entre filas o que llegan como un documento ya hecho.
¿Qué es un vector en una base de datos?
Una lista de números de longitud fija que representa el significado de un texto, una imagen u otro objeto. Los objetos parecidos tienen vectores cercanos, así que la base de datos puede encontrar los más cercanos a una consulta.
Preguntas de entrevista
¿Qué tipos de datos complejos conoces y cuándo los usarías?
JSON para documentos semiestructurados, arrays para listas en PostgreSQL, ENUM para un conjunto fijo de valores, BLOB para archivos binarios, UUID para identificadores únicos globales, tipos espaciales para ubicaciones y VECTOR para embeddings en la búsqueda por similitud. Cada uno se usa cuando el valor se maneja entero o necesita sus operaciones especiales.
¿Qué desventajas tiene guardar datos en JSON en lugar de en columnas?
Los valores dentro del JSON son más difíciles de validar, restringir, unir e indexar; las consultas se alargan y los errores de tipo solo aparecen al leer los datos.
¿Por qué importan las bases de datos vectoriales en las aplicaciones de IA?
Los modelos de IA representan textos e imágenes como embeddings. Una base de datos con tipo vectorial y búsqueda de vecinos más cercanos encuentra rápido los elementos más parecidos, que es el núcleo de la búsqueda semántica y de la generación aumentada por recuperación (RAG).