Lección 10.6 · Tiempo de lectura: ~10 min
Un índice full-text (índice de texto completo) es un índice de las palabras de las columnas de texto: para cada palabra guarda las filas que la contienen. Permite encontrar filas por palabras y ordenarlas por relevancia, algo que LIKE '%palabra%' solo consigue leyendo toda la tabla. En esta lección crearás un índice full-text en MySQL, buscarás con MATCH … AGAINST en modo de lenguaje natural y en modo booleano, conocerás las reglas por las que algunas palabras no se encuentran y verás cómo resuelve PostgreSQL la misma tarea.
Índices full-text en SQL
En las lecciones anteriores viste cómo los índices B-tree aceleran la búsqueda por un valor o por el inicio de un valor. Buscar una palabra en medio de un texto es distinto: WHERE description LIKE '%astronaut%' no puede usar un índice B-tree, porque la palabra puede empezar en cualquier punto de la cadena.
Para eso existen los índices full-text. Los ejemplos de MySQL se ejecutan sobre la tabla film_text de Sakila, que ya tiene un índice full-text; la parte de PostgreSQL se comprobó en PostgreSQL 17.
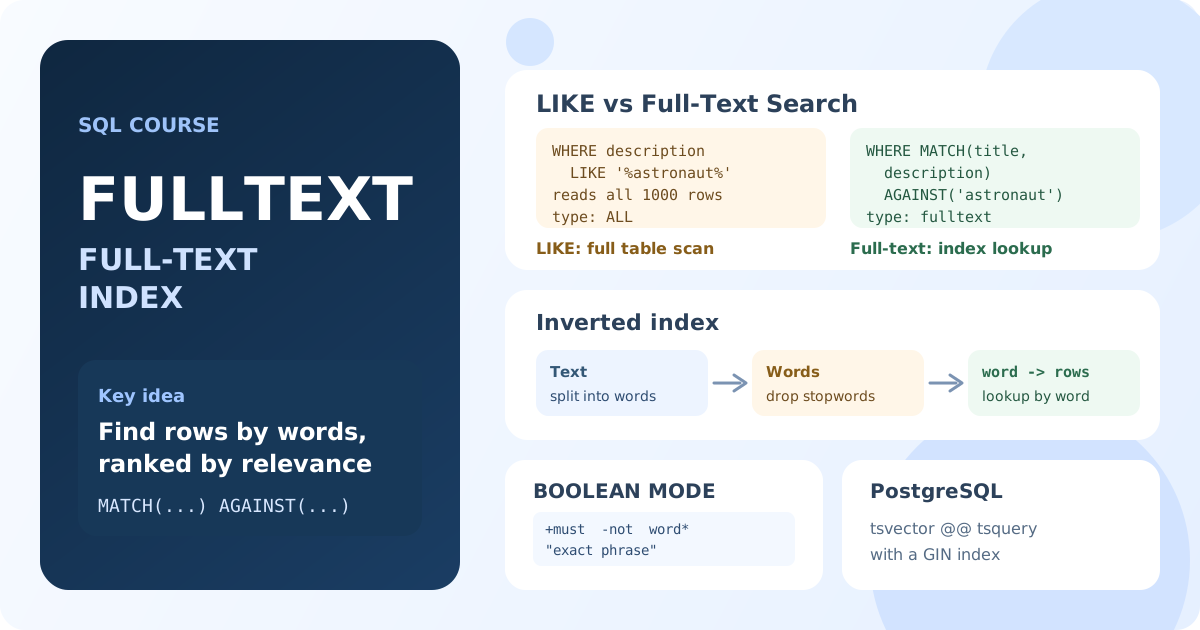
¿Qué es un índice full-text?
Al crear un índice full-text, la base de datos divide el texto en palabras (tokens), descarta las palabras demasiado cortas y las muy frecuentes como "the" o "and" (palabras vacías o stopwords) y construye un índice invertido: una lista de palabras, cada una con las filas que la contienen.
| Índice B-tree | Índice full-text | |
|---|---|---|
| Indexa | valores completos de la columna | palabras sueltas |
| Búsquedas rápidas | =, rangos, LIKE 'abc%' | palabras y frases en cualquier parte del texto |
LIKE '%palabra%' | no se usa | tampoco se usa |
| Orden del resultado | por valor | por relevancia |
| Sintaxis en MySQL | WHERE col = … | WHERE MATCH(col) AGAINST(…) |
Un índice full-text solo funciona con su propia sintaxis de búsqueda: MATCH … AGAINST en MySQL, @@ en PostgreSQL. Un LIKE normal nunca lo usa.
Crear un índice full-text en MySQL
Un índice full-text se crea sobre columnas CHAR, VARCHAR o TEXT:
CREATE FULLTEXT INDEX ft_film_description ON film (title, description);
Lo mismo se consigue con ALTER TABLE film ADD FULLTEXT INDEX ft_film_description (title, description); o dentro de CREATE TABLE. Las bases de ejemplo de SQLtest son de solo lectura, así que ejecuta estas sentencias en tu propia base.
Sakila ya tiene un índice así en film_text:
SHOW INDEX FROM film_text;
Resultado: PRIMARY (tipo BTREE) sobre film_id, e idx_title_description (tipo FULLTEXT) sobre las columnas title y description.
Buscar con MATCH … AGAINST
MATCH enumera las columnas indexadas y AGAINST las palabras que se buscan:
SELECT film_id, title,
    ROUND(MATCH(title, description) AGAINST ('astronaut crocodile'), 3) AS score
FROM film_text
WHERE MATCH(title, description) AGAINST ('astronaut crocodile')
ORDER BY score DESC
LIMIT 5;
Resultado: PHANTOM GLORY (4.239), STONE FIRE (4.196), ROAD ROXANNE, NEIGHBORS CHARADE (4.153) y LOVELY JINGLE (3.146). Las películas que contienen las dos palabras aparecen primero.
Este es el modo de lenguaje natural (natural language mode), el predeterminado. Una fila coincide si contiene cualquiera de las palabras: aquí 173 películas contienen "astronaut" o "crocodile". El mismo MATCH … AGAINST en el SELECT devuelve la puntuación de relevancia, y el resultado se puede ordenar por ella.
La lista de columnas de MATCH debe coincidir exactamente con la de un índice full-text. MATCH(description) AGAINST ('astronaut') falla con "Can't find FULLTEXT index matching the column list", porque el índice abarca title y description juntas.
Modo booleano
IN BOOLEAN MODE añade operadores para búsquedas precisas:
| Operador | Significado | Ejemplo | Películas en film_text |
|---|---|---|---|
+ | la palabra es obligatoria | '+astronaut +crocodile' | 4 |
- | la palabra no debe aparecer | '+astronaut -crocodile' | 74 |
* | prefijo | 'dino*' | 3 |
" " | frase exacta | '"mad scientist"' | 97 |
SELECT film_id, title
FROM film_text
WHERE MATCH(title, description) AGAINST ('+astronaut +crocodile' IN BOOLEAN MODE);
Resultado: 4 películas cuyo título o descripción contiene las dos palabras.
Sin operadores, el modo booleano también encuentra filas con cualquiera de las palabras, pero no las ordena por relevancia.
Búsqueda full-text frente a LIKE
Compara los planes de las dos búsquedas:
EXPLAIN SELECT film_id FROM film_text WHERE MATCH(title, description) AGAINST ('astronaut');

EXPLAIN SELECT film_id FROM film_text WHERE description LIKE '%astronaut%';
Resultado: la primera consulta usa el índice idx_title_description (tipo de acceso fulltext); la segunda lee las 1000 filas (tipo ALL).
Además, las dos búsquedas encuentran cosas distintas:
LIKE '%cat%'encuentra cualquier subcadena: "cat", pero también "category" y "Catherine". Un índice full-text encuentra palabras completas.LIKEcomprueba un patrón en una columna; la búsqueda full-text busca varias palabras en varias columnas y ordena el resultado.- En una tabla de millones de filas,
LIKE '%palabra%'lee cada fila, mientras que el índice full-text solo lee la lista de la palabra.
Reglas que sorprenden a los principiantes
Algunas palabras simplemente no se encuentran, y no es un error:
- Longitud mínima de palabra. Las palabras más cortas no se indexan: 3 caracteres en InnoDB (
innodb_ft_min_token_size), 4 en MyISAM (ft_min_word_len).film_textes una tabla MyISAM, así queAGAINST ('cat')no encuentra nada en ella, mientras que una tabla InnoDB sí encuentra "cat". - Palabras vacías. Las palabras frecuentes como "the", "a", "and" se omiten:
AGAINST ('the')devuelve 0 filas. - Sin formas de palabras en MySQL. El índice guarda las palabras tal cual: "running" no encuentra "run". Para distintas terminaciones, usa un prefijo en modo booleano:
'run*'. - La regla del 50 %. En el modo de lenguaje natural de MyISAM, una palabra que aparece en más de la mitad de las filas se considera demasiado común y se ignora.
La longitud mínima y la lista de palabras vacías se cambian en la configuración del servidor, y después hay que reconstruir el índice.
Búsqueda full-text en PostgreSQL
PostgreSQL no tiene la palabra clave FULLTEXT. El texto se convierte en un tsvector (una lista de palabras normalizadas), la consulta en un tsquery, y el operador @@ comprueba si coinciden:
SELECT to_tsvector('english', 'Runners should run slowly at first');
Resultado: 'first':6 'run':3 'runner':1 'slowli':4. Las palabras se reducen a su raíz, y "should" y "at" se descartan como palabras vacías.
Gracias a las raíces, buscar "run" también encuentra "running", y "cats" encuentra "cat", algo que MySQL no hace. Para ganar velocidad, guarda el tsvector en una columna generada e indéxalo con GIN, el tipo de índice de PostgreSQL para búsqueda full-text:
ALTER TABLE film
ADD COLUMN search tsvector
    GENERATED ALWAYS AS (to_tsvector('english', title || ' ' || description)) STORED;

CREATE INDEX film_search_idx ON film USING GIN (search);

SELECT title, ts_rank(search, query) AS rank
FROM film, websearch_to_tsquery('english', 'astronaut -crocodile') AS query
WHERE search @@ query
ORDER BY rank DESC
LIMIT 5;
Nota: websearch_to_tsquery entiende la sintaxis de los buscadores: comillas para frases, or, y - para excluir una palabra. ts_rank cumple el papel de la puntuación de relevancia de MySQL.
Otras bases de datos tienen sus propias herramientas: SQL Server usa un catálogo full-text con CONTAINS y FREETEXT, SQLite la extensión FTS5. Para buscar en millones de documentos teniendo en cuenta erratas y sinónimos, los proyectos usan motores dedicados como Elasticsearch.
Cuándo usar un índice full-text
Buenos usos:
- búsqueda por palabras en descripciones, artículos, comentarios, nombres de productos;
- "cajas de búsqueda" cuyos resultados deben ordenarse por relevancia;
- tablas grandes en las que
LIKE '%palabra%'se ha vuelto lento.
Malos usos:
- búsqueda por valor exacto o por el inicio de un valor: un índice B-tree lo hace mejor;
- códigos cortos y valores más cortos que la longitud mínima de palabra;
- búsqueda de subcadenas arbitrarias dentro de las palabras, como parte de una referencia de producto.
Conclusiones clave:
- Un índice full-text asocia cada palabra con las filas que la contienen;
LIKE '%palabra%'no usa ni un índice B-tree ni uno full-text. - En MySQL se crea con
FULLTEXT INDEXy se busca conMATCH(columnas) AGAINST('palabras'); las columnas deben coincidir exactamente con el índice. - El modo de lenguaje natural devuelve filas con cualquiera de las palabras, ordenadas por relevancia; el modo booleano añade
+,-,*y frases. - Las palabras cortas y las palabras vacías no se indexan, y MySQL no tiene en cuenta las formas de las palabras: "running" no encuentra "run".
- PostgreSQL usa
tsvector,tsquery, el operador@@y un índice GIN, y sí tiene en cuenta las formas de las palabras.
Preguntas frecuentes
¿Qué es un índice full-text en SQL?
Es un índice de las palabras de las columnas de texto: para cada palabra, la base de datos guarda las filas que la contienen. Hace que la búsqueda por palabras sea rápida y permite ordenar los resultados por relevancia.
¿Por qué LIKE '%palabra%' no usa índices?
Un índice B-tree está ordenado por el inicio del valor, y un patrón que empieza con % puede coincidir en cualquier parte de la cadena, así que la base de datos tiene que leer cada fila. La búsqueda full-text con MATCH … AGAINST o @@ usa un índice full-text.
¿Por qué mi búsqueda full-text no encuentra nada con una palabra corta?
Las palabras más cortas que la longitud mínima (3 caracteres en InnoDB, 4 en MyISAM) y las palabras vacías como "the" no se indexan. Busca una palabra más larga, usa otro método o cambia la configuración del servidor y reconstruye el índice.
¿Qué diferencia hay entre el modo de lenguaje natural y el modo booleano?
El modo de lenguaje natural encuentra filas con cualquiera de las palabras y las ordena por relevancia. El modo booleano entiende operadores: + para una palabra obligatoria, - para excluir una palabra, * para un prefijo y comillas para una frase.
Preguntas de entrevista
¿En qué se diferencia un índice full-text de un índice B-tree?
Un índice B-tree guarda los valores completos de la columna ordenados y sirve para búsquedas por igualdad, rango y prefijo. Un índice full-text guarda palabras sueltas con las filas que las contienen y sirve para buscar palabras y frases en cualquier parte del texto, con ordenación por relevancia.
¿Cómo acelerarías una búsqueda con LIKE '%palabra clave%' en una tabla grande?
Añadiría un índice full-text sobre las columnas en las que se busca y reescribiría la consulta con MATCH … AGAINST en MySQL, o con una columna tsvector, un índice GIN y @@ en PostgreSQL. También comprobaría que las palabras buscadas no son más cortas que la longitud mínima ni son palabras vacías.
¿Por qué una búsqueda full-text puede devolver menos filas que LIKE?
La búsqueda full-text encuentra palabras completas, mientras que LIKE encuentra subcadenas, así que "cat" con LIKE también encuentra "category". Las palabras cortas, las palabras vacías y, en MySQL, las otras formas de las palabras no las encuentra el índice full-text.