Mayúsculas y minúsculas en SQL según el SGBD
Lección 1.9 · Tiempo de lectura: ~9 min
La distinción entre mayúsculas y minúsculas en SQL tiene tres niveles: palabras clave, nombres de objetos y datos. Las palabras clave como SELECT no distinguen mayúsculas en ningún SGBD, pero que Customer y customer sean la misma tabla depende del SGBD, de las comillas y a veces incluso del sistema operativo. En esta lección conocerás las reglas de cada SGBD popular, la trampa clásica de los nombres entre comillas, cómo tratan la caja las comparaciones de cadenas y un estilo de nombres que evita todos estos problemas.
En la lección 1.8 viste que los SGBD siguen el estándar SQL con sus propios dialectos. La caja de las letras es una de las diferencias más visibles: una consulta que funciona en SQL Server puede fallar en PostgreSQL con relation "Customer" does not exist, y una consulta escrita en un portátil con Windows puede fallar en un servidor Linux.
Conocer las reglas antes de tus primeras consultas te ahorra horas buscando una tabla que «seguro que existe».
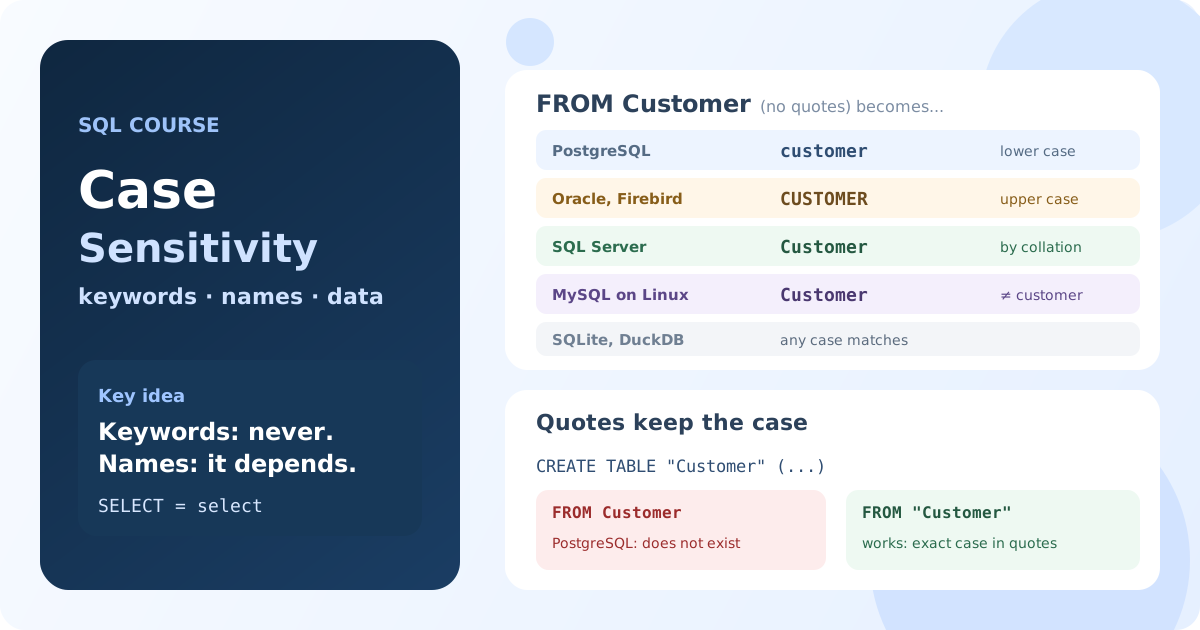
Tres niveles de caja en SQL
Cuando alguien pregunta «¿SQL distingue mayúsculas y minúsculas?», puede referirse a tres cosas distintas:
- Palabras clave y nombres de funciones:
SELECT,select,COUNT,count. - Identificadores: los nombres de bases de datos, tablas, columnas y alias, que conociste en la lección 1.7.
- Datos: si la cadena
'abc'es igual a'ABC'en una condiciónWHERE.
Cada nivel tiene sus propias reglas, así que veámoslos uno por uno.
Las palabras clave de SQL no distinguen mayúsculas
Las palabras clave y los nombres de las funciones integradas se pueden escribir en cualquier caja en todos los SGBD:
sElEcT title
FrOm film
WhErE film_id = 1;
Resultado: ACADEMY DINOSAUR. MySQL, PostgreSQL, SQL Server, Oracle, Firebird y SQLite ejecutan la consulta con cualquier mezcla de cajas.
Escribir las palabras clave en MAYÚSCULAS es solo una convención: separa el lenguaje de los nombres de tablas y columnas y hace que las consultas largas se lean mejor. Este curso escribe las palabras clave en mayúsculas y los nombres en minúsculas, y la mayoría de las guías de estilo recomiendan lo mismo.
Identificadores sin comillas: cada SGBD los convierte a su manera
El estándar SQL dice que un nombre sin comillas se convierte a mayúsculas, así que customer, Customer y CUSTOMER son el mismo nombre. Los SGBD aplican esta idea de formas distintas.
PostgreSQL: los nombres pasan a minúsculas
PostgreSQL convierte todo nombre sin comillas a minúsculas, justo lo contrario del estándar:
SELECT Model, AIRCRAFT_CODE
FROM Aircrafts
WHERE aircraft_code = '773';
Resultado: Boeing 777-300. La tabla se guarda como aircrafts, y los encabezados de las columnas vuelven como model y aircraft_code.
Los alias también se convierten: SELECT model AS TotalModel devuelve una columna llamada totalmodel. La caja que escribiste desaparece en cuanto se analiza la consulta.
Oracle y Firebird: los nombres pasan a mayúsculas
Oracle y Firebird siguen el estándar y convierten los nombres sin comillas a mayúsculas:
select first_name, Last_Name
from Employee
where emp_no = 2;
Resultado en Firebird: Robert Nelson, con los encabezados FIRST_NAME y LAST_NAME. En Oracle ocurre lo mismo con hr.Employees.
Por eso las herramientas muestran las tablas de Oracle y Firebird en mayúsculas: EMPLOYEES, EMPLOYEE.
SQL Server: decide la collation
SQL Server no convierte los nombres. Conserva la caja usada en CREATE TABLE y compara los nombres según la collation de la base de datos: el conjunto de reglas para comparar texto.
La collation por defecto, como SQL_Latin1_General_CP1_CI_AS, no distingue mayúsculas (CI), así que estos nombres son iguales:
select name, listprice
from PRODUCT
where productid = 680;
Resultado: HL Road Frame - Black, 58. En AdventureWorks los encabezados vuelven tal como los escribiste: name y listprice.
Una base de datos creada con una collation que distingue mayúsculas (_CS_) trata Product y PRODUCT como nombres distintos. Son raras, pero existen, así que comprueba DATABASEPROPERTYEX(DB_NAME(), 'Collation') antes de suponer nada.
MySQL y MariaDB: los nombres de tablas siguen al sistema operativo
En MySQL y MariaDB una base de datos es una carpeta y una tabla es un archivo, así que las reglas de caja de bases y tablas vienen del sistema de archivos. Las controla el parámetro lower_case_table_names:
| Valor | Por defecto en | Nombres de tablas |
|---|---|---|
0 | Linux | se guardan tal cual, se comparan distinguiendo mayúsculas |
1 | Windows | se guardan en minúsculas, se comparan sin distinguir |
2 | macOS | se guardan tal cual, se comparan sin distinguir |
El entorno de pruebas de este curso funciona en Linux, así que una caja incorrecta en el nombre de una tabla es un error:
SELECT title
FROM FILM
WHERE film_id = 1;
Resultado: Table 'sakila.FILM' doesn't exist. Con FROM film la consulta funciona.
En Linux, Customer y customer pueden ser incluso dos tablas distintas en la misma base de datos. Los alias de tabla siguen la misma regla: FROM film F con WHERE f.film_id = 1 falla con Unknown column 'f.title'.
En cambio, los nombres de columnas no distinguen mayúsculas en MySQL y MariaDB en ningún sistema: SELECT TITLE, Film_ID FROM film funciona.
SQLite y DuckDB: nunca distinguen
SQLite y DuckDB comparan los nombres sin distinguir mayúsculas, incluso entre comillas, y recuerdan la caja con la que se creó el objeto:
CREATE TEMP TABLE "Customer" ("FullName" text);
INSERT INTO "Customer" VALUES ('Orlando Gee');

SELECT fullname
FROM CUSTOMER;
Resultado en SQLite y DuckDB: Orlando Gee bajo el encabezado FullName. No se puede crear una segunda tabla llamada customer: el nombre ya está ocupado.
Los identificadores entre comillas conservan la caja
Las comillas convierten un nombre en un identificador delimitado: el SGBD lo usa exactamente como está escrito, con su caja, sus espacios y sus palabras reservadas. El estándar usa comillas dobles; MySQL usa acentos graves, y SQL Server también acepta corchetes:
| SGBD | Nombre entre comillas |
|---|---|
| PostgreSQL, Oracle, Firebird, SQLite, DuckDB | "Customer" |
| MySQL, MariaDB | `Customer` |
| SQL Server | [Customer] o "Customer" |
En PostgreSQL, Oracle y Firebird un nombre entre comillas distingue mayúsculas. Ese es el origen del error de caja más frecuente.
La trampa "Customer" en PostgreSQL
Muchas herramientas, ORM y scripts de migración crean tablas con nombres entre comillas. Esto es lo que pasa después:
CREATE TEMP TABLE "Customer" ("CustomerID" int, "FullName" text);
INSERT INTO "Customer" VALUES (1, 'Orlando Gee');

SELECT *
FROM Customer;
Resultado: relation "customer" does not exist. El Customer sin comillas se convirtió en customer, pero la tabla se llama Customer.
Si un nombre se creó con comillas y mayúsculas, cada consulta también debe ponerlo entre comillas, exactamente con la misma caja:
SELECT "FullName"
FROM "Customer";
Resultado: Orlando Gee. Sin comillas, SELECT FullName falla con column "fullname" does not exist.
PostgreSQL incluso da una pista: Perhaps you meant to reference the column "Customer.FullName". Oracle y Firebird tienen el problema inverso: hr."employees" falla, porque la tabla se guarda como EMPLOYEES.
En MySQL las comillas dobles son una cadena
En MySQL y MariaDB las comillas dobles ni siquiera indican un nombre: por defecto marcan una cadena, como las comillas simples:
SELECT "title"
FROM film
WHERE film_id = 1;
Resultado: la palabra title, no el título de la película. MySQL devuelve la constante de texto 'title' en cada fila.
La consulta no falla, así que el error pasa desapercibido con facilidad. Usa acentos graves para los nombres en MySQL o activa el modo ANSI_QUOTES para que las comillas dobles sigan el estándar.
La caja en los datos: comparar cadenas
El tercer nivel son los propios datos. Que 'abc' = 'ABC' sea verdadero depende del SGBD y de la collation de la columna:
| SGBD | 'abc' = 'ABC' por defecto | LIKE | Búsqueda sin distinguir mayúsculas |
|---|---|---|---|
| MySQL, MariaDB | verdadero | no distingue | ya por defecto; BINARY o una collation _bin para exacta |
| SQL Server | verdadero (collation CI) | no distingue | ya por defecto; COLLATE ..._CS_AS para exacta |
| PostgreSQL | falso | distingue | ILIKE, LOWER() |
| Oracle | falso | distingue | UPPER(), LOWER() |
| Firebird | falso | distingue | CONTAINING, UPPER() |
| SQLite | falso | no distingue (letras latinas) | COLLATE NOCASE, LOWER() |
| DuckDB | falso | distingue | ILIKE, COLLATE NOCASE |
La misma condición da resultados distintos. En PostgreSQL la base de datos Bookings no tiene la ciudad 'moscow':
SELECT COUNT(*)
FROM airports
WHERE city = 'moscow';
Resultado: 0. Con WHERE lower(city) = 'moscow' o WHERE city ILIKE 'moscow' la consulta encuentra 3 aeropuertos de Moscú.
En MySQL la consulta parecida sobre Sakila encuentra los actores a la primera:
SELECT COUNT(*)
FROM actor
WHERE last_name = 'davis';
Resultado: 3, aunque los apellidos se guardan como DAVIS. Con WHERE BINARY last_name = 'davis' el resultado es 0.
Por eso una consulta llevada de MySQL o SQL Server a PostgreSQL puede devolver menos filas sin avisar. Cuando la caja de los datos no importa, dilo en la consulta: compara LOWER(columna) con un valor en minúsculas. Las collations hacen mucho más que tratar la caja: también definen la ordenación y los acentos, y tendrán su propia lección más adelante en el curso.
La caja en cada SGBD
| SGBD | Nombres sin comillas | Nombres entre comillas | 'abc' = 'ABC' |
|---|---|---|---|
| PostgreSQL | minúsculas | distinguen mayúsculas | falso |
| Oracle | mayúsculas | distinguen mayúsculas | falso |
| Firebird | mayúsculas | distinguen mayúsculas | falso |
| SQL Server | tal como se escriben, se comparan según la collation (normalmente sin distinguir) | igual que sin comillas | verdadero con una collation CI |
| MySQL, MariaDB | tablas y bases: dependen de lower_case_table_names (distinguen en Linux); columnas: no distinguen | igual que sin comillas | verdadero |
| SQLite | no distinguen | no distinguen | falso |
| DuckDB | no distinguen | no distinguen | falso |
Las palabras clave y los nombres de funciones no distinguen mayúsculas en ninguno de ellos.
Reglas de nombres que evitan problemas de caja
No hace falta recordar toda la tabla si sigues unas pocas reglas:
- Nombra las tablas y columnas en minúsculas con guiones bajos:
customer_order,total_amount. Estos nombres significan lo mismo en cualquier SGBD y nunca necesitan comillas. - No crees nombres entre comillas con mayúsculas o espacios. Si una herramienta los creó, ponlos entre comillas en todas partes con la caja exacta.
- Escribe cada nombre siempre con la misma caja, incluso donde el SGBD lo perdona: así una consulta escrita en Windows o en SQL Server también funcionará en Linux y en PostgreSQL.
- Escribe las palabras clave en mayúsculas por legibilidad; al SGBD le da igual.
- En las condiciones sobre texto, decide si la caja importa y déjalo explícito con
LOWER(),UPPER()oILIKE, en lugar de confiar en la collation por defecto.
Más consejos sobre nombres se reúnen en la lección 10.1. Con estas reglas en mente estás listo para el siguiente módulo, donde empezarás a consultar datos con SELECT.
Conclusiones clave:
- Las palabras clave y los nombres de funciones de SQL no distinguen mayúsculas en ningún SGBD; las mayúsculas son una convención de estilo.
- Los nombres sin comillas se convierten a minúsculas en PostgreSQL y a mayúsculas en Oracle y Firebird; SQL Server los compara según la collation de la base de datos.
- En MySQL y MariaDB los nombres de tablas distinguen mayúsculas en Linux (
lower_case_table_names = 0), y los de columnas no. - Un nombre entre comillas conserva la caja: una tabla creada como
"Customer"en PostgreSQL siempre debe escribirse como"Customer". 'abc' = 'ABC'es verdadero por defecto en MySQL y SQL Server y falso en PostgreSQL, Oracle, Firebird, SQLite y DuckDB.- Los nombres en
snake_caseen minúsculas y sin comillas funcionan igual en todas partes.
Preguntas frecuentes
¿SQL distingue mayúsculas y minúsculas?
Las palabras clave no: SELECT y select son lo mismo en todas partes. Los nombres de tablas y columnas dependen del SGBD: PostgreSQL, Oracle y Firebird convierten los nombres sin comillas a una sola caja, SQL Server usa la collation y los nombres de tablas de MySQL siguen al sistema operativo. Las comparaciones de cadenas dependen de la collation de los datos.
¿Los nombres de tablas distinguen mayúsculas en MySQL?
En Linux, sí: con el valor por defecto lower_case_table_names = 0, FILM y film son tablas distintas. En Windows y macOS son la misma. Los nombres de columnas no distinguen mayúsculas en ningún sistema, así que, por seguridad, nombra las tablas en minúsculas.
¿Por qué PostgreSQL dice que la relation no existe si la tabla está ahí?
Lo más probable es que la tabla se creara con un nombre entre comillas y con mayúsculas, como "Customer". PostgreSQL convierte el Customer sin comillas de tu consulta en customer, que es otro nombre. Escribe el nombre entre comillas dobles con la caja exacta: FROM "Customer".
¿Cómo hago una búsqueda sin distinguir mayúsculas en PostgreSQL?
Usa ILIKE en lugar de LIKE (WHERE city ILIKE 'moscow') o compara valores en minúsculas: WHERE lower(city) = 'moscow'. Para búsquedas frecuentes, un índice sobre lower(city) hace rápida la segunda variante.
¿Hay que escribir las palabras clave de SQL en mayúsculas?
Al SGBD le da igual, así que es una cuestión de estilo. Palabras clave en mayúsculas y nombres en minúsculas es la convención más común, porque deja ver la estructura de la consulta. Lo importante es ser coherente dentro de un proyecto.