Versiones del estándar SQL y dialectos SQL
Lección 1.8 · Tiempo de lectura: ~8 min
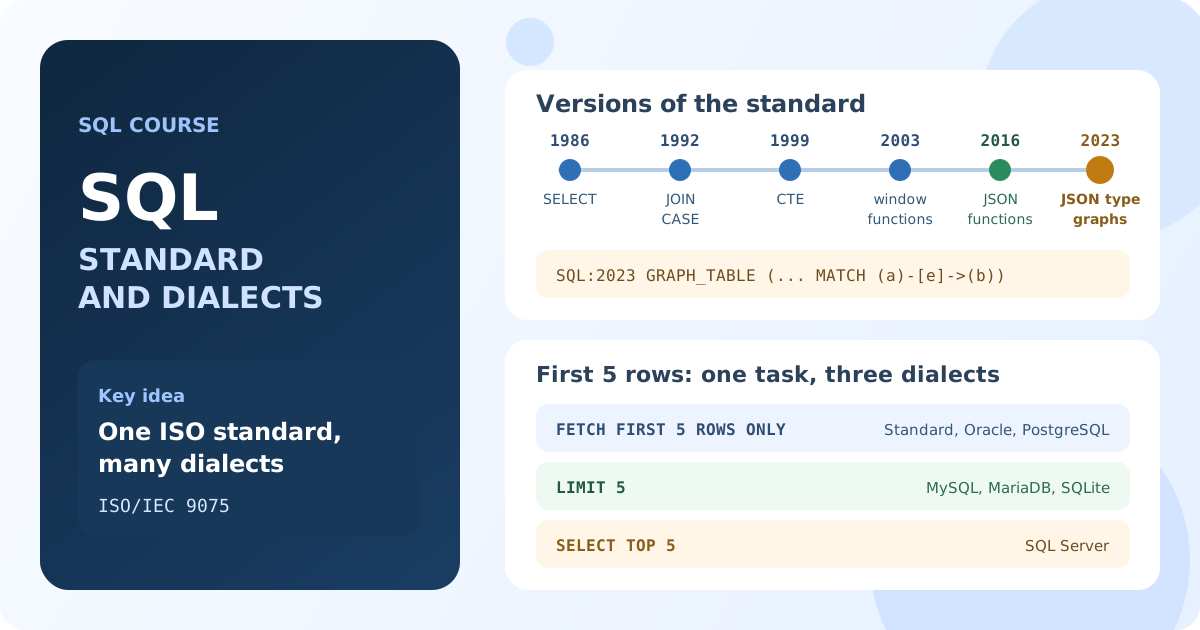
El estándar SQL es la especificación internacional del lenguaje SQL, publicada por ISO y ANSI como ISO/IEC 9075. La primera versión apareció en 1986 y la más reciente es SQL:2023. En esta lección verás qué añadió cada versión del estándar, desde la sintaxis explícita de JOIN hasta JSON y las consultas de grafos, y por qué cada base de datos habla su propio dialecto SQL. Al final sabrás qué partes de una consulta son portables y cuáles dependen de la base de datos.
En la lección anterior viste qué es SQL y cómo se construye una consulta básica. SQL no pertenece a un solo fabricante: su núcleo lo define un estándar, y cada base de datos implementa ese estándar a su manera.
Esto explica una sorpresa habitual: una consulta que funciona en PostgreSQL puede fallar en SQL Server o en MySQL. Conocer el estándar ayuda a escribir consultas que pasan de una base de datos a otra con menos cambios.
¿Qué es el estándar SQL?
SQL se creó en IBM en los años 70. A mediados de los 80 varios fabricantes tenían sus propias versiones del lenguaje, así que ANSI y después ISO publicaron una especificación común: SQL-86. Desde entonces el comité ISO/IEC JTC 1/SC 32 revisa el estándar con regularidad.
El estándar es extenso y se divide en varias partes. La Parte 2, SQL/Foundation, define el núcleo del lenguaje: tablas, consultas, modificación de datos y transacciones. Otras partes cubren XML, datos externos, arrays multidimensionales y, desde 2023, grafos de propiedades.
Conviene saber algunas cosas:
- El estándar define un conjunto obligatorio de funciones llamado Core SQL; todo lo demás es opcional.
- Ninguna base de datos implementa el estándar completo, y cada una añade sus propias extensiones.
- Los documentos del estándar son de pago, así que en la práctica SQL se aprende con la documentación de cada base de datos.
Versiones del estándar SQL y qué añadieron
Cada versión conservó las anteriores y añadió funciones nuevas. La tabla muestra los cambios que encontrarás en este curso:
| Versión | Principales novedades | En este curso |
|---|---|---|
| SQL-86, SQL-89 | SELECT, INSERT, UPDATE, DELETE, CREATE TABLE, claves primarias y foráneas | Módulo 2 |
| SQL-92 | JOIN ... ON explícito, LEFT, RIGHT y FULL OUTER JOIN, CASE, CAST, tipos DATE y TIMESTAMP | JOIN, CASE |
| SQL:1999 | WITH y consultas recursivas (CTE), BOOLEAN, triggers, ROLLUP y CUBE | CTE, CTE recursivas |
| SQL:2003 | funciones de ventana, MERGE, columnas de identidad, secuencias, SQL/XML | Funciones de ventana |
| SQL:2006 | consultas a XML con XQuery | - |
| SQL:2008 | FETCH FIRST n ROWS ONLY, OFFSET, TRUNCATE TABLE | LIMIT y FETCH FIRST |
| SQL:2011 | tablas temporales (historial de filas), LAG, LEAD, FIRST_VALUE, LAST_VALUE | LAG y LEAD |
| SQL:2016 | funciones JSON (JSON_VALUE, JSON_QUERY, JSON_TABLE), LISTAGG, MATCH_RECOGNIZE | Funciones JSON |
| SQL:2019 | arrays multidimensionales (SQL/MDA) | - |
| SQL:2023 | tipo de datos JSON, consultas de grafos de propiedades (SQL/PGQ), GREATEST, LEAST, ANY_VALUE | Tipos de datos complejos |
SQL-92 sigue siendo un punto de referencia importante: definió la sintaxis que admite casi cualquier base de datos relacional. Pero el estándar moderno es mucho más rico, y la mayoría de las funciones del SQL analítico apareció después de 1999.
Novedades de SQL:2023: JSON y consultas de grafos
SQL:2023 permite que una misma base de datos trabaje con datos relacionales, documentos y grafos en la misma consulta.
El tipo de datos JSON
SQL:2016 añadió funciones que leen JSON guardado como texto. SQL:2023 añade un tipo JSON propiamente dicho: la base de datos comprueba que la columna contiene JSON válido y puede guardarlo en un formato binario eficiente. MySQL, MariaDB y PostgreSQL (jsonb) tenían sus propios tipos JSON antes del estándar; Oracle, desde la versión 21c, sigue el tipo estándar.
Consultas de grafos de propiedades (SQL/PGQ)
Un grafo de propiedades es un conjunto de vértices y aristas, por ejemplo actores y películas unidos por "actuó en". Las bases de datos de grafos como Neo4j consultan estos datos con lenguajes propios. SQL/PGQ, la nueva Parte 16 del estándar, permite definir un grafo sobre tablas normales y consultarlo en SQL.
En Sakila, actor y film pasan a ser vértices y film_actor, la arista entre ellos:
CREATE PROPERTY GRAPH film_graph
  VERTEX TABLES (actor KEY (actor_id), film KEY (film_id))
  EDGE TABLES (
    film_actor KEY (actor_id, film_id)
      SOURCE KEY (actor_id) REFERENCES actor (actor_id)
      DESTINATION KEY (film_id) REFERENCES film (film_id)
      LABEL acted_in
  );
Nota: el grafo no copia datos; describe cómo se relacionan las tablas existentes.
El operador GRAPH_TABLE busca caminos según un patrón. Esta consulta devuelve los actores que trabajaron en alguna película con Penelope Guiness:
SELECT DISTINCT partner
FROM GRAPH_TABLE (film_graph
  MATCH (a IS actor) -[IS acted_in]-> (f IS film) <-[IS acted_in]- (b IS actor)
  WHERE a.first_name = 'PENELOPE'
    AND a.last_name = 'GUINESS'
    AND b.actor_id <> a.actor_id
  COLUMNS (b.first_name || ' ' || b.last_name AS partner)
);
Resultado: una fila por cada compañero de reparto. El patrón se lee como el dibujo: actor → película ← actor.
El mismo resultado se puede obtener con dos uniones de film_actor, que aprenderás en el módulo de JOIN. Para caminos más largos, como "actores conectados a través de dos películas", la sintaxis de grafos es mucho más corta. Hoy SQL/PGQ lo admite Oracle Database 23ai; el soporte en PostgreSQL está en desarrollo.
Dialectos SQL: en qué se apartan las bases de datos del estándar
Un dialecto SQL es la versión de SQL que implementa una base de datos concreta: las funciones del estándar que admite más sus propias extensiones. Las consultas básicas se ven iguales en todas partes, pero los detalles cambian. Por ejemplo, las cinco películas más largas en distintas bases de datos:
-- Estándar (PostgreSQL, Oracle)
SELECT title, length
FROM film
ORDER BY length DESC
FETCH FIRST 5 ROWS ONLY;

-- MySQL, MariaDB, SQLite, PostgreSQL
SELECT title, length
FROM film
ORDER BY length DESC
LIMIT 5;

-- SQL Server
SELECT TOP 5 title, length
FROM film
ORDER BY length DESC;
Resultado: las mismas cinco películas en todos los casos. LIMIT y TOP aparecieron antes que el FETCH FIRST estándar y siguen siendo más habituales.
Otras diferencias frecuentes:
| Tarea | Estándar | MySQL / MariaDB | PostgreSQL | SQL Server | Oracle | SQLite |
|---|---|---|---|---|---|---|
| Primeras N filas | FETCH FIRST | LIMIT | LIMIT, FETCH FIRST | TOP, OFFSET ... FETCH | FETCH FIRST | LIMIT |
| Concatenar cadenas | a || b | CONCAT(a, b) | a || b | a + b, CONCAT | a || b | a || b |
| Poner un nombre entre comillas | "name" | `name` | "name" | [name], "name" | "name" | "name" |
| Clave autoincremental | GENERATED AS IDENTITY | AUTO_INCREMENT | GENERATED AS IDENTITY, SERIAL | IDENTITY(1, 1) | GENERATED AS IDENTITY | INTEGER PRIMARY KEY |
| CTE recursiva | WITH RECURSIVE | WITH RECURSIVE | WITH RECURSIVE | WITH | WITH | WITH RECURSIVE |
| Tipo booleano | BOOLEAN | BOOLEAN = TINYINT(1) | BOOLEAN | BIT | BOOLEAN (23ai) | 0 y 1 |
FULL OUTER JOIN | sí | no | sí | sí | sí | sí (3.39+) |
PostgreSQL suele considerarse la más cercana al estándar. MySQL es la que más se aparta, aunque sus versiones recientes incorporaron CTE, funciones de ventana y otras funciones estándar.
Cómo escribir SQL portable
Llevar un esquema a otra base de datos siempre exige algo de trabajo, pero algunos hábitos mantienen las consultas más cerca del estándar:
- Prefiere las construcciones estándar cuando la base de datos las admite:
CASEen lugar deIF(),COALESCEen lugar deIFNULLoISNULL,JOIN ... ONexplícito. - Usa
CAST(x AS type)en lugar de atajos comox::typede PostgreSQL. - Evita los nombres entre comillas: los nombres en minúsculas y sin espacios no las necesitan en ninguna base de datos.
- Deja las partes propias de cada base de datos, como el límite de filas o las funciones de fecha, en lugares bien señalados.
En este sitio las mismas tareas se pueden resolver en varias bases de datos, así que verás estas diferencias en la práctica. El próximo módulo empieza a escribir consultas con SELECT, la sentencia detrás de toda lectura de datos.
Conclusiones clave:
- El estándar SQL es ISO/IEC 9075; empezó con SQL-86 y la versión actual es SQL:2023.
- SQL-92 definió la base común, SQL:1999 y SQL:2003 añadieron CTE y funciones de ventana, SQL:2016 añadió funciones JSON.
- SQL:2023 añade el tipo
JSONy las consultas de grafos de propiedades (SQL/PGQ) sobre tablas normales. - Un dialecto SQL es el estándar tal como lo implementa una base de datos, más sus extensiones.
- Las consultas básicas son portables; lo que más cambia es el límite de filas, las funciones de cadenas, el autoincremento y las comillas.
Preguntas frecuentes
¿Cuál es la versión más reciente del estándar SQL?
La versión más reciente es SQL:2023 (ISO/IEC 9075:2023), publicada en junio de 2023. Añadió el tipo de datos JSON, las consultas de grafos de propiedades (SQL/PGQ) y varias funciones menores, como GREATEST, LEAST y ANY_VALUE.
¿Qué diferencia hay entre ANSI SQL e ISO SQL?
Hoy son el mismo estándar. ANSI publicó la primera versión en 1986, ISO la adoptó en 1987 y desde entonces ANSI adopta el estándar ISO/IEC 9075. "ANSI SQL" es solo el nombre habitual del SQL estándar.
¿Alguna base de datos admite el estándar SQL completo?
No. Cada base de datos admite Core SQL y un conjunto distinto de funciones opcionales, y añade sus propias extensiones. PostgreSQL suele considerarse la más cercana al estándar.
¿Todavía vale la pena aprender SQL-92?
La sintaxis de SQL-92 es la base que funciona en casi cualquier base de datos, así que es un buen comienzo. Pero el SQL moderno también incluye CTE, funciones de ventana y JSON, y el trabajo analítico los usa a diario.
Preguntas de entrevista
¿Qué es un dialecto SQL?
Un dialecto SQL es la versión de SQL que implementa una base de datos concreta: una parte del estándar ISO más las extensiones del fabricante. Ejemplos son T-SQL en SQL Server y los dialectos SQL de Oracle, MySQL y PostgreSQL. La sintaxis básica es común; cambian detalles como el límite de filas, las funciones y los tipos de datos.
Menciona algunas diferencias entre la sintaxis de MySQL y la de SQL Server.
MySQL limita las filas con LIMIT y SQL Server con TOP u OFFSET ... FETCH. MySQL concatena cadenas con CONCAT, SQL Server también con +; MySQL pone los nombres entre comillas invertidas y SQL Server entre corchetes. Las claves autoincrementales son AUTO_INCREMENT en MySQL e IDENTITY en SQL Server.
¿Qué añadió SQL:2023 al estándar?
Un tipo de datos JSON nativo y SQL/PGQ, consultas de grafos de propiedades sobre tablas relacionales con CREATE PROPERTY GRAPH y GRAPH_TABLE. También añadió funciones menores como GREATEST, LEAST y ANY_VALUE.
¿Cómo se hace portable una consulta SQL entre bases de datos?
Usando construcciones estándar: JOIN ... ON explícito, CASE, COALESCE, CAST. Hay que evitar las funciones propias de un fabricante y los identificadores entre comillas, y aislar las partes que deben ser distintas, como el límite de filas y las funciones de fecha.