Leçon 4.1 · Temps de lecture : ~8 minutes
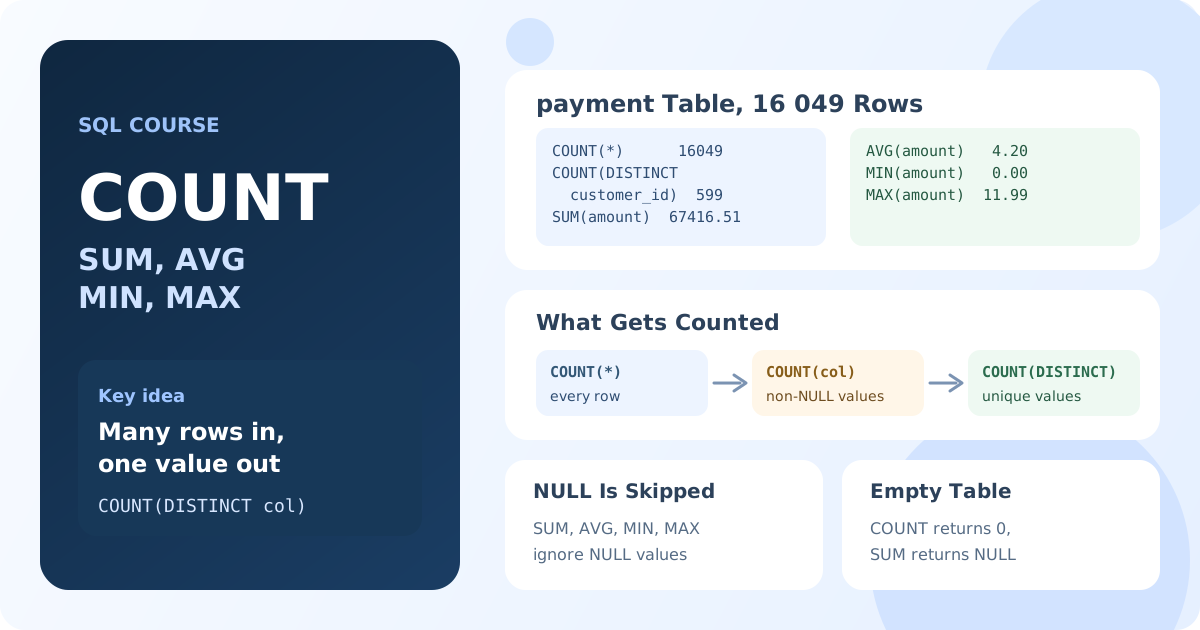
Les fonctions d'agrégation SQL permettent de transformer un ensemble de lignes en indicateurs de synthèse: nombre, somme, moyenne, minimum et maximum. Dans cette leçon, vous allez travailler les agrégats les plus utilisés avec des exemples Sakila et apprendre à choisir le bon type de comptage selon le besoin. À la fin, vous saurez utiliser COUNT, SUM, AVG, MIN et MAX avec assurance en SQL analytique.
Fonctions d'agrégation de base en SQL
Dans les leçons précédentes, vous récupériez surtout des lignes détaillées. Nous passons maintenant à une étape clé: produire des valeurs de synthèse à partir des données.
Les fonctions d'agrégation sont essentielles en reporting et en analyse, car elles répondent rapidement à des questions comme "combien?", "quel total?" ou "quelle moyenne?".
Fonctions d'agrégation principales
COUNT() - compte les lignes
Syntaxe de base:
COUNT(expression)
Exemple:
SELECT COUNT(*) AS total_paiements
FROM payment;
Résultat: la requête retourne le nombre total de lignes dans la table payment.
COUNT(column) et COUNT(*)
Ces deux formes se ressemblent, mais leur logique diffère:
COUNT(*)compte toutes les lignes du résultat.COUNT(column)compte seulement les lignes oùcolumnn'est pasNULL.
Si la colonne contient des NULL, COUNT(column) peut être inférieur à COUNT(*).
SELECT
    COUNT(*) AS total_locations,
    COUNT(return_date) AS locations_retournees
FROM rental;
Explication: total_locations compte toutes les locations, alors que locations_retournees ne compte que celles avec return_date renseignée.
COUNT(DISTINCT ...) - compte les valeurs uniques
Quand vous devez compter des valeurs uniques et non des lignes, utilisez COUNT(DISTINCT column).
SELECT COUNT(DISTINCT customer_id) AS clients_uniques
FROM payment;
Résultat: la requête retourne le nombre de clients différents ayant effectué un paiement, même si un client possède plusieurs lignes dans payment.
En pratique, c'est indispensable pour des questions comme "combien de clients différents ont acheté", où COUNT(*) surestime à cause des répétitions.
SUM() - calcule la somme
SELECT SUM(amount) AS montant_total
FROM payment;
Résultat: retourne la somme de la colonne amount.
SUM(amount) ignore les NULL. Si toutes les valeurs sont NULL, le résultat est NULL.
AVG() - calcule la moyenne
SELECT AVG(amount) AS montant_moyen
FROM payment;
Résultat: retourne la moyenne de amount sur les lignes non-NULL.
Si vous voulez que les lignes avec NULL influencent le dénominateur, utilisez une de ces approches:
SELECT
    AVG(amount) AS avg_ignore_null,
    AVG(COALESCE(amount, 0)) AS avg_include_null_as_zero,
    SUM(amount) / COUNT(*) AS avg_sum_div_all_rows
FROM payment;
MAX() - trouve la valeur maximale
SELECT MAX(amount) AS montant_max
FROM payment;
Résultat: retourne la plus grande valeur de amount.
MIN() - trouve la valeur minimale
SELECT MIN(amount) AS montant_min
FROM payment;
Résultat: retourne la plus petite valeur de amount.
MIN() et MAX() ignorent les NULL. Si toutes les valeurs sont NULL, le résultat est NULL.
MIN(column) et ORDER BY ... LIMIT 1
Ces deux approches ne sont pas toujours équivalentes.
SELECT MIN(column_name)
FROM table_name;

SELECT column_name
FROM table_name
ORDER BY column_name
LIMIT 1;
MIN(column_name)cherche le minimum parmi les valeurs non-NULL.ORDER BY ... LIMIT 1renvoie la première ligne après tri.- Si votre SGBD trie les
NULLen premier, la deuxième requête peut renvoyerNULL, alors queMIN()renvoie le minimum non-NULL.
Version fiable équivalente à MIN():
SELECT column_name
FROM table_name
WHERE column_name IS NOT NULL
ORDER BY column_name
LIMIT 1;
Utilisation pratique
Compter les clients
SELECT COUNT(*) AS total_clients
FROM customer;
Somme des ventes par employé
SELECT
    staff_id,
    SUM(amount) AS total_employe
FROM payment
GROUP BY staff_id;
Paiement moyen par client
SELECT
    customer_id,
    AVG(amount) AS paiement_moyen
FROM payment
GROUP BY customer_id;
Compter les clients payants uniques
SELECT COUNT(DISTINCT customer_id) AS clients_payants
FROM payment;
Questions fréquentes
Quelle est la différence entre COUNT(*) et COUNT(column)?
COUNT(*) compte toutes les lignes. COUNT(column) compte uniquement les lignes où la colonne spécifiée n'est pas NULL.
Quand utiliser COUNT(DISTINCT ...)?
Quand vous avez besoin du nombre de valeurs uniques, par exemple le nombre de clients différents plutôt que le nombre total de paiements.
Pourquoi AVG peut-il donner une valeur inattendue?
Parce que AVG(column) ignore les NULL. Si vous voulez inclure ces lignes dans le dénominateur, utilisez COALESCE ou SUM(column) / COUNT(*).
Questions d'entretien
Que sont les fonctions d'agrégation en SQL?
Ce sont des fonctions qui calculent une synthèse sur plusieurs lignes, par exemple le nombre (COUNT), la somme (SUM) ou la moyenne (AVG). Elles retournent une valeur par groupe ou pour l'ensemble du résultat.
Quelle est la différence entre COUNT(*), COUNT(column) et COUNT(DISTINCT column)?
COUNT(*) compte toutes les lignes, COUNT(column) compte les valeurs non-NULL de la colonne, et COUNT(DISTINCT column) compte les valeurs uniques non-NULL.
Comment MIN et ORDER BY ... LIMIT 1 peuvent-ils différer?
Si une colonne contient des NULL et que le tri place NULL en premier, ORDER BY ... LIMIT 1 peut retourner NULL, tandis que MIN() retourne le minimum non-NULL.
Points clés de cette leçon:
- Les fonctions d'agrégation donnent rapidement des métriques de synthèse.
COUNT(*),COUNT(column)etCOUNT(DISTINCT ...)répondent à des besoins de comptage différents.SUM,AVG,MINetMAXignorent en général lesNULL, ce qui influence l'analyse.COUNT(DISTINCT ...)est essentiel pour compter des entités uniques plutôt que des lignes.- Une bonne gestion de
NULLest cruciale pour la fiabilité des rapports.