ROW_NUMBER vs RANK vs DENSE_RANK vs NTILE
Leçon 7.2 · Temps de lecture : ~8 min · Exercices pratiques ↓
Les fonctions de classement SQL numérotent les lignes dans un ordre défini : ROW_NUMBER, RANK et DENSE_RANK attribuent des positions, et NTILE répartit les lignes en groupes. Elles ne diffèrent que par leur traitement des ex æquo, les lignes de valeurs égales, et c'est cette différence qui décide si un rapport est correct. Dans cette leçon, vous les comparerez toutes sur les mêmes données réelles, verrez pourquoi ROW_NUMBER a besoin d'un critère de départage et apprendrez quelle fonction convient à quelle tâche.
Dans la leçon précédente, vous avez utilisé ROW_NUMBER() pour numéroter des paiements. Les fonctions de classement suivent le même modèle : une fonction, puis OVER avec un ORDER BY qui définit ce que signifie « premier », et un PARTITION BY facultatif qui recommence le classement pour chaque groupe. Les fonctions de classement ignorent les cadres de fenêtre : elles examinent toujours toute la partition.
Les exemples s'exécutent sur la base d'exemple Sakila (MySQL 8.0).
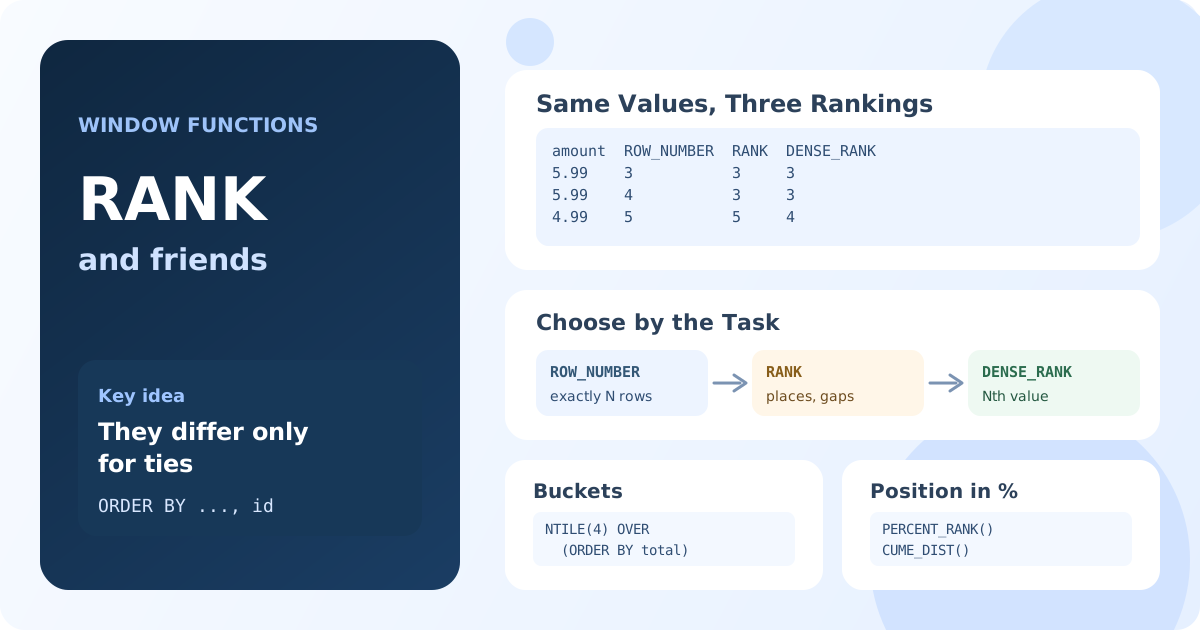
Les trois fonctions côte à côte
Le client 1 a effectué 32 paiements. Plusieurs sont égaux : quatre paiements de 5.99 et huit de 4.99. Classons les paiements du plus élevé au plus bas :
SELECT
    payment_id,
    amount,
    ROW_NUMBER() OVER (ORDER BY amount DESC, payment_id) AS row_num,
    RANK()       OVER (ORDER BY amount DESC) AS rnk,
    DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
FROM payment
WHERE customer_id = 1
ORDER BY row_num
LIMIT 8;
Résultat : les 8 plus gros paiements du client 1.
| payment_id | amount | row_num | rnk | dense_rnk |
|---|---|---|---|---|
| 5 | 9.99 | 1 | 1 | 1 |
| 14 | 7.99 | 2 | 2 | 2 |
| 3 | 5.99 | 3 | 3 | 3 |
| 10 | 5.99 | 4 | 3 | 3 |
| 11 | 5.99 | 5 | 3 | 3 |
| 32 | 5.99 | 6 | 3 | 3 |
| 6 | 4.99 | 7 | 7 | 4 |
| 7 | 4.99 | 8 | 7 | 4 |
ROW_NUMBERdonne à chaque ligne son propre numéro : 1, 2, 3, 4, … Des valeurs égales reçoivent des numéros différents.RANKdonne le même rang aux valeurs égales, puis saute des numéros : quatre paiements partagent le rang 3, le rang suivant est donc 7. C'est le « classement sportif », comme les places d'une course.DENSE_RANKdonne le même rang aux valeurs égales sans trous : après le rang 3 vient le rang 4. Le nombre de rangs distincts est égal au nombre de valeurs distinctes.
ROW_NUMBER a besoin d'un critère de départage
Entre des valeurs égales, ROW_NUMBER doit tout de même choisir un ordre, et la base de données est libre de choisir n'importe lequel. Sans payment_id dans l'ORDER BY ci-dessus, MySQL a numéroté les quatre paiements de 5.99 comme 4, 5, 6, 3, et une autre exécution ou une autre version du serveur pourrait le faire autrement. Un rapport qui dépend de « la ligne numéro 3 » changerait alors d'une exécution à l'autre.
Chaque fois que vous utilisez ROW_NUMBER pour quelque chose d'important, comme la pagination ou « garder la première ligne », ajoutez une colonne unique à l'ORDER BY dans OVER, par exemple la clé primaire. RANK et DENSE_RANK n'en ont pas besoin : les valeurs égales reçoivent de toute façon des rangs égaux.
NTILE : répartir les lignes en groupes
NTILE(n) ne classe pas les valeurs ; il répartit les lignes ordonnées en n groupes de taille presque égale et renvoie le numéro du groupe. C'est la méthode standard pour construire des quartiles, des déciles ou des segments « top 10 % ».
Répartissons les clients de chaque magasin en quartiles de dépenses :
WITH customer_total AS (
    SELECT c.store_id, c.customer_id, SUM(p.amount) AS total_paid
    FROM customer c
    JOIN payment p ON p.customer_id = c.customer_id
    GROUP BY c.store_id, c.customer_id
),
segmented AS (
    SELECT
        store_id,
        total_paid,
        NTILE(4) OVER (PARTITION BY store_id ORDER BY total_paid DESC) AS quartile
    FROM customer_total
)
SELECT
    store_id,
    quartile,
    COUNT(*) AS customers,
    MIN(total_paid) AS min_paid,
    MAX(total_paid) AS max_paid
FROM segmented
GROUP BY store_id, quartile
ORDER BY store_id, quartile;
Résultat : 8 lignes ; le magasin 1 a 326 clients répartis en 82, 82, 81 et 81 ; son quartile supérieur a payé de 128.73 à 216.54.
| store_id | quartile | customers | min_paid | max_paid |
|---|---|---|---|---|
| 1 | 1 | 82 | 128.73 | 216.54 |
| 1 | 2 | 82 | 111.74 | 128.73 |
| 1 | 3 | 81 | 96.72 | 111.73 |
| 1 | 4 | 81 | 50.85 | 95.78 |
| 2 | 1 | 69 | 127.68 | 221.55 |
| ... | ... | ... | ... | ... |
Quand les lignes ne se divisent pas exactement, les premiers groupes reçoivent une ligne de plus. NTILE répartit par nombre de lignes, pas par valeur : des valeurs égales à une frontière peuvent tomber dans des groupes différents, comme 128.73 ici.
PERCENT_RANK et CUME_DIST
Deux autres fonctions expriment une position sous forme de fraction entre 0 et 1 :
PERCENT_RANK()= (rang − 1) / (lignes − 1) : la part des lignes classées strictement devant. La première ligne obtient 0.CUME_DIST()= lignes dont la valeur va jusqu'à la valeur courante incluse / toutes les lignes : la part des lignes à cette position ou devant.
SELECT
    payment_id,
    amount,
    ROUND(PERCENT_RANK() OVER (ORDER BY amount DESC), 2) AS pct_rank,
    ROUND(CUME_DIST() OVER (ORDER BY amount DESC), 2) AS cumulative_share
FROM payment
WHERE customer_id = 1
ORDER BY amount DESC, payment_id
LIMIT 4;
Résultat : le paiement de 9.99 a pct_rank 0 et cumulative_share 0.03 ; chaque paiement de 5.99 a pct_rank 0.06 et cumulative_share 0.19, car 6 des 32 paiements valent 5.99 ou plus.
Elles sont pratiques pour les filtres du type « top 10 % des clients » : WHERE cumulative_share <= 0.1 dans une requête externe. Ne nommez pas la colonne cume_dist ou rank : dans MySQL 8, ce sont des mots réservés.
Quelle fonction utiliser
| Tâche | Fonction |
|---|---|
| Exactement N lignes par groupe, dernière ligne, pagination | ROW_NUMBER avec un critère de départage |
| Places dans une compétition : les scores égaux partagent une place, la suivante est sautée | RANK |
| N-ième valeur distincte, comme le deuxième salaire le plus élevé | DENSE_RANK |
| Quartiles, déciles, segments de taille égale | NTILE(n) |
| Position relative en pourcentage | PERCENT_RANK, CUME_DIST |
Deux exercices fondés sur ces fonctions sont traités en détail dans les leçons sur les exercices d'entretien : les N premières lignes par groupe (leçon 12.6) et le N-ième salaire le plus élevé (leçon 12.4).
Points clés :
ROW_NUMBER,RANKetDENSE_RANKne diffèrent que pour les ex æquo : numéros uniques, rangs partagés avec trous, rangs partagés sans trous.- Pour les valeurs 9.99, 7.99, 5.99, 5.99, 4.99, elles renvoient 1-2-3-4-5, 1-2-3-3-5 et 1-2-3-3-4.
- Ajoutez un critère de départage unique à l'
ORDER BYavecROW_NUMBER, sinon la numérotation des valeurs égales est arbitraire. NTILE(n)répartit les lignes ordonnées enngroupes presque égaux selon le nombre de lignes.PERCENT_RANKetCUME_DISTdonnent la position sous forme de fraction entre 0 et 1.
Questions fréquentes
Quelle est la différence entre ROW_NUMBER, RANK et DENSE_RANK ?
Les trois numérotent les lignes selon l'ORDER BY de OVER. ROW_NUMBER donne toujours des numéros uniques. RANK donne le même rang aux valeurs égales et saute les numéros suivants (1, 2, 2, 4). DENSE_RANK donne le même rang aux valeurs égales sans sauter de numéros (1, 2, 2, 3).
Quand utiliser RANK plutôt que DENSE_RANK ?
Utilisez RANK quand la position doit refléter le nombre de lignes devant, comme dans un classement sportif : deux vainqueurs partagent la 1re place et le suivant est 3e. Utilisez DENSE_RANK quand il vous faut des niveaux consécutifs de valeurs distinctes, par exemple « le deuxième prix le plus élevé ».
Comment NTILE gère-t-il les lignes qui ne se divisent pas exactement ?
Les premiers groupes reçoivent une ligne supplémentaire. Avec 326 lignes et NTILE(4), les groupes ont 82, 82, 81 et 81 lignes. NTILE compte les lignes, donc des valeurs égales peuvent être réparties entre deux groupes voisins.
Pourquoi ROW_NUMBER donne-t-il des résultats différents pour la même requête ?
Parce que l'ORDER BY dans OVER contient des ex æquo, et la base de données peut ordonner les lignes égales différemment d'une exécution à l'autre. Ajoutez une colonne unique, comme la clé primaire, en dernière clé de tri pour rendre la numérotation déterministe.