Практические сценарии SQL JOIN
Урок 5.8 · Время чтения: ~8 мин · Задачи для практики ↓
В этом уроке собраны практические сценарии SQL JOIN: соединение нескольких таблиц по связям в схеме, агрегация соединённых данных, поиск недостающих данных и две самые частые ошибки - завышенные итоги и внешние соединения, которые теряют свои строки.
Типы соединений вы уже знаете; теперь задача - применять их к реальным вопросам. Большинство отчётных запросов строятся по одной схеме: найти таблицы с нужными данными, связать их через ключи, отфильтровать и агрегировать.
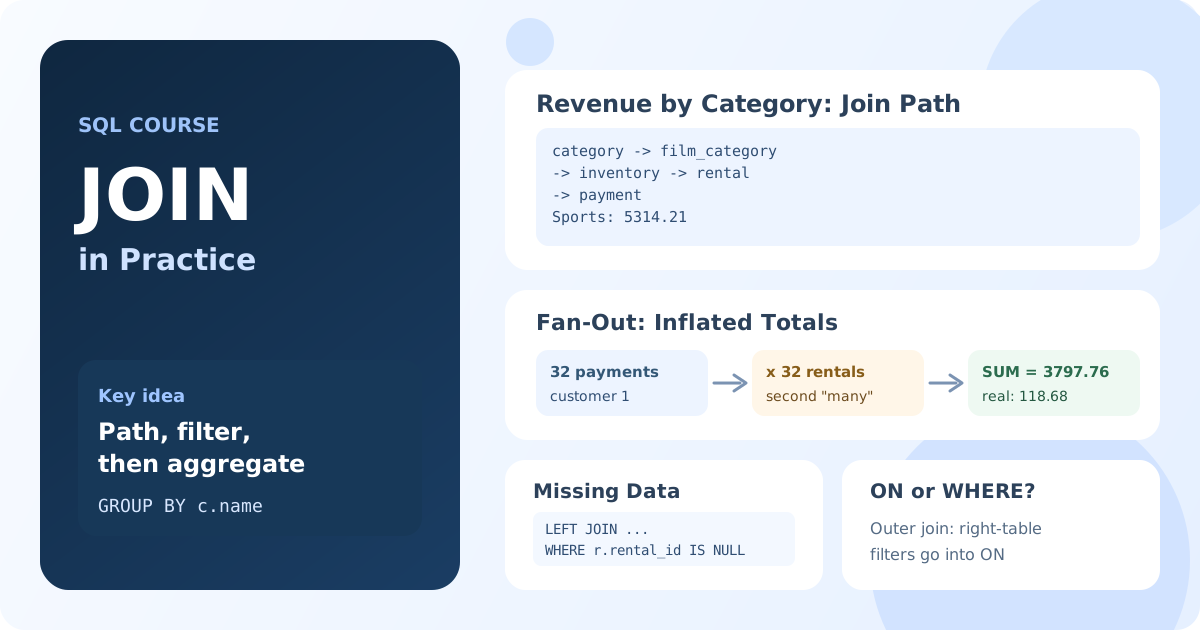
Планирование пути соединения
Начните с вопроса и найдите путь между таблицами на схеме базы данных. Для «выручки по категориям фильмов» нужны category, затем film_category, inventory, rental и, наконец, payment:
SELECT c.name AS category,
       COUNT(p.payment_id) AS payments,
       SUM(p.amount) AS revenue
FROM category AS c
INNER JOIN film_category AS fc ON fc.category_id = c.category_id
INNER JOIN inventory AS i ON i.film_id = fc.film_id
INNER JOIN rental AS r ON r.inventory_id = i.inventory_id
INNER JOIN payment AS p ON p.rental_id = r.rental_id
GROUP BY c.name
ORDER BY revenue DESC;
Результат: 16 категорий, отсортированных по выручке; первые места у Sports и Sci-Fi.
Сама таблица film здесь не нужна: и film_category, и inventory хранят film_id, поэтому их можно соединить напрямую. Соединяйте только таблицы, в которых есть нужные данные или которые необходимы для связи.
Агрегация после соединения
Общие траты каждого клиента:
SELECT c.customer_id,
       c.first_name,
       c.last_name,
       COUNT(*) AS payments,
       SUM(p.amount) AS total_spent
FROM customer AS c
INNER JOIN payment AS p ON p.customer_id = c.customer_id
GROUP BY c.customer_id, c.first_name, c.last_name
ORDER BY total_spent DESC
LIMIT 10;
Результат: 10 клиентов, потративших больше всех.
Группируйте по ключу (customer_id), а не только по имени: у двух разных клиентов может быть одно имя.
Ловушка размножения строк: завышенные итоги
Соединение размножает строки: клиент с 30 платежами и 30 арендами превращается в 900 строк, если обе таблицы соединить с клиентом одновременно. Любая сумма по такому результату неверна.
-- Неверно: платежи умножаются на аренды
SELECT c.customer_id,
       SUM(p.amount) AS total_spent
FROM customer AS c
INNER JOIN payment AS p ON p.customer_id = c.customer_id
INNER JOIN rental AS r ON r.customer_id = c.customer_id
WHERE c.customer_id = 1
GROUP BY c.customer_id;
Результат: 3 797,76 вместо реальных 118,68: каждый из 32 платежей клиента учтён по разу на каждую из его 32 аренд.
Правило: не соединяйте в одном запросе с одной и той же строкой две независимые таблицы «многие». Здесь таблица rental вообще не нужна. Если нужны итоги из двух таких таблиц, сначала агрегируйте каждую отдельно; как это делать с подзапросами и CTE, вы узнаете в модуле 6.
Поиск недостающих данных
LEFT JOIN ... WHERE right_key IS NULL находит строки без совпадения. Клиенты, которые ничего не брали в аренду с 23 августа 2005 года:
SELECT c.customer_id, c.first_name, c.last_name
FROM customer AS c
LEFT JOIN rental AS r ON r.customer_id = c.customer_id
                     AND r.rental_date >= '2005-08-23'
WHERE r.rental_id IS NULL
ORDER BY c.customer_id;
Результат: клиенты без аренд в последние дни данных.
Обратите внимание на условие по дате: оно стоит в ON, потому что ограничивает, какие аренды считаются совпадением. В WHERE оно удалило бы всех клиентов без совпадения, и запрос ничего бы не вернул.
WHERE или ON во внешних соединениях
Предыдущий пример показывает общее правило для LEFT JOIN:
| Условие на | Куда писать | Эффект |
|---|---|---|
| правую таблицу, чтобы ограничить совпадения | ON | Строки левой таблицы остаются; фильтруются только совпадения |
| левую таблицу | WHERE | Строки левой таблицы удаляются из результата |
ключ правой таблицы IS NULL | WHERE | Остаются только строки без совпадения (антисоединение) |
Для INNER JOIN ON и WHERE дают одинаковый результат, поэтому выбор места - вопрос читаемости.
Ключевые выводы:
- Планируйте путь соединения по схеме и соединяйте только нужные таблицы.
- Группируйте по ключам, а не только по именам.
- Соединение с одной строкой двух таблиц «многие» размножает строки и завышает суммы и количества.
LEFT JOIN ... WHERE key IS NULLнаходит недостающие данные.- Во внешних соединениях условия на правую таблицу пишутся в
ON.
Часто задаваемые вопросы
Как соединить больше двух таблиц в SQL?
Добавляйте по одному JOIN ... ON ... на каждую таблицу, следуя внешним ключам схемы. Каждое соединение подключает новую таблицу к уже присутствующим в запросе.
Почему SUM после JOIN возвращает намного большее число?
Потому что соединение размножило строки: каждая строка одной таблицы повторилась для каждой совпадающей строки другой. Уберите ненужные таблицы или агрегируйте каждую таблицу отдельно перед соединением результатов.
Куда писать фильтр - в ON или в WHERE?
Для INNER JOIN разницы нет. Для LEFT JOIN условие на правую таблицу пишется в ON; в WHERE оно удаляет строки без совпадения и превращает внешнее соединение во внутреннее.