Урок 6.3 · Время чтения: ~6 мин
Коррелированный подзапрос в SQL — это подзапрос, который ссылается на столбец внешнего запроса, поэтому его результат зависит от текущей внешней строки. В этом уроке вы узнаете, как вычисляется коррелированный подзапрос, как сравнить строку с её собственной группой, как использовать коррелированные подзапросы в SELECT и с EXISTS и когда лучше выбрать JOIN.
Коррелированные подзапросы в SQL
Подзапросы из предыдущих уроков были независимыми: внутренний запрос можно было выделить и выполнить отдельно. Коррелированный подзапрос отдельно не выполнить: он использует значение из строки, которую в данный момент рассматривает внешний запрос. Это позволяет задавать вопросы относительно каждой строки: «дороже ли этот фильм среднего по его рейтингу?», «какой фильм самый длинный в этой категории?».
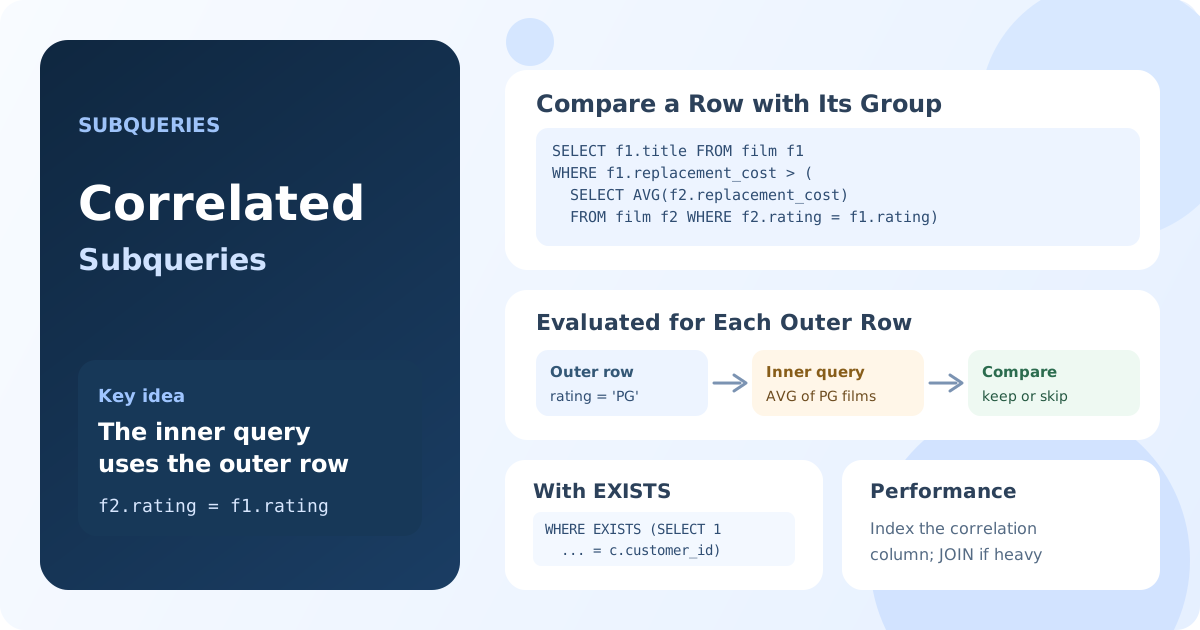
Как работает коррелированный подзапрос
Логически база данных вычисляет коррелированный подзапрос так:
- Берёт строку внешнего запроса.
- Выполняет внутренний запрос, подставляя значения из этой строки.
- Использует результат, чтобы вычислить условие или столбец для строки.
- Переходит к следующей строке и повторяет.
Связь между запросами — это условие во внутреннем запросе, которое использует внешний псевдоним, например f2.rating = f1.rating. Псевдонимы здесь обязательны: без них непонятно, к какой копии таблицы относится столбец.
Сравнение строки с её группой
Фильмы, стоимость замены которых выше средней по их рейтингу:
SELECT f1.title, f1.rating, f1.replacement_cost
FROM film AS f1
WHERE f1.replacement_cost > (
    SELECT AVG(f2.replacement_cost)
    FROM film AS f2
    WHERE f2.rating = f1.rating
)
ORDER BY f1.rating, f1.replacement_cost DESC;
Результат: фильмы, замена которых стоит дороже, чем у среднего фильма того же рейтинга.
Для фильма с рейтингом PG внутренний запрос вычисляет среднее по фильмам PG, для фильма R — по фильмам R. Некоррелированный подзапрос смог бы сравнить только с одним общим средним.
Коррелированные подзапросы в SELECT
Коррелированный подзапрос в списке SELECT возвращает одно значение для каждой строки. Количество фильмов в каждой категории:
SELECT c.name AS category,
       (SELECT COUNT(*)
        FROM film_category AS fc
        WHERE fc.category_id = c.category_id) AS films
FROM category AS c
ORDER BY films DESC;
Результат: 16 категорий с количеством фильмов, начиная со Sports (74 фильма).
Он может вернуть и значение, которое трудно получить через GROUP BY, например название самого длинного фильма в каждой категории:
SELECT c.name AS category,
       (SELECT f.title
        FROM film AS f
        INNER JOIN film_category AS fc ON fc.film_id = f.film_id
        WHERE fc.category_id = c.category_id
        ORDER BY f.length DESC, f.title
        LIMIT 1) AS longest_film
FROM category AS c
ORDER BY c.name;
Результат: каждая категория с названием её самого длинного фильма; при равной длине выбирается по названию.
Подзапрос в SELECT должен возвращать одну строку и один столбец, иначе запрос завершится ошибкой.
Коррелированные подзапросы с EXISTS
EXISTS проверяет, возвращает ли внутренний запрос хотя бы одну строку, и почти всегда используется с коррелированным подзапросом. Клиенты, бравшие в аренду хотя бы одну копию из магазина 2:
SELECT c.customer_id, c.first_name, c.last_name
FROM customer AS c
WHERE EXISTS (
    SELECT 1
    FROM rental AS r
    INNER JOIN inventory AS i ON i.inventory_id = r.inventory_id
    WHERE r.customer_id = c.customer_id
      AND i.store_id = 2
)
ORDER BY c.customer_id;
Результат: клиенты, у которых есть хотя бы одна аренда копии из магазина 2. SELECT 1 — соглашение: EXISTS проверяет только существование строки, а не её содержимое.
NOT EXISTS находит строки без совпадения, как антисоединение LEFT JOIN ... IS NULL из урока 5.3.
Производительность
Описание «выполняется для каждой строки» — это логическая модель. Современные оптимизаторы часто переписывают коррелированные подзапросы в соединения или полусоединения, особенно EXISTS и IN. И всё же:
- Коррелированный подзапрос в
SELECTили в сложномWHEREможет действительно выполняться по разу на каждую внешнюю строку и становиться медленным на больших таблицах. - Индекс по столбцу корреляции (здесь
film_category.category_id,rental.customer_id) делает каждое выполнение внутреннего запроса быстрым. - Если один результат внутреннего запроса нужен для многих столбцов,
JOINс групповым подзапросом или CTE (урок 6.4) обычно понятнее и быстрее.
Если запрос с коррелированным подзапросом работает медленно, проверьте план с помощью EXPLAIN.
Ключевые выводы:
- Коррелированный подзапрос ссылается на столбец внешнего запроса и не может выполняться отдельно.
- Логически он вычисляется по разу для каждой внешней строки.
- Это естественный инструмент для сравнения строки с её собственной группой.
- В
SELECTон должен возвращать ровно одно значение. EXISTSиNOT EXISTS— типичные коррелированные подзапросы.- Индексируйте столбец корреляции; для тяжёлых запросов рассмотрите
JOINили CTE.
Часто задаваемые вопросы
Чем отличаются коррелированный и некоррелированный подзапросы?
Некоррелированный подзапрос независим: он выполняется один раз, и его результат используется для всех строк. Коррелированный подзапрос использует значения внешней строки, поэтому его результат может быть разным для каждой строки.
Медленные ли коррелированные подзапросы?
Могут быть, потому что логически они выполняются для каждой внешней строки. На практике оптимизаторы часто превращают их в соединения, а индекс по столбцу корреляции сильно помогает. Проверяйте план выполнения с помощью EXPLAIN.
Можно ли заменить коррелированный подзапрос на JOIN?
Обычно да. Например, сравнение со средним по группе можно записать как соединение с групповым подзапросом: JOIN (SELECT rating, AVG(replacement_cost) AS avg_cost FROM film GROUP BY rating) AS r ON r.rating = f.rating.