第 9.6 课 · 阅读时间:约 10 分钟
数据库规范化是一种设计表的方法,目标是让每个事实只存储在一个地方。规范化的数据库把数据拆分到通过键相互关联的表中,从而消除重复数据以及由此产生的错误。在本课中,你将学习前三个范式(1NF、2NF、3NF)和 BCNF,了解如何用 SQL 拆分一张宽表,并知道什么时候有意保留重复数据反而更好。
数据库规范化:1NF、2NF 和 3NF
在本模块前面的课程中,你已经创建了表、修改了表,并在表之上建立了视图。剩下的问题是:一开始应该建哪些表,哪些数据放在同一张表里,哪些数据应该单独成表。
规范化用几条称为范式的形式化规则来回答这个问题。Sakila 是一个规范化得很好的数据库,所以本课的例子都基于它的表。
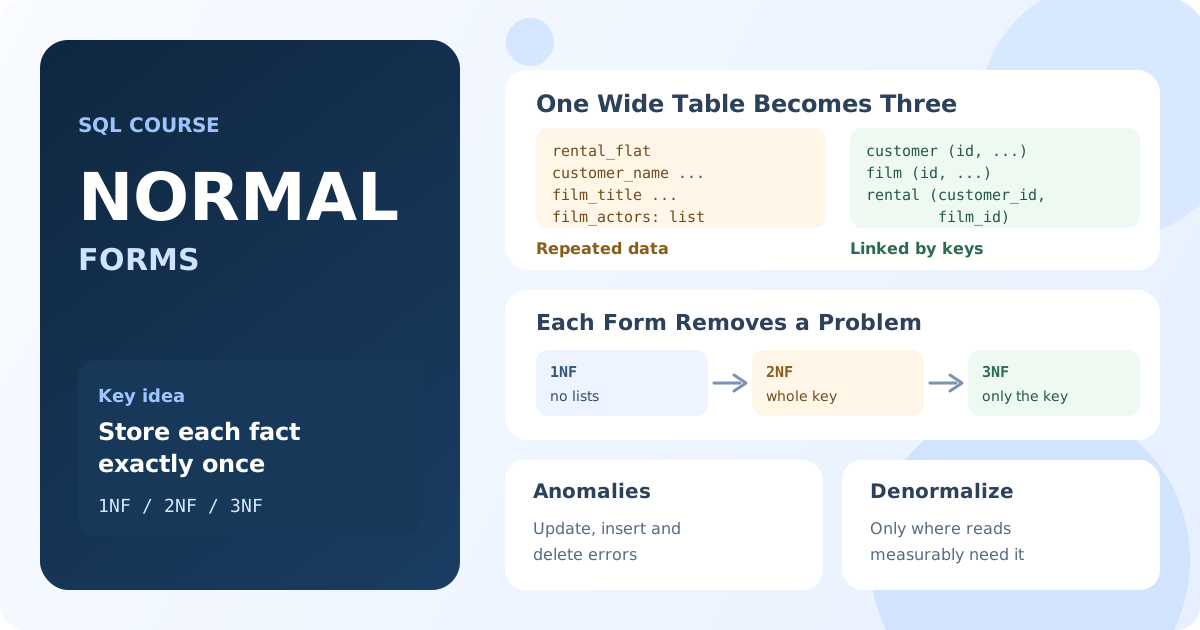
什么是数据库规范化?
规范化是组织列和表的过程,目标是:
- 每张表只描述一类实体:客户、电影或租赁;
- 每个事实只存储一次,其他表通过键引用它;
- 每个非键列都依赖于所在表的键,并且只依赖于这个键。
这些规则被分组为范式:1NF、2NF、3NF、BCNF(Boyce-Codd 范式)以及更高的范式。每个范式都包含前一个范式的要求。实际工作中,处于第三范式(3NF)的模式就被认为是规范化的;更高的范式只处理少见的情况。
为什么要规范化:数据异常
假设租赁记录都存放在一张宽表中:
| rental_id | rental_date | customer_email | customer_name | customer_city | film_title | film_actors |
|---|---|---|---|---|---|---|
| 1 | 2026-05-01 | mary@example.org | MARY SMITH | Sasebo | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
| 2 | 2026-05-02 | mary@example.org | MARY SMITH | Sasebo | ACE GOLDFINGER | BOB FAWCETT, MINNIE ZELLWEGER |
| 3 | 2026-05-02 | patricia@example.org | PATRICIA JOHNSON | San Bernardino | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
这张表读起来很方便,但客户和电影的数据在每条租赁记录中都重复出现。这会导致三类问题,称为异常:
- 更新异常。 Mary 搬到了另一个城市。你必须更新她的每一条租赁记录;只要漏掉一行,数据库里同一个客户就会有两个不同的城市。
- 插入异常。 在有人租借之前,无法添加一部新电影,因为每一行都是一条租赁记录。
- 删除异常。 删除 Patricia 唯一的一条租赁记录,也会删除关于 Patricia 的全部信息。
规范化通过把每个事实移到它所属的表中来消除这些异常。
第一范式(1NF)
当满足以下条件时,表处于第一范式:
- 每一列只保存一个(原子)值,而不是一个列表;
- 没有像
phone1、phone2、phone3这样重复的列组; - 每一行都可以通过主键来标识。
上表中的 film_actors 列违反了 1NF:它在一个值中保存了一串名字。这样的列很难查询。要找出有 Penelope Guiness 参演的电影,只能用 LIKE 在文本中搜索,这无法使用索引,还会误匹配相似的名字。统计每位演员的电影数量就更难了。
Sakila 中就有这种折中的真实例子。在 MySQL 中,film.special_features 列的类型是 SET,存储的值形如 Trailers,Commentaries:
SELECT special_features, COUNT(*) AS films
FROM film
GROUP BY special_features
ORDER BY films DESC
LIMIT 3;
结果:四种特性组合出 15 种取值,排第一的是 Trailers,Commentaries,Behind the Scenes(79 部电影)。要按单个特性统计电影数量,就必须拆分这些字符串。
1NF 的解决办法是建一张单独的表,每个值占一行。Sakila 对演员正是这样处理的:film_actor 表每行存储一对 (actor_id, film_id)。
SELECT a.first_name, a.last_name, COUNT(*) AS films
FROM film_actor AS fa
JOIN actor AS a ON a.actor_id = fa.actor_id
GROUP BY a.actor_id, a.first_name, a.last_name
ORDER BY films DESC
LIMIT 3;
结果:参演电影最多的演员,GINA DEGENERES 以 42 部居首。如果演员以列表形式存在一个文本列里,这个查询就很难写。
第二范式(2NF)
当表处于 1NF,并且每个非键列都依赖于整个主键而不是其中一部分时,表处于第二范式。
2NF 只对具有多列复合键的表有意义。假设 film_actor 还存储了名称:
| actor_id | film_id | actor_name | film_title |
|---|---|---|---|
| 1 | 1 | PENELOPE GUINESS | ACADEMY DINOSAUR |
| 1 | 23 | PENELOPE GUINESS | ANACONDA CONFESSIONS |
键是 (actor_id, film_id),但 actor_name 只依赖于 actor_id,film_title 只依赖于 film_id。这就是部分依赖:演员的名字在他参演的每部电影中都重复一次。
解决办法是把每一列移到它所依赖的键所在的表中:名字移到 actor,片名移到 film。真实的 film_actor 表只保留两个键和 last_update。
第三范式(3NF)
当表处于 2NF,并且没有任何非键列依赖于另一个非键列时,表处于第三范式。这种 键 → 列 A → 列 B 的链条称为传递依赖。
例如,如果 address 表还存储了国家:
| address_id | address | city_id | city | country |
|---|---|---|---|---|
| 5 | 1913 Hanoi Way | 463 | Sasebo | Japan |
| 6 | 1121 Loja Avenue | 449 | San Bernardino | United States |
city 和 country 依赖于 city_id,而不是 address_id。同一城市的每个地址都会重复城市名和国家名,修改一个国家的名称就需要更新成千上万条地址。
Sakila 用一条表链解决了这个问题:address 存储 city_id,city 存储 country_id,只有 country 存储国家名称。每个名称只存储一次,查询时用 JOIN 把它们组合起来:
SELECT co.country, COUNT(*) AS customers
FROM customer AS c
JOIN address AS a ON a.address_id = c.address_id
JOIN city AS ci ON ci.city_id = a.city_id
JOIN country AS co ON co.country_id = ci.country_id
GROUP BY co.country
ORDER BY customers DESC
LIMIT 5;
结果:India(60)、China(53)、United States(36)、Japan(31)和 Mexico(30)。规范化的数据要通过连接来读取,这是每个事实只存储一次的代价。
记住 1NF 到 3NF 的一句话:每个非键列都必须依赖于键、整个键,并且只依赖于键。
Boyce-Codd 范式(BCNF)
BCNF 是 3NF 更严格的版本:任何决定其他列的列都必须是候选键。只有在存在多个相互重叠的候选键的表中才会出现差别,而这种情况很少见。大多数处于 3NF 的表已经处于 BCNF。第四范式和第五范式处理多值依赖,在数据库理论之外很少讨论。
如何用 SQL 规范化一张表
我们把本课开头那张宽表(表名为 rental_flat)拆分成规范化的表。请在你自己的数据库中执行这些语句:SQLtest 上的示例数据库是只读的。首先是新的结构:
CREATE TABLE customer_n (
    customer_id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(50) NOT NULL UNIQUE,
    name VARCHAR(90) NOT NULL,
    city VARCHAR(50) NOT NULL
);

CREATE TABLE film_n (
    film_id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL UNIQUE
);

CREATE TABLE rental_n (
    rental_id INT PRIMARY KEY,
    rental_date DATE NOT NULL,
    customer_id INT NOT NULL,
    film_id INT NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customer_n (customer_id),
    FOREIGN KEY (film_id) REFERENCES film_n (film_id)
);
说明:这是 MySQL 语法。在 PostgreSQL 中,把 INT AUTO_INCREMENT 换成 INT GENERATED ALWAYS AS IDENTITY。
然后复制数据。SELECT DISTINCT 让每个客户和每部电影只保留一行,租赁记录则通过 JOIN 找到对应的键:
INSERT INTO customer_n (email, name, city)
SELECT DISTINCT customer_email, customer_name, customer_city
FROM rental_flat;

INSERT INTO film_n (title)
SELECT DISTINCT film_title
FROM rental_flat;

INSERT INTO rental_n (rental_id, rental_date, customer_id, film_id)
SELECT r.rental_id, r.rental_date, c.customer_id, f.film_id
FROM rental_flat AS r
JOIN customer_n AS c ON c.email = r.customer_email
JOIN film_n AS f ON f.title = r.film_title;
结果:2 个客户、2 部电影和 3 条租赁记录。Mary 的城市现在只存储在一行中,一条 UPDATE 就能在所有地方生效。
如果 SELECT DISTINCT 对同一个邮箱返回了两行,说明数据本身已经不一致:同一个客户在不同的租赁记录中有不同的名字或城市。email 上的 UNIQUE 约束会拒绝第二行,你需要决定哪个值才是正确的。规范化经常会暴露出这类问题。
演员列表也用同样的方式移到 actor 和 film_actor 两张表中。城市则按照 3NF 一节的例子处理:单独建一张 city 表,并在 customer_n 中使用 city_id 列。
反规范化:什么时候可以接受重复
反规范化是指有意存储冗余数据,让读取更快或更简单。它是一种有意识的权衡,而不是设计错误,Sakila 自身就有几个例子:
payment存储了customer_id,尽管它可以通过rental_id查到。这个重复省去了支付报表中的一次连接;在所有 16,044 条关联了租赁记录的支付中,两个值都一致。film_text表重复存储了film中的title和description,用于全文搜索。film_list视图把演员返回为一个用逗号分隔的字符串。视图本身不存储数据,所以它提供了方便的宽表格式,又不会产生异常。
常见的反规范化原因:
- 每次请求都要连接许多大表的报表和仪表板;
- 重新计算代价很高的计数和汇总,例如客户的累计支付金额;
- 采用星型模型的分析型数据仓库,数据按批次加载,很少更新。
经验法则:先设计规范化的模式,然后只在测量出性能问题的具体位置进行反规范化。每一份重复数据都需要一种保持同步的方式:触发器、定时任务或应用程序代码。
本课要点:
- 规范化让每个事实只存储一次,并通过键关联各表;它能避免更新异常、插入异常和删除异常。
- 1NF:每列一个值,没有列表或重复的列组,每张表都有主键。
- 2NF:没有任何列只依赖于复合键的一部分。
- 3NF:没有任何列依赖于另一个非键列;“键、整个键,并且只依赖于键”。
- 规范化的数据用
JOIN读取;视图可以把它们以宽表格式呈现。 - 反规范化要有意为之,只在读取需要的地方使用,并制定保持副本同步的方案。
本课结束了关于创建和修改表的模块。下一个模块介绍如何编写清晰且高效的 SQL:最佳实践、查询优化和索引。
常见问题
什么是数据库规范化?
规范化是把数据组织到相互关联的表中,使每个事实只存储一次的过程。它消除重复数据以及由此产生的异常,例如同一个客户在不同的行中有两个不同的地址。
1NF、2NF 和 3NF 有什么区别?
1NF 要求原子值和主键。2NF 在此基础上禁止只依赖于复合键一部分的列。3NF 在此基础上禁止依赖于其他非键列的列,例如把国家名称存放在城市 ID 旁边。
规范化的数据库总是更好吗?
对于经常变化的数据,通常是的:它能保持数据一致、模式灵活。对于报表和分析,有控制的反规范化可以让读取快得多。先从规范化的模式开始,只在测量出需求的地方进行反规范化。
规范化会让查询变慢吗?
读取需要更多的连接,会花费一些时间,但只要键列上有索引,连接就很快。写入往往更快,因为每次修改只更新一行,而不是许多份副本。
面试题
请解释更新异常、插入异常和删除异常。
更新异常是指同一个事实存储在多行中,更新时漏掉了其中一部分。插入异常是指无法在没有无关数据的情况下添加一个事实,例如没有租赁记录就无法添加电影。删除异常是指删除一个事实时连带删除了另一个事实,例如删除客户唯一的租赁记录导致客户信息也消失。
什么是传递依赖?请举例说明。
传递依赖是指非键列依赖于另一个非键列,而不是依赖于键。在 address(address_id, city_id, city_name) 中,city_name 依赖于 city_id,而不是 address_id。解决办法是单独建一张 city 表,这样模式就达到了 3NF。
什么时候你会对模式进行反规范化?
当读取远多于写入,并且连接已经成为经过测量的瓶颈时,例如在报表、仪表板和数据仓库中。存储冗余数据时要有明确的同步方式,例如触发器或定时刷新。