第 1.5 课 · 阅读时间:约 7 分钟
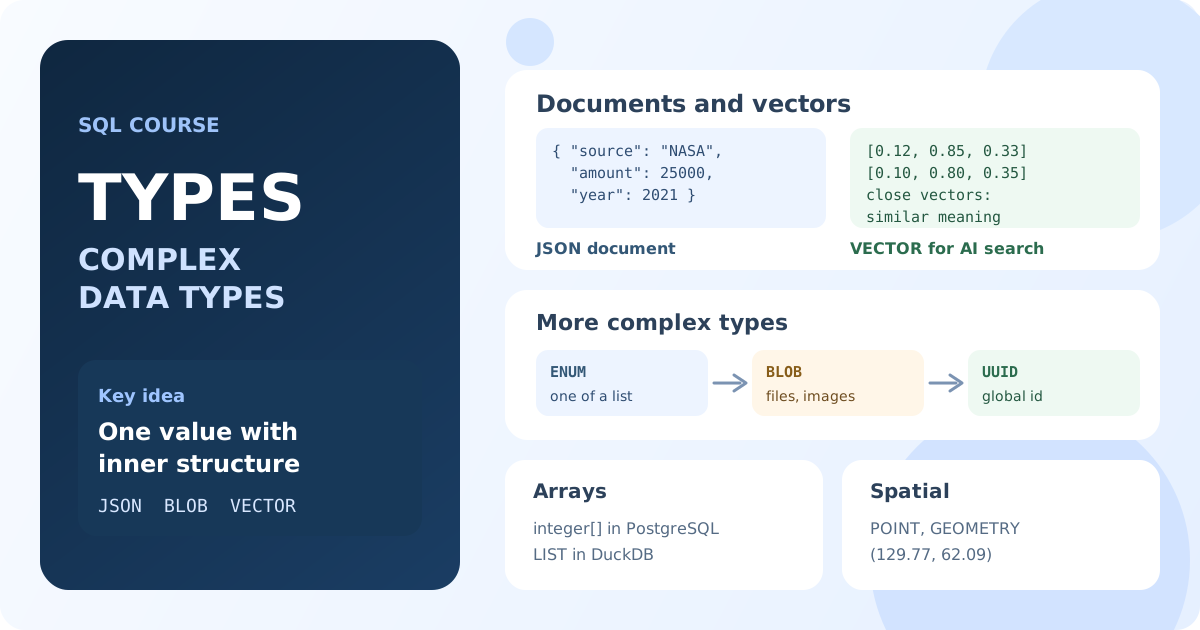
除了数字、文本和日期,数据库还有用于存储具有内部结构的值的复杂数据类型:文档、列表、文件、唯一标识符、位置,以及用于 AI 搜索的向量。本课是一次快速浏览:每种类型存储什么、示例值是什么、哪些数据库支持它。你不需要记住语法——目标是在表中遇到这些类型时能认出它们。
SQL 中的复杂数据类型
在上一课中,每一列只保存一个简单的值:数字、字符串或日期。有些数据并不适合这样存储:商品的一组属性、扫描的合同、地图上的一个点。对于这类数据,数据库提供了专门的类型。
JSON:文档
JSON 列存储一个完整的文档,包括键、值、嵌套对象和列表。在 University 数据库中,研究项目把它的资助信息保存在一个 JSON 列里:
[{ "source": "Private Foundation", "amount": 244542.96, "year": 2020}]
- MySQL 和 MariaDB 有
JSON类型;PostgreSQL 有json和更快的二进制jsonb;SQL Server 和 SQLite 把 JSON 存为文本,并用 JSON 函数读取。 - JSON 适合因行而异的属性,或者从其他系统以文档形式传来的数据。
XML 是更早的文档格式,用途相同;PostgreSQL 和 SQL Server 为它提供了 xml 类型。
数组和嵌套结构
数组是一个单元格中的一组值,例如 [1, 2, 3]。PostgreSQL 支持任意类型的数组(integer[]、text[]),DuckDB 等分析型数据库还提供 LIST、STRUCT 和 MAP。MySQL、MariaDB、SQL Server 和 SQLite 没有数组类型:列表会放进 JSON,或者更常见的是放进单独的表中,每个元素一行。
ENUM 和 SET:固定的值列表
ENUM 只允许取列定义中列出的一个值。在 Sakila 中,film.rating 的类型是 ENUM('G', 'PG', 'PG-13', 'R', 'NC-17'),所以电影不可能得到列表之外的分级。SET 是 MySQL 和 MariaDB 的类型,允许列表中值的任意组合:film.special_features 中保存着像 Trailers,Deleted Scenes 这样的值。
PostgreSQL 单独创建枚举类型(CREATE TYPE ... AS ENUM);其他数据库则使用带检查的普通列或一张参照表。
BLOB:二进制数据
BLOB(Binary Large Object,二进制大对象)存储字节:图片、PDF 文件、压缩包。在 Sakila 中,staff.picture 是保存员工照片的 MEDIUMBLOB。这种类型在 MySQL、MariaDB 和 SQLite 中叫 BLOB,在 PostgreSQL 中叫 bytea,在 SQL Server 中叫 VARBINARY(MAX)。
大文件会让数据库的备份变重、复制变慢,所以应用程序通常把文件放在文件存储中,数据库里只在文本列中保存路径或 URL。
UUID:唯一标识符
UUID 是一个 128 位的标识符,例如 a1c7abde-ccc7-11f1-92da-da8de233f452,在不同的表、服务器和系统之间都是唯一的。当很多地方同时创建行、无法共享一个简单计数器时,就会使用它。PostgreSQL 和 MariaDB 有 uuid 类型,SQL Server 中叫 UNIQUEIDENTIFIER,MySQL 用 CHAR(36) 或 BINARY(16) 存储 UUID。
空间类型:点和形状
空间类型存储几何数据:点、线和多边形。在 Bookings 数据库中,每个机场都有 point 类型的 coordinates,例如雅库茨克是 (129.77, 62.09)。MySQL 和 MariaDB 有 GEOMETRY 和 POINT,SQL Server 有 geometry 和 geography,PostgreSQL 则通过 PostGIS 扩展获得完整支持。空间函数可以测量距离,找出某个区域内有什么,或者哪些对象离得最近。
VECTOR:用于 AI 搜索的嵌入向量
VECTOR 是一个固定长度的数字列表,例如 [0.1, 0.2, 0.3]。AI 模型把文本、图片和商品转换成这样的向量(嵌入向量),使相似的事物得到相近的向量。这样数据库就能找出向量与查询向量最接近的行:"与这个问题相似的文档"。这是语义搜索和 RAG 应用的基础。
- MariaDB 从 11.7 版开始提供
VECTOR(n),以及VEC_DISTANCE_COSINE等函数。 - MySQL 在 9 版中加入了
VECTOR,SQL Server 在 2025 版中加入。 - PostgreSQL 通过 pgvector 扩展支持向量。
不同数据库中的复杂类型
| 数据 | MySQL | MariaDB | PostgreSQL | SQL Server | SQLite |
|---|---|---|---|---|---|
| 文档 | JSON | JSON | json、jsonb、xml | 文本、xml | 文本 |
| 列表 | — | — | 数组(integer[]) | — | — |
| 固定的值列表 | ENUM、SET | ENUM、SET | CREATE TYPE ... AS ENUM | — | — |
| 二进制数据 | BLOB | BLOB | bytea | VARBINARY(MAX) | BLOB |
| 唯一标识符 | CHAR(36)、BINARY(16) | UUID | uuid | UNIQUEIDENTIFIER | 文本 |
| 位置 | GEOMETRY、POINT | GEOMETRY、POINT | point、PostGIS | geometry、geography | — |
| 向量 | VECTOR(9.0+) | VECTOR(11.7+) | pgvector | VECTOR(2025) | — |
什么时候使用复杂类型
当值被整体使用或需要特殊搜索时,复杂类型是不错的选择:原样存储和返回的文档、照片、用于相似度搜索的嵌入向量。如果你经常按值的某一部分进行筛选、连接或计数——比如 JSON 中的某个键、数组中的某个元素——这一部分通常应该放在单独的列或表中。这样查询会保持简单,数据库也能使用普通索引。
本课要点:
- 复杂类型存储具有内部结构的值:文档、列表、文件、标识符、位置和向量。
JSON存储文档;PostgreSQL 还有jsonb、数组和xml。ENUM和SET把列的取值限制在声明的列表中。BLOB、bytea和VARBINARY存储二进制文件;大文件通常放在数据库之外。UUID提供跨系统唯一的标识符;空间类型存储点和形状。VECTOR存储用于相似度搜索的 AI 嵌入向量;是否支持取决于数据库及其版本。
常见问题
应该把图片存进 BLOB 列吗?
小图片可以,但大文件会让数据库变大、备份变慢。常见做法是把文件放在文件存储中,在数据库里保存它们的路径。
用 JSON 好还是用单独的列好?
对每一行都有、并且用于筛选或连接的数据,使用单独的列。对因行而异或以现成文档形式传来的属性,使用 JSON。
数据库中的向量是什么?
一个固定长度的数字列表,代表文本、图片或其他对象的含义。相似对象的向量彼此接近,所以数据库能找出离查询最近的那些。
面试题
你知道哪些复杂数据类型?什么时候会用到它们?
JSON 用于半结构化文档,数组用于 PostgreSQL 中的列表,ENUM 用于固定的取值集合,BLOB 用于二进制文件,UUID 用于全局唯一标识符,空间类型用于位置,VECTOR 用于相似度搜索中的嵌入向量。当值被整体处理或需要其专门的操作时,就会使用它们。
用 JSON 代替列存储数据有什么缺点?
JSON 内部的值更难校验、约束、连接和建立索引;查询会变长,类型错误只有在读取数据时才会暴露出来。
为什么向量数据库对 AI 应用很重要?
AI 模型把文本和图片表示为嵌入向量。具有向量类型和最近邻搜索的数据库能快速找到最相似的项目,这正是语义搜索和检索增强生成(RAG)的核心。