第 10.6 课 · 阅读时间:约 10 分钟
全文索引(full-text index)是对文本列中单词建立的索引:对每个单词,它保存包含该单词的行。它让数据库能够按单词查找行并按相关度排序,而 LIKE '%单词%' 做同样的事情只能读取整张表。在本课中,你将在 MySQL 中创建全文索引,用 MATCH … AGAINST 在自然语言模式和布尔模式下搜索,了解哪些规则会让某些单词搜不到,并看看 PostgreSQL 如何解决同样的问题。
SQL 中的全文索引
在前面的课程中,你学习了 B-tree 索引如何加快按值或按值的开头进行的搜索。在文本中间查找一个单词则不同:WHERE description LIKE '%astronaut%' 无法使用 B-tree 索引,因为这个单词可能出现在字符串的任何位置。
全文索引正是为此而设计的。MySQL 示例在 Sakila 的 film_text 表上运行,这张表已经有一个全文索引;PostgreSQL 部分在 PostgreSQL 17 上验证过。
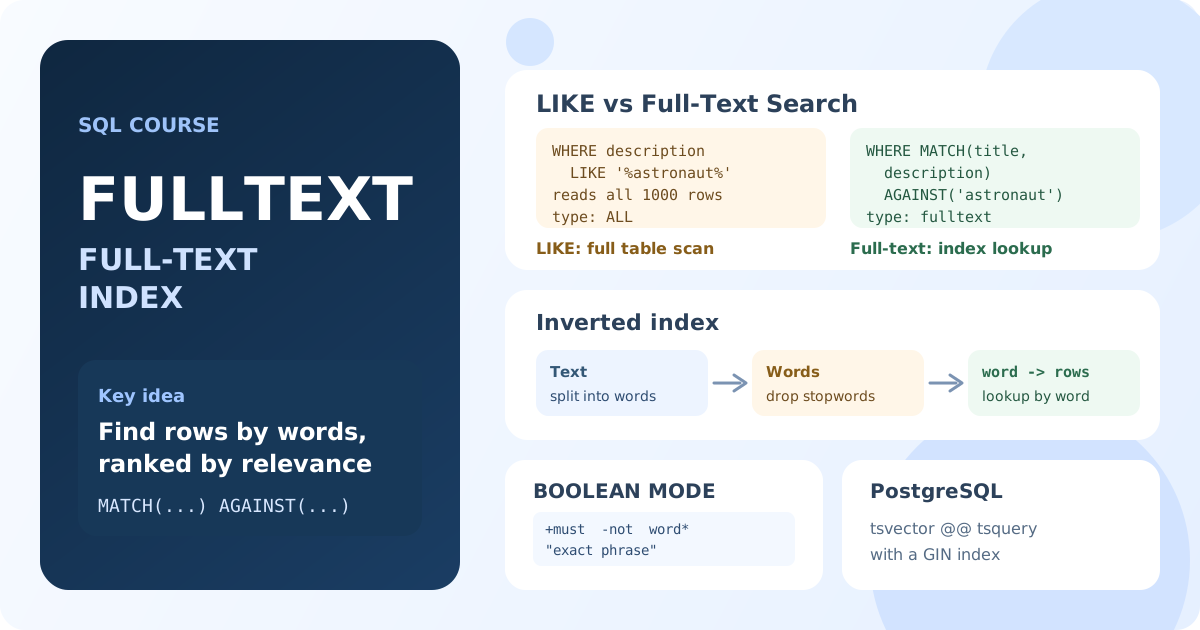
什么是全文索引?
创建全文索引时,数据库会把文本拆分成单词(词元),丢掉过短的单词和 "the"、"and" 这样的常用词(停用词),然后构建一个倒排索引:一个单词列表,每个单词都对应包含它的行。
| B-tree 索引 | 全文索引 | |
|---|---|---|
| 索引的内容 | 列的完整值 | 单个单词 |
| 快速搜索 | =、范围、LIKE 'abc%' | 文本中任意位置的单词和短语 |
LIKE '%单词%' | 不使用 | 同样不使用 |
| 结果顺序 | 按值 | 按相关度 |
| MySQL 语法 | WHERE col = … | WHERE MATCH(col) AGAINST(…) |
全文索引只配合自己的搜索语法使用:MySQL 中是 MATCH … AGAINST,PostgreSQL 中是 @@。普通的 LIKE 永远不会使用它。
在 MySQL 中创建全文索引
全文索引建在 CHAR、VARCHAR 或 TEXT 类型的列上:
CREATE FULLTEXT INDEX ft_film_description ON film (title, description);
也可以用 ALTER TABLE film ADD FULLTEXT INDEX ft_film_description (title, description);,或在 CREATE TABLE 中定义。SQLtest 上的示例数据库是只读的,请在你自己的数据库中执行这些语句。
Sakila 的 film_text 表上已经有这样的索引:
SHOW INDEX FROM film_text;
结果:film_id 上的 PRIMARY(类型 BTREE),以及 title 和 description 两列上的 idx_title_description(类型 FULLTEXT)。
用 MATCH … AGAINST 搜索
MATCH 列出被索引的列,AGAINST 写要查找的单词:
SELECT film_id, title,
    ROUND(MATCH(title, description) AGAINST ('astronaut crocodile'), 3) AS score
FROM film_text
WHERE MATCH(title, description) AGAINST ('astronaut crocodile')
ORDER BY score DESC
LIMIT 5;
结果:PHANTOM GLORY(4.239)、STONE FIRE(4.196)、ROAD ROXANNE、NEIGHBORS CHARADE(4.153)和 LOVELY JINGLE(3.146)。同时包含两个单词的电影排在前面。
这是自然语言模式(natural language mode),也是默认模式。只要包含其中任意一个单词,行就会匹配:这里有 173 部电影包含 "astronaut" 或 "crocodile"。在 SELECT 中使用同样的 MATCH … AGAINST 会返回相关度得分,可以按它对结果排序。
MATCH 中的列必须与某个全文索引的列完全一致。MATCH(description) AGAINST ('astronaut') 会报错 "Can't find FULLTEXT index matching the column list",因为索引是建在 title 和 description 两列上的。
布尔模式
IN BOOLEAN MODE 增加了用于精确搜索的运算符:
| 运算符 | 含义 | 示例 | film_text 中的电影数 |
|---|---|---|---|
+ | 必须包含该单词 | '+astronaut +crocodile' | 4 |
- | 不能包含该单词 | '+astronaut -crocodile' | 74 |
* | 前缀 | 'dino*' | 3 |
" " | 精确短语 | '"mad scientist"' | 97 |
SELECT film_id, title
FROM film_text
WHERE MATCH(title, description) AGAINST ('+astronaut +crocodile' IN BOOLEAN MODE);
结果:标题或描述中同时包含两个单词的 4 部电影。
不带运算符时,布尔模式同样会找出包含任意一个单词的行,但不会按相关度排序。
全文搜索与 LIKE 的对比
比较两种搜索的执行计划:
EXPLAIN SELECT film_id FROM film_text WHERE MATCH(title, description) AGAINST ('astronaut');

EXPLAIN SELECT film_id FROM film_text WHERE description LIKE '%astronaut%';
结果:第一个查询使用索引 idx_title_description(访问类型 fulltext);第二个查询读取全部 1000 行(类型 ALL)。
两种搜索找到的内容也不同:
LIKE '%cat%'匹配任意子串:"cat",也包括 "category" 和 "Catherine"。全文索引查找的是完整的单词。LIKE在一列中检查一个模式;全文搜索可以在多列中查找多个单词,并对结果排序。- 在有数百万行的表上,
LIKE '%单词%'要读取每一行,而全文索引只读取该单词对应的行列表。
让初学者意外的规则
有些单词根本搜不到,这并不是 bug:
- 单词最小长度。更短的单词不会被索引:InnoDB 中是 3 个字符(
innodb_ft_min_token_size),MyISAM 中是 4 个(ft_min_word_len)。film_text是 MyISAM 表,所以AGAINST ('cat')在这张表上什么也找不到,而 InnoDB 表可以找到 "cat"。 - 停用词。"the"、"a"、"and" 这样的常用词会被跳过:
AGAINST ('the')返回 0 行。 - MySQL 不处理词形变化。索引按原样保存单词:"running" 找不到 "run"。如果要匹配不同的词尾,请在布尔模式下使用前缀:
'run*'。 - 50% 规则。在 MyISAM 的自然语言模式下,出现在超过一半行中的单词会被视为过于常见而被忽略。
最小长度和停用词列表是服务器设置,修改后需要重建索引。
PostgreSQL 中的全文搜索
PostgreSQL 没有 FULLTEXT 关键字。文本会被转换成 tsvector(规范化单词的列表),查询转换成 tsquery,再用 @@ 运算符检查是否匹配:
SELECT to_tsvector('english', 'Runners should run slowly at first');
结果:'first':6 'run':3 'runner':1 'slowli':4。单词被还原为词干,"should" 和 "at" 作为停用词被丢弃。
由于使用了词干,搜索 "run" 也能找到 "running","cats" 能找到 "cat",这是 MySQL 做不到的。为了提高速度,可以把 tsvector 保存在生成列中,并为它建立 GIN 索引——这是 PostgreSQL 用于全文搜索的索引类型:
ALTER TABLE film
ADD COLUMN search tsvector
    GENERATED ALWAYS AS (to_tsvector('english', title || ' ' || description)) STORED;

CREATE INDEX film_search_idx ON film USING GIN (search);

SELECT title, ts_rank(search, query) AS rank
FROM film, websearch_to_tsquery('english', 'astronaut -crocodile') AS query
WHERE search @@ query
ORDER BY rank DESC
LIMIT 5;
说明:websearch_to_tsquery 支持搜索引擎式的语法:用引号表示短语,用 or,用 - 排除单词。ts_rank 相当于 MySQL 中的相关度得分。
其他数据库有各自的工具:SQL Server 使用全文目录以及 CONTAINS 和 FREETEXT,SQLite 使用 FTS5 扩展。如果要在数百万份文档中搜索并处理拼写错误和同义词,项目通常会使用 Elasticsearch 这样的专用搜索引擎。
什么时候使用全文索引
适合的场景:
- 在描述、文章、评论、商品名称中按单词搜索;
- 结果需要按相关度排序的"搜索框"功能;
LIKE '%单词%'已经变慢的大表。
不适合的场景:
- 按精确值或值的开头搜索:B-tree 索引做得更好;
- 短代码,以及比单词最小长度还短的值;
- 在单词内部搜索任意子串,例如商品编号的一部分。
本课要点:
- 全文索引把每个单词映射到包含它的行;
LIKE '%单词%'既不使用 B-tree 索引,也不使用全文索引。 - 在 MySQL 中用
FULLTEXT INDEX创建全文索引,用MATCH(列) AGAINST('单词')搜索;列必须与索引完全一致。 - 自然语言模式返回包含任意单词的行并按相关度排序;布尔模式增加了
+、-、*和短语。 - 短单词和停用词不会被索引,MySQL 也不处理词形变化:"running" 找不到 "run"。
- PostgreSQL 使用
tsvector、tsquery、@@运算符和 GIN 索引,并且会处理词形变化。
常见问题
SQL 中的全文索引是什么?
它是对文本列中单词建立的索引:对每个单词,数据库保存包含该单词的行。它让按单词搜索变得很快,并且可以按相关度对结果排序。
为什么 LIKE '%单词%' 不使用索引?
B-tree 索引按值的开头排序,而以 % 开头的模式可能在字符串的任意位置匹配,所以数据库不得不读取每一行。用 MATCH … AGAINST 或 @@ 进行的全文搜索会使用全文索引。
为什么全文搜索查不到短单词?
比最小长度短的单词(InnoDB 中 3 个字符,MyISAM 中 4 个)以及 "the" 这样的停用词不会被索引。可以换一个更长的单词、改用其他搜索方式,或者修改服务器设置并重建索引。
自然语言模式和布尔模式有什么区别?
自然语言模式查找包含任意单词的行并按相关度排序。布尔模式支持运算符:+ 表示必须包含的单词,- 表示排除单词,* 表示前缀,引号表示短语。
面试题
全文索引和 B-tree 索引有什么区别?
B-tree 索引按顺序保存列的完整值,适合等值、范围和前缀搜索。全文索引保存单个单词以及包含它们的行,适合在文本任意位置查找单词和短语,并能按相关度排序。
如何加快大表上 LIKE '%关键词%' 的搜索?
在被搜索的列上添加全文索引,并在 MySQL 中改写为 MATCH … AGAINST,或在 PostgreSQL 中使用 tsvector 列、GIN 索引和 @@。同时要确认搜索的单词不短于最小长度,也不是停用词。
为什么全文搜索返回的行可能比 LIKE 少?
全文搜索匹配完整的单词,而 LIKE 匹配子串,所以用 LIKE 搜索 "cat" 也会找到 "category"。短单词、停用词,以及在 MySQL 中其他词形,全文索引根本找不到。