ROW_NUMBER vs RANK vs DENSE_RANK vs NTILE
Lição 7.2 · Tempo de leitura: ~8 min · Tarefas para praticar ↓
As funções de ranking em SQL numeram linhas numa ordem definida: ROW_NUMBER, RANK e DENSE_RANK atribuem posições, e NTILE divide as linhas em grupos. Só diferem na forma como tratam os empates, linhas com valores iguais, e é essa diferença que decide se um relatório está correto. Nesta lição, você vai compará-las todas com os mesmos dados reais, ver por que o ROW_NUMBER precisa de um critério de desempate e saber que função serve para cada tarefa.
Na lição anterior, você usou ROW_NUMBER() para numerar pagamentos. As funções de ranking seguem o mesmo padrão: uma função, depois OVER com um ORDER BY que define o que significa "primeiro", e um PARTITION BY opcional que recomeça o ranking em cada grupo. As funções de ranking ignoram as molduras de janela: olham sempre para a partição inteira.
Os exemplos são executados no banco de exemplo Sakila (MySQL 8.0).
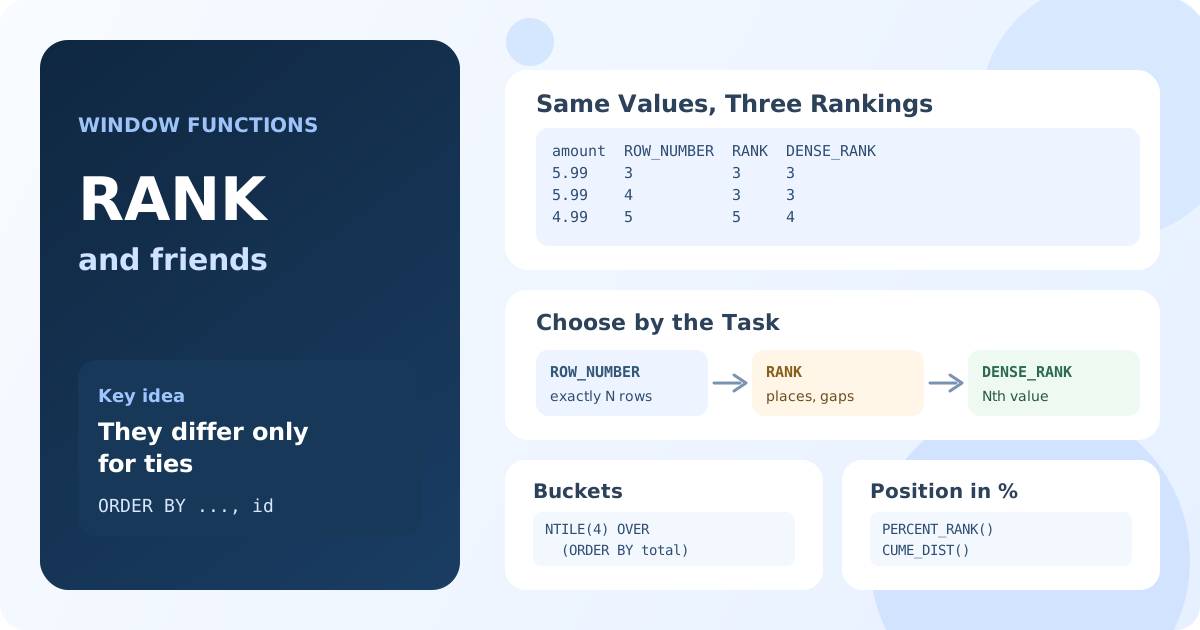
As Três Funções Lado a Lado
O cliente 1 fez 32 pagamentos. Vários são iguais: quatro pagamentos de 5.99 e oito de 4.99. Vamos classificar os pagamentos do maior para o menor:
SELECT
    payment_id,
    amount,
    ROW_NUMBER() OVER (ORDER BY amount DESC, payment_id) AS row_num,
    RANK()       OVER (ORDER BY amount DESC) AS rnk,
    DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
FROM payment
WHERE customer_id = 1
ORDER BY row_num
LIMIT 8;
Resultado: os 8 maiores pagamentos do cliente 1.
| payment_id | amount | row_num | rnk | dense_rnk |
|---|---|---|---|---|
| 5 | 9.99 | 1 | 1 | 1 |
| 14 | 7.99 | 2 | 2 | 2 |
| 3 | 5.99 | 3 | 3 | 3 |
| 10 | 5.99 | 4 | 3 | 3 |
| 11 | 5.99 | 5 | 3 | 3 |
| 32 | 5.99 | 6 | 3 | 3 |
| 6 | 4.99 | 7 | 7 | 4 |
| 7 | 4.99 | 8 | 7 | 4 |
ROW_NUMBERdá a cada linha o seu próprio número: 1, 2, 3, 4, … Valores iguais recebem números diferentes.RANKdá a mesma posição a valores iguais e depois salta números: quatro pagamentos partilham a posição 3, por isso a seguinte é a 7. É o "ranking de competição", como os lugares numa corrida.DENSE_RANKdá a mesma posição a valores iguais sem lacunas: depois da posição 3 vem a 4. O número de posições distintas é igual ao número de valores distintos.
O ROW_NUMBER Precisa de um Critério de Desempate
Entre valores iguais, o ROW_NUMBER tem mesmo assim de escolher uma ordem, e o banco de dados pode escolher qualquer uma. Sem payment_id no ORDER BY acima, o MySQL numerou os quatro pagamentos de 5.99 como 4, 5, 6, 3, e outra execução ou outra versão do servidor poderia fazê-lo de outra forma. Um relatório que dependa da "linha número 3" mudaria então entre execuções.
Sempre que usar ROW_NUMBER para algo que importa, como paginação ou "manter a primeira linha", acrescente uma coluna única ao ORDER BY dentro do OVER, por exemplo a chave primária. RANK e DENSE_RANK não precisam disso: valores iguais recebem de qualquer forma posições iguais.
NTILE: Dividir as Linhas em Grupos
O NTILE(n) não classifica valores; distribui as linhas ordenadas por n grupos de tamanho quase igual e devolve o número do grupo. É a forma padrão de construir quartis, decis ou segmentos "top 10%".
Divida os clientes de cada loja em quartis de gastos:
WITH customer_total AS (
    SELECT c.store_id, c.customer_id, SUM(p.amount) AS total_paid
    FROM customer c
    JOIN payment p ON p.customer_id = c.customer_id
    GROUP BY c.store_id, c.customer_id
),
segmented AS (
    SELECT
        store_id,
        total_paid,
        NTILE(4) OVER (PARTITION BY store_id ORDER BY total_paid DESC) AS quartile
    FROM customer_total
)
SELECT
    store_id,
    quartile,
    COUNT(*) AS customers,
    MIN(total_paid) AS min_paid,
    MAX(total_paid) AS max_paid
FROM segmented
GROUP BY store_id, quartile
ORDER BY store_id, quartile;
Resultado: 8 linhas; a loja 1 tem 326 clientes divididos em 82, 82, 81 e 81; o seu quartil superior pagou de 128.73 a 216.54.
| store_id | quartile | customers | min_paid | max_paid |
|---|---|---|---|---|
| 1 | 1 | 82 | 128.73 | 216.54 |
| 1 | 2 | 82 | 111.74 | 128.73 |
| 1 | 3 | 81 | 96.72 | 111.73 |
| 1 | 4 | 81 | 50.85 | 95.78 |
| 2 | 1 | 69 | 127.68 | 221.55 |
| ... | ... | ... | ... | ... |
Quando as linhas não se dividem por igual, os primeiros grupos ficam com uma linha a mais. O NTILE divide por número de linhas, não por valor: valores iguais numa fronteira podem cair em grupos diferentes, como 128.73 aqui.
PERCENT_RANK e CUME_DIST
Mais duas funções exprimem a posição como uma fração entre 0 e 1:
PERCENT_RANK()= (posição − 1) / (linhas − 1): a fração de linhas classificadas estritamente à frente. A primeira linha recebe 0.CUME_DIST()= linhas com valor até ao atual, inclusive / todas as linhas: a fração de linhas nessa posição ou à frente.
SELECT
    payment_id,
    amount,
    ROUND(PERCENT_RANK() OVER (ORDER BY amount DESC), 2) AS pct_rank,
    ROUND(CUME_DIST() OVER (ORDER BY amount DESC), 2) AS cumulative_share
FROM payment
WHERE customer_id = 1
ORDER BY amount DESC, payment_id
LIMIT 4;
Resultado: o pagamento de 9.99 tem pct_rank 0 e cumulative_share 0.03; cada pagamento de 5.99 tem pct_rank 0.06 e cumulative_share 0.19, porque 6 dos 32 pagamentos são de 5.99 ou mais.
São úteis para filtros do tipo "top 10% dos clientes": WHERE cumulative_share <= 0.1 numa consulta externa. Não chame à coluna cume_dist nem rank: no MySQL 8 são palavras reservadas.
Que Função Usar
| Tarefa | Função |
|---|---|
| Exatamente N linhas por grupo, última linha, paginação | ROW_NUMBER com critério de desempate |
| Lugares numa competição: resultados iguais partilham o lugar, o seguinte é saltado | RANK |
| N-ésimo valor distinto, como o segundo maior salário | DENSE_RANK |
| Quartis, decis, segmentos de tamanho igual | NTILE(n) |
| Posição relativa em percentagem | PERCENT_RANK, CUME_DIST |
Duas tarefas baseadas nestas funções são tratadas em detalhe nas lições de tarefas de entrevista: top N linhas por grupo (Lição 12.6) e o N-ésimo maior salário (Lição 12.4).
Um filtro RANK() <= N em uma consulta externa também substitui FETCH FIRST n ROWS WITH TIES no MySQL e no SQLite, que não suportam WITH TIES: veja a lição 2.9.
Principais conclusões:
ROW_NUMBER,RANKeDENSE_RANKsó diferem nos empates: números únicos, posições partilhadas com lacunas, posições partilhadas sem lacunas.- Para os valores 9.99, 7.99, 5.99, 5.99, 4.99, devolvem 1-2-3-4-5, 1-2-3-3-5 e 1-2-3-3-4.
- Com
ROW_NUMBER, acrescente um critério de desempate único aoORDER BY, ou a numeração dos valores iguais é arbitrária. NTILE(n)divide as linhas ordenadas emngrupos quase iguais pelo número de linhas.PERCENT_RANKeCUME_DISTdão a posição como uma fração entre 0 e 1.
Perguntas Frequentes
Qual é a diferença entre ROW_NUMBER, RANK e DENSE_RANK?
As três numeram as linhas pelo ORDER BY do OVER. O ROW_NUMBER dá sempre números únicos. O RANK dá a mesma posição a valores iguais e salta os números seguintes (1, 2, 2, 4). O DENSE_RANK dá a mesma posição a valores iguais sem saltar números (1, 2, 2, 3).
Quando devo usar RANK em vez de DENSE_RANK?
Use RANK quando a posição deve refletir quantas linhas estão à frente, como nos resultados desportivos: dois vencedores partilham o 1.º lugar e o seguinte é o 3.º. Use DENSE_RANK quando precisa de níveis consecutivos de valores distintos, por exemplo "o segundo preço mais alto".
Como o NTILE trata linhas que não se dividem por igual?
Os primeiros grupos recebem uma linha extra. Com 326 linhas e NTILE(4), os grupos têm 82, 82, 81 e 81 linhas. O NTILE conta linhas, por isso valores iguais podem ficar divididos entre dois grupos vizinhos.
Por que o ROW_NUMBER dá resultados diferentes para a mesma consulta?
Porque o ORDER BY dentro do OVER tem empates, e o banco de dados pode ordenar as linhas iguais de forma diferente entre execuções. Acrescente uma coluna única, como a chave primária, como última chave de ordenação para tornar a numeração determinística.