Lição 5.9 · Tempo de leitura: ~9 min
Os algoritmos de junção em SQL são os métodos que um banco de dados usa para executar uma junção: nested loop join, hash join e merge join. Nesta lição, você vai aprender como funciona cada algoritmo, quando o planejador de consultas o escolhe, quais bancos de dados suportam quais algoritmos e como ver o escolhido com EXPLAIN.
Algoritmos de Junção em SQL: Como o Banco de Dados Executa as Junções
Nas lições anteriores, você escreveu junções pensando em quais linhas elas devolvem. A mesma junção pode ser executada de formas muito diferentes, e em tabelas grandes a diferença entre elas é de segundos contra horas. Você não escolhe o algoritmo em SQL; quem escolhe é o planejador de consultas. Mas saber como os algoritmos funcionam explica por que os índices nas colunas de junção importam e como ler planos de execução.
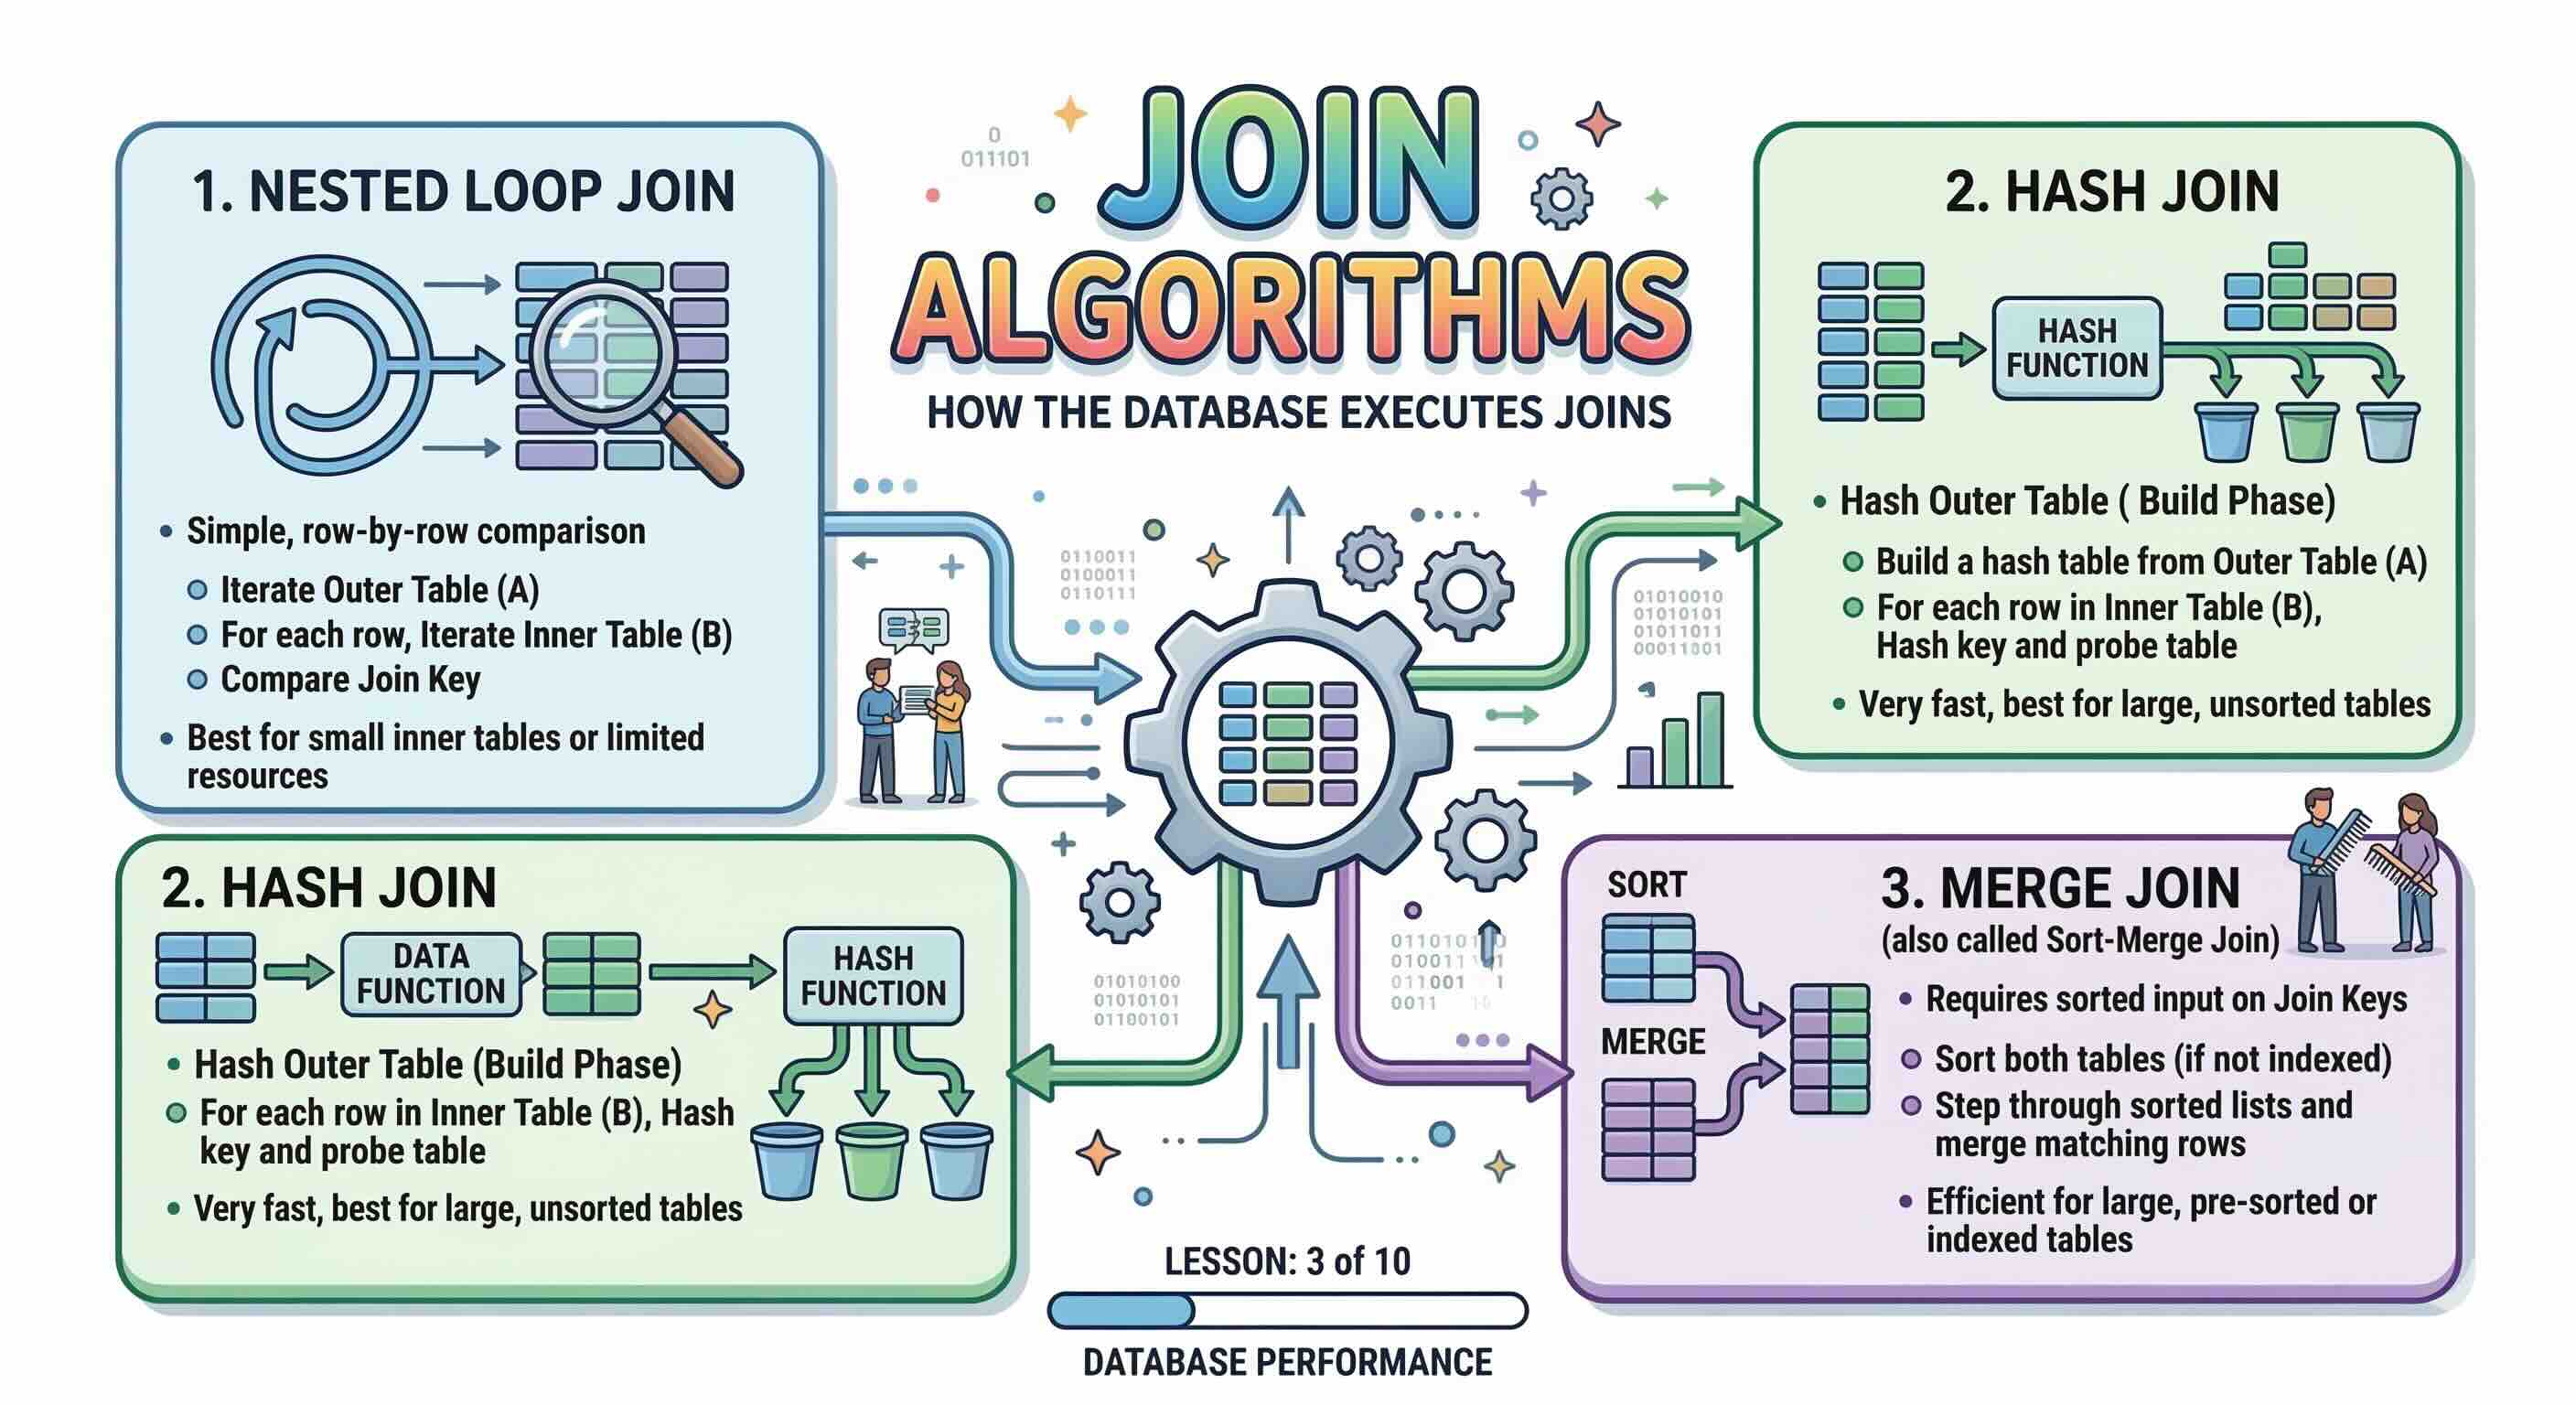
Nested Loop Join
Como Funciona
O banco de dados toma uma tabela como externa (condutora) e, para cada uma das suas linhas, procura correspondências na tabela interna: dois laços aninhados.
for each row R1 in outer_table:
    for each row R2 in inner_table:
        if R1.key = R2.key:
            output(R1, R2)
Sem índice, a tabela interna é percorrida por inteiro para cada linha externa: N × M comparações. Com um índice na coluna de junção da tabela interna, cada procura torna-se uma busca rápida no índice. Esse index nested loop join é um dos planos mais eficientes quando o lado externo é pequeno.
Quando o Planejador o Usa
- A tabela externa, ou o lado externo depois do filtro, é pequena.
- A tabela interna tem um índice na coluna de junção.
- A condição de junção não é uma igualdade (
<,>,BETWEEN): os hash e merge joins clássicos só funcionam com igualdade.
| Vantagens | Desvantagens |
|---|---|
| Funciona com qualquer condição de junção | Muito lento em tabelas grandes sem índice: N × M |
| Muito rápido com um lado externo pequeno e um índice | O custo cresce depressa com o tamanho das duas tabelas |
| Pouca memória; devolve as primeiras linhas imediatamente |
Hash Join
Como Funciona
Um hash join tem duas fases:
- Construção (build): o banco de dados lê a entrada menor e constrói em memória uma tabela hash pela coluna de junção.
- Sondagem (probe): lê a entrada maior e procura a chave de cada linha na tabela hash.
-- build
for each row R1 in smaller_input:
    hash_table[hash(R1.key)].append(R1)

-- probe
for each row R2 in larger_input:
    for each R1 in hash_table[hash(R2.key)]:
        if R1.key = R2.key:
            output(R1, R2)
Cada entrada é lida uma vez, por isso o custo é de cerca de N + M: muito melhor do que um nested loop sem índices.
Quando o Planejador o Usa
- Duas entradas grandes juntadas por igualdade.
- Nenhum índice útil nas colunas de junção.
- Memória suficiente para a tabela hash (
work_memno PostgreSQL,join_buffer_sizeno MySQL).
| Vantagens | Desvantagens |
|---|---|
Eficiente para junções grandes sem índices: N + M | O hash join clássico precisa de uma condição de igualdade |
| Não precisa de índices nem de entrada ordenada | Usa memória; vai para o disco se a tabela hash não couber |
| Precisa construir a tabela hash antes de devolver a primeira linha |
Merge Join
Como Funciona
Um merge join (sort-merge join) precisa que as duas entradas estejam ordenadas pela coluna de junção. Depois percorre as duas listas ordenadas ao mesmo tempo, como no passo de fusão do merge sort:
sort outer by key   -- skipped if read through an ordered index
sort inner by key   -- skipped if read through an ordered index

while neither input is exhausted:
    if outer.key = inner.key: output matches, advance
    elif outer.key < inner.key: advance outer
    else: advance inner
Se as duas entradas puderem ser lidas em ordem por meio de índices, a ordenação não custa nada e a fusão é muito rápida.
Quando o Planejador o Usa
- Entradas grandes juntadas por igualdade.
- As duas entradas já estão ordenadas ou podem ser lidas por índices ordenados.
- A consulta ordena pela coluna de junção de qualquer forma (
ORDER BY,GROUP BY,DISTINCT).
| Vantagens | Desvantagens |
|---|---|
| Muito rápido com entrada pré-ordenada ou indexada | Só condições de igualdade |
| O resultado já sai ordenado pela chave de junção | Ordenar explicitamente uma entrada desordenada é caro |
| Uso de memória previsível |
Qual Banco de Dados Usa Qual Algoritmo
| Banco de dados | Nested loop | Hash join | Merge join |
|---|---|---|---|
| PostgreSQL | Sim | Sim | Sim |
| SQL Server, Oracle | Sim | Sim | Sim |
| MySQL 8.0.18+ | Sim | Sim (substituiu o Block Nested Loop na 8.0.20) | Não |
| MariaDB | Sim (incl. block nested loop, BKA) | Sim (block hash join) | Não |
| SQLite | Sim | Não | Não |
No MySQL, o hash join também é usado em junções sem condição de igualdade e em produtos cartesianos, então a regra "só igualdade" aplica-se ao algoritmo clássico, não a todas as implementações.
Ver o Algoritmo no EXPLAIN
EXPLAIN mostra o plano que o banco de dados escolheu; EXPLAIN ANALYZE (MySQL 8.0.18+, PostgreSQL) também executa a consulta e informa o tempo real de cada passo:
EXPLAIN ANALYZE
SELECT a.first_name, a.last_name, f.title
FROM actor AS a
INNER JOIN film_actor AS fa ON fa.actor_id = a.actor_id
INNER JOIN film AS f ON f.film_id = fa.film_id;
Resultado: o plano de execução em forma de árvore. No MySQL, procure Nested loop inner join ou Inner hash join; no PostgreSQL, Nested Loop, Hash Join ou Merge Join.
Aqui o MySQL usa laços aninhados: film_actor e film têm índices nas colunas de junção, por isso cada procura é uma busca num índice.
Como Ajudar o Planejador
- Indexe as colunas de chaves estrangeiras usadas em junções: isso permite o index nested loop.
- Filtre cedo: um
WHEREseletivo torna o lado externo pequeno. - Mantenha as estatísticas atualizadas (
ANALYZE TABLEno MySQL,ANALYZEno PostgreSQL): o planejador escolhe com base em estimativas do número de linhas. - Verifique as configurações de memória se um hash join for para o disco com dados grandes.
Principais conclusões:
- O nested loop join procura na tabela interna para cada linha externa; rápido com um lado externo pequeno e um índice, funciona com qualquer condição.
- O hash join constrói uma tabela hash a partir da entrada menor e a sonda; eficiente para junções grandes por igualdade sem índices, mas usa memória.
- O merge join funde duas entradas ordenadas; ideal quando os dados já estão ordenados por um índice.
- MySQL e MariaDB não têm merge join; PostgreSQL, SQL Server e Oracle têm os três.
- Você influencia a escolha com índices, filtros, estatísticas e configurações de memória, e a verifica com
EXPLAIN ANALYZE.
Perguntas Frequentes
Qual é a diferença entre um nested loop join e um hash join?
Um nested loop join procura correspondências na tabela interna para cada linha externa, o que é rápido quando há um índice e o lado externo é pequeno. Um hash join lê cada entrada uma vez e emparelha as linhas por meio de uma tabela hash em memória, o que é mais rápido para duas entradas grandes sem índices úteis.
O MySQL suporta hash join?
Sim, desde o MySQL 8.0.18. Desde a 8.0.20, ele substitui o algoritmo block nested loop em junções que não podem usar um índice. O MySQL não tem merge join.
Posso forçar um algoritmo de junção específico?
Não em SQL padrão. Alguns bancos de dados oferecem dicas: as optimizer hints do MySQL como HASH_JOIN / NO_HASH_JOIN (dependem da versão), OPTION (HASH JOIN) no SQL Server, configurações do PostgreSQL como enable_hashjoin. Use-as para diagnóstico; em consultas de produção, melhores índices e estatísticas costumam ser a solução certa.