Requêtes SQL efficaces : écrire du SQL plus rapide et plus léger
Leçon 10.2 · Temps de lecture : ~10 min · Exercices pratiques ↓
Cette leçon présente les bases de l'écriture de requêtes SQL performantes. Vous allez apprendre à éviter la charge inutile sur la base, comprendre pourquoi SELECT * ralentit souvent l'exécution, et filtrer les données correctement. Nous allons étudier des techniques pratiques pour accélérer les requêtes sur de gros volumes. À la fin, vous saurez écrire un SQL efficace et respectueux des ressources serveur.
Dans la leçon précédente, nous avons parlé de lisibilité pour les humains. Mais une requête SQL doit aussi être efficace pour le moteur de base de données. Même un code bien formaté peut être lent s'il force le serveur à faire trop de travail.
L'efficacité d'une requête impacte directement la vitesse des applications et des rapports. Sur des systèmes à forte charge, la différence entre une requête "fonctionnelle" et "optimisée" peut être énorme.
Les SGBD modernes disposent d'optimiseurs puissants, mais ils ne connaissent pas votre logique métier et ne corrigent pas tout. La responsabilité de la qualité SQL reste côté développeur.
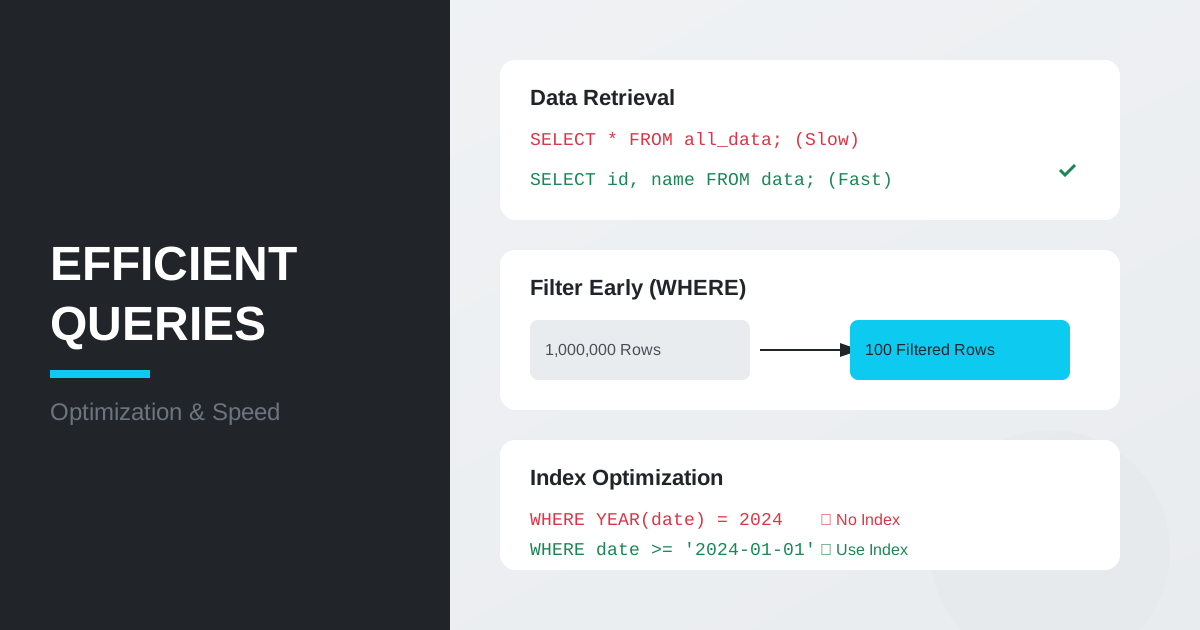
Règle d'or : ne récupérer que le nécessaire
Une cause fréquente de lenteur est le transfert de données inutiles entre serveur et client.
Éviter SELECT *
SELECT * est pratique pour explorer, mais il faut l'éviter dans le code final.
- Trafic inutile : vous envoyez des colonnes non nécessaires.
- Moins de plans index-friendly : les index couvrants deviennent moins exploitables.
- Code fragile : l'ajout d'une colonne peut impacter comportement et performance.
-- Mauvais
SELECT * FROM film;

-- Mieux
SELECT film_id, title, release_year
FROM film;
Optimisation du filtrage
La façon de limiter les lignes détermine le volume de travail du SGBD.
Filtrer le plus tôt possible
Appliquez WHERE avant les opérations lourdes. Moins de lignes en amont signifie des JOIN et GROUP BY plus rapides.
Éviter les fonctions dans WHERE (requêtes SARGable)
Pour profiter des index, les prédicats WHERE doivent être SARGable. Si vous appliquez une fonction sur une colonne indexée, l'optimiseur risque de ne pas utiliser l'index efficacement.
-- Lent (Non-SARGable)
SELECT count(*)
FROM rental
WHERE YEAR(rental_date) = 2005;

-- Rapide (SARGable)
SELECT count(*)
FROM rental
WHERE rental_date >= '2005-01-01' AND rental_date < '2006-01-01';
Travail avec les JOIN
Les jointures sont parmi les opérations les plus coûteuses.
- Filtrer avant de joindre quand c'est possible.
- Vérifier les index sur les clés de jointure.
- Éviter
CROSS JOINsans besoin réel. - Utiliser
EXISTSpour des vérifications d'existence simples.
-- Moins efficace
SELECT DISTINCT c.first_name, c.last_name
FROM customer c
JOIN payment p ON c.customer_id = p.customer_id;

-- Plus efficace pour un test d'existence
SELECT c.first_name, c.last_name
FROM customer c
WHERE EXISTS (
    SELECT 1 FROM payment p WHERE p.customer_id = c.customer_id
);
Utiliser LIMIT pendant les tests
Pendant le débogage, utilisez LIMIT pour éviter de retourner des millions de lignes.
SELECT customer_id, first_name, last_name
FROM customer
WHERE active = 1
LIMIT 10;
Exemple pratique : optimisation d'un rapport
Supposons que nous cherchions les films loués plus de 30 fois dans une catégorie donnée.
Approche moins efficace :
SELECT f.title, COUNT(r.rental_id)
FROM film f
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
JOIN film_category fc ON f.film_id = fc.film_id
JOIN category c ON fc.category_id = c.category_id
WHERE c.name = 'Action'
GROUP BY f.title
HAVING COUNT(r.rental_id) > 30;
Approche plus efficace : Si l'ID de catégorie est connu, on évite une jointure inutile.
SELECT f.title, COUNT(r.rental_id) AS rental_count
FROM film f
JOIN film_category fc ON f.film_id = fc.film_id
JOIN inventory i ON f.film_id = i.film_id
JOIN rental r ON i.inventory_id = r.inventory_id
WHERE fc.category_id = 1 -- Utiliser l'ID plutôt que la chaîne
GROUP BY f.film_id, f.title
HAVING COUNT(r.rental_id) > 30;
Remarque : filtrer sur un identifiant numérique est souvent plus rapide que filtrer sur un libellé texte.
Points clés à retenir de cette leçon :
- Évitez
SELECT *en production. - Filtrez les données le plus tôt possible.
- Écrivez des conditions SARGable pour exploiter les index.
- Préférez
EXISTSàJOINpour des tests d'existence. - Utilisez
LIMITpour l'exploration et le debug. - Préférez les filtres sur clés numériques.
Questions fréquentes
Pourquoi SELECT * est-il problématique en production ?
Il retourne des colonnes inutiles, augmente le trafic et peut dégrader les plans d'exécution. Lister explicitement les colonnes est plus sûr.
Que signifie SARGable en pratique ?
Une condition SARGable permet une recherche via index. Les fonctions appliquées aux colonnes indexées bloquent souvent cet avantage.
Quand utiliser EXISTS plutôt que JOIN ?
Quand vous voulez seulement vérifier l'existence d'une ligne liée, sans récupérer de colonnes de la table secondaire.
Questions d'entretien
Quelles sont vos premières actions face à une requête SQL lente ?
Je vérifie SELECT *, la sélectivité des filtres WHERE, puis les prédicats non SARGable. Ensuite j'analyse les jointures et le volume de lignes traitées.
Pourquoi filtrer tôt accélère l'exécution ?
Parce que cela réduit les lignes impliquées dans les jointures, tris et agrégations, ce qui baisse le coût global du plan.
Différence performance entre JOIN et EXISTS ?
JOIN combine les jeux de lignes et est nécessaire si vous avez besoin de colonnes des deux tables. EXISTS est souvent plus efficace pour un simple test oui/non.