Comment lire EXPLAIN
Leçon 10.4 · Temps de lecture : ~12 min · Exercices pratiques ↓
EXPLAIN montre comment la base de données va exécuter votre requête : quelles tables elle lit, dans quel ordre, si elle utilise un index et combien de lignes elle attend. Dans cette leçon, vous lirez ligne par ligne de vrais plans de MySQL et de PostgreSQL, comparerez les estimations de l'optimiseur aux chiffres réels d'EXPLAIN ANALYZE et apprendrez les signes d'une requête lente.
Dans la leçon précédente, vous avez créé des index. Mais un index n'aide que si la base l'utilise vraiment, et le seul moyen de le savoir est de regarder le plan d'exécution. Le plan remplace les suppositions par des faits : au lieu de « la requête est lente, il manque peut-être un index », vous voyez exactement quelle étape lit trop de lignes.
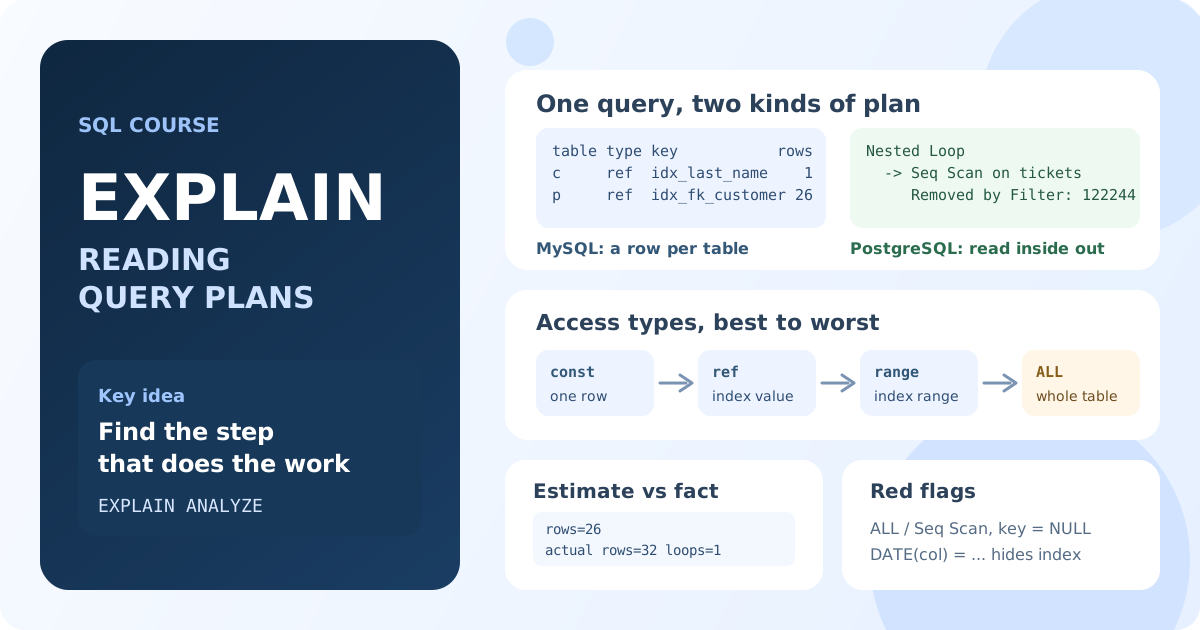
Qu'est-ce qu'un plan d'exécution
Avant d'exécuter une requête, l'optimiseur choisit comment s'y prendre : quelle table lire d'abord, utiliser un index ou lire toute la table, comment joindre les tables et comment trier. Le résultat de ce choix est le plan d'exécution. L'optimiseur prend le plan au coût (cost) estimé le plus bas, et il estime ce coût à partir des statistiques : le nombre de lignes de chaque table et la répartition des valeurs.
On obtient le plan en plaçant un mot-clé devant la requête :
| SGBD | Plan seul | Plan et exécution réelle |
|---|---|---|
| MySQL, MariaDB | EXPLAIN | EXPLAIN ANALYZE (MySQL 8.0.18+), ANALYZE (MariaDB) |
| PostgreSQL | EXPLAIN | EXPLAIN ANALYZE, souvent avec BUFFERS |
| SQLite | EXPLAIN QUERY PLAN | aucun |
| SQL Server | SET SHOWPLAN_TEXT ON ou « Display Estimated Execution Plan » dans SSMS | SET STATISTICS PROFILE ON ou « Include Actual Execution Plan » |
| Oracle | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | DBMS_XPLAN.DISPLAY_CURSOR |
EXPLAIN construit seulement le plan et n'exécute pas la requête. EXPLAIN ANALYZE l'exécute et ajoute le temps et le nombre de lignes réels.
MySQL : le format tableau
Cherchons les paiements des clients nommés Smith dans la base Sakila :
EXPLAIN
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
Résultat (MySQL 8.0) :
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| id | select_type | table | type | possible_keys         | key                | ref                  | rows | filtered | Extra |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| 1  | SIMPLE      | c     | ref  | PRIMARY,idx_last_name | idx_last_name      | const                | 1    | 100.00   | NULL  |
| 1  | SIMPLE      | p     | ref  | idx_fk_customer_id    | idx_fk_customer_id | sakila.c.customer_id | 26   | 100.00   | NULL  |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
Chaque ligne est une table, dans l'ordre où MySQL la lit : d'abord customer, puis, pour chaque client trouvé, payment. Voici le sens des colonnes :
table: la table (ou son alias) lue à cette étape.type: la façon d'accéder aux lignes. C'est la colonne la plus importante.possible_keys: les index utilisables ;key: l'index réellement choisi.NULLdanskeysignifie qu'aucun index n'est utilisé.ref: ce à quoi l'index est comparé : une constante (const) ou une colonne de la table précédente (sakila.c.customer_id).rows: combien de lignes MySQL s'attend à lire à cette étape. C'est une estimation, pas un fait.filtered: le pourcentage de ces lignes censé passer les autres conditions.Extra: des détails supplémentaires, voir plus bas.
Lecture du plan : MySQL trouve le client grâce à l'index sur last_name (1 ligne attendue), puis pour ce client cherche les paiements grâce à l'index sur customer_id (26 lignes attendues). Les deux étapes utilisent des index, donc la requête lit quelques dizaines de lignes parmi plus de 16 000 paiements.
Types d'accès de la colonne type
Du meilleur au pire :
type | Ce qui se passe | Exemple |
|---|---|---|
const, eq_ref | au plus une ligne par clé primaire ou unique | WHERE customer_id = 1 sur customer |
ref | plusieurs lignes par une valeur d'index | WHERE last_name = 'SMITH' |
range | une plage de l'index | BETWEEN, >, <, IN (...) |
index | l'index entier est lu | l'index contient toutes les colonnes utiles, mais aucun filtre ne porte sur sa première colonne |
ALL | la table entière est lue (full table scan) | une condition sur une colonne sans index |
ALL sur une petite table de référence ne pose pas de problème. ALL sur une grande table, dans une requête qui n'a besoin que de quelques lignes, est la première chose à corriger.
La colonne Extra
Using index: toutes les colonnes utiles sont dans l'index, la table elle-même n'est pas lue (index couvrant). Bien.Using where: les lignes sont filtrées après lecture. Normal en soi, problématique avecALLsur une grande table.Using index condition: la condition est vérifiée dans l'index avant de lire la ligne (index condition pushdown).Using temporary: une table temporaire intermédiaire est construite, en général pourGROUP BYouDISTINCT.Using filesort: les lignes sont triées à part au lieu d'être lues dans l'ordre de l'index.
Par exemple, les cinq clients qui ont le plus payé :
EXPLAIN
SELECT customer_id, SUM(amount) AS total
FROM payment
GROUP BY customer_id
ORDER BY total DESC
LIMIT 5;
Résultat : type = index, rows = 15577, Extra = Using temporary; Using filesort. MySQL lit l'index entier, regroupe les paiements dans une table temporaire et trie les sommes. Impossible de l'éviter ici : l'ordre d'une somme calculée n'est connu qu'une fois toutes les lignes regroupées. Sur 16 000 lignes, c'est rapide ; sur 100 millions, un tel rapport serait calculé à l'avance (par exemple dans une table de synthèse).
Comment une fonction cache un index
La table rental a un index sur rental_date. Comparez deux requêtes qui renvoient les mêmes 504 locations du 6 juillet 2005 :
EXPLAIN
SELECT *
FROM rental
WHERE rental_date >= '2005-07-06' AND rental_date < '2005-07-07';
Résultat : type = range, key = rental_date, rows = 504.
EXPLAIN
SELECT *
FROM rental
WHERE DATE(rental_date) = '2005-07-06';
Résultat : type = ALL, key = NULL, rows = 15831.
L'index est trié par rental_date, pas par DATE(rental_date). Quand la colonne est enveloppée dans une fonction, la base ne peut pas chercher dans l'index et vérifie chaque ligne. La solution consiste à laisser la colonne « nue » et à déplacer le calcul de l'autre côté de la comparaison, comme dans la première requête. Les conditions qui peuvent ainsi utiliser un index sont dites SARGable.
Arbres de plan : FORMAT=TREE et EXPLAIN ANALYZE dans MySQL
Le format tableau masque l'imbrication des étapes. MySQL 8 peut afficher le plan sous forme d'arbre :
EXPLAIN FORMAT=TREE
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
-> Nested loop inner join  (cost=9.45 rows=26)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26)
Un arbre se lit de l'intérieur vers l'extérieur : les lignes les plus indentées s'exécutent en premier, et chacune transmet ses lignes à celle du dessus. Ici, le premier enfant trouve le client, le second trouve les paiements de chaque client, et le Nested loop inner join au-dessus combine les lignes.
EXPLAIN ANALYZE exécute la requête et ajoute les chiffres réels à chaque étape :
-> Nested loop inner join  (cost=9.45 rows=26) (actual time=0.139..0.157 rows=32 loops=1)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1) (actual time=0.0572..0.0586 rows=1 loops=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26) (actual time=0.0555..0.0688 rows=32 loops=1)
rows=26est l'estimation,actual ... rows=32le fait. M. Smith a effectué 32 paiements, alors que les statistiques en suggéraient 26 en moyenne par client.actual time=0.0555..0.0688: les millisecondes jusqu'à la première et jusqu'à la dernière ligne de l'étape.loops: le nombre d'exécutions de l'étape. Le côté interne d'une boucle imbriquée s'exécute une fois par ligne du côté externe.
Une estimation fausse de 20 % est normale. Une estimation fausse d'un facteur 100 signifie que l'optimiseur a choisi le plan sur de mauvaises données, et que le plan peut lui aussi être mauvais.
PostgreSQL : lire l'arbre du plan
PostgreSQL affiche toujours un arbre. Une requête par clé primaire dans la base Bookings :
EXPLAIN
SELECT *
FROM bookings.flights
WHERE flight_id = 1001;
Index Scan using flights_pkey on flights  (cost=0.29..8.31 rows=1 width=63)
  Index Cond: (flight_id = 1001)
Chaque nœud indique :
- l'opération :
Seq Scan(toute la table),Index Scan(l'index puis les lignes de la table),Index Only Scan(l'index seul),Bitmap Heap Scan(réunit d'abord les lignes via l'index, puis les lit dans la table dans l'ordre de stockage) ; cost=0.29..8.31: le coût estimé jusqu'à la première ligne et pour toutes les lignes, en unités abstraites (pas en millisecondes) ;rows: le nombre estimé de lignes en sortie ;width: la taille moyenne d'une ligne en octets ;- les lignes en dessous : la condition d'index (
Index Cond) ou le filtre (Filter).
Il n'y a pas d'index sur departure_airport, donc une recherche par aéroport lit toute la table :
EXPLAIN
SELECT flight_id, scheduled_departure
FROM bookings.flights
WHERE departure_airport = 'DME';
Seq Scan on flights  (cost=0.00..806.01 rows=3217 width=12)
  Filter: (departure_airport = 'DME'::bpchar)
Ici, le parcours complet est raisonnable : la requête renvoie environ 10 % de la table, et lire 33 000 lignes à la suite coûte peu.
EXPLAIN ANALYZE dans PostgreSQL
Les billets d'une réservation :
EXPLAIN ANALYZE
SELECT t.passenger_name, tf.fare_conditions, tf.amount
FROM bookings.tickets t
JOIN bookings.ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '00000F';
Gather  (cost=1000.42..9103.17 rows=6 width=30) (actual time=409.864..415.535 rows=2.00 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Nested Loop  (cost=0.42..8102.57 rows=2 width=30) (actual time=388.369..389.800 rows=0.67 loops=3)
        ->  Parallel Seq Scan on tickets t  (cost=0.00..8086.07 rows=1 width=30) (actual time=386.664..387.206 rows=0.33 loops=3)
              Filter: (book_ref = '00000F'::bpchar)
              Rows Removed by Filter: 122244
        ->  Index Scan using ticket_flights_pkey on ticket_flights tf  (cost=0.42..16.47 rows=3 width=28) (actual time=5.061..7.713 rows=2.00 loops=1)
              Index Cond: (ticket_no = t.ticket_no)
Planning Time: 45.638 ms
Execution Time: 415.774 ms
Lecture de l'intérieur vers l'extérieur :
Parallel Seq Scan on tickets: trois processus (loops=3, le processus principal et deux workers) parcourent toute la tabletickets. Chacun écarte environ 122 000 lignes (Rows Removed by Filter) pour trouver un seul billet.Index Scan on ticket_flights: pour le billet trouvé, les segments de vol sont lus via l'index de clé primaire. Rapide : moins de 8 ms.Nested Looples joint,Gatherrassemble les résultats des workers parallèles.
La requête entière prend 415 ms, et presque tout ce temps revient à la première étape. Le goulot d'étranglement est le nœud au temps réel le plus élevé et au plus grand nombre de lignes écartées. La solution est un index sur tickets (book_ref).
Dans PostgreSQL, rows et loops se lisent ensemble : un nœud indique les lignes par exécution, le total vaut donc rows × loops. rows=0.33 loops=3 signifie une ligne au total.
Avant et après un index
Le même diagnostic sur une table de test orders de 200 000 lignes (10 000 clients, 20 commandes chacun) :
EXPLAIN ANALYZE
SELECT id, amount, created_at
FROM orders
WHERE customer_id = 42;
Sans index :
Seq Scan on orders  (cost=0.00..3774.00 rows=20 width=14) (actual time=0.030..19.330 rows=20.00 loops=1)
  Filter: (customer_id = 42)
  Rows Removed by Filter: 199980
Execution Time: 19.379 ms
Après CREATE INDEX orders_customer_id_idx ON orders (customer_id); :
Bitmap Heap Scan on orders  (cost=4.45..77.18 rows=20 width=14) (actual time=0.142..0.188 rows=20.00 loops=1)
  Recheck Cond: (customer_id = 42)
  ->  Bitmap Index Scan on orders_customer_id_idx  (cost=0.00..4.45 rows=20 width=0) (actual time=0.120..0.120 rows=20.00 loops=1)
        Index Cond: (customer_id = 42)
Execution Time: 0.293 ms
Les 199 980 lignes écartées sont tombées à zéro, et la requête est devenue environ 65 fois plus rapide. Écrivez maintenant la condition sous la forme customer_id + 0 = 42 : le plan revient à Parallel Seq Scan, et l'estimation passe à rows=1000 au lieu de 20, car l'optimiseur n'a pas de statistiques pour l'expression.
Méthodes de jointure
Un plan à plusieurs tables montre comment elles sont jointes :
- Nested Loop : pour chaque ligne de l'entrée externe, on cherche les lignes correspondantes dans l'entrée interne. Rapide quand l'entrée externe est petite et que l'interne a un index sur la colonne de jointure, comme dans tous les exemples ci-dessus.
- Hash Join : on construit une table de hachage à partir de la plus petite entrée, puis on y fait passer la plus grande. Adapté aux grandes entrées sans index utile.
- Merge Join : les deux entrées sont triées par la clé de jointure puis fusionnées. Adapté quand les données sont déjà triées, par exemple lues depuis des index.
MySQL utilise surtout des boucles imbriquées et, depuis la 8.0.18, des hash joins ; PostgreSQL et SQL Server utilisent les trois.
Signaux d'alerte dans un plan
| Signe | Ce que cela signifie en général | Que tenter |
|---|---|---|
type = ALL / Seq Scan sur une grande table avec une condition sélective | pas d'index adapté | un index sur la colonne du WHERE ou du JOIN |
key = NULL alors qu'un index existe | la condition n'est pas SARGable : fonction, expression, LIKE '%...', types différents | réécrire la condition pour garder la colonne « nue » |
un Rows Removed by Filter élevé | beaucoup de lignes sont lues puis jetées | un index, ou un index composite qui inclut le filtre |
rows estimé très différent du réel | statistiques obsolètes ou absentes | ANALYZE TABLE (MySQL), ANALYZE (PostgreSQL) |
Using temporary; Using filesort, Sort avec external merge | regroupement ou tri d'un gros résultat, peut-être sur disque | un index dans l'ordre voulu, moins de lignes avant le tri |
une boucle imbriquée avec un grand loops sur un parcours complet | le côté interne est cherché sans index | un index sur la colonne de jointure du côté interne |
Regardez le plan dans son ensemble. Le but n'est pas de supprimer chaque parcours complet, mais de trouver l'étape qui consomme le plus de temps.
Utiliser EXPLAIN ANALYZE sans risque
EXPLAIN ANALYZE exécute réellement la requête. Pour un SELECT, cela ne coûte que du temps, mais EXPLAIN ANALYZE UPDATE ... ou DELETE ... modifie les données. Dans PostgreSQL, placez une telle vérification dans une transaction :
BEGIN;
EXPLAIN ANALYZE
UPDATE orders SET amount = amount * 1.1 WHERE customer_id = 42;
ROLLBACK;
Souvenez-vous aussi que la première exécution peut lire les données sur disque, et les suivantes en mémoire. Comparez plans et temps après plusieurs exécutions, et sur des données d'un volume proche de la production : sur une table de 100 lignes, presque n'importe quel plan est rapide.
À retenir de cette leçon :
EXPLAINmontre le plan choisi par l'optimiseur ;EXPLAIN ANALYZEexécute la requête et ajoute le temps et les lignes réels.- Dans MySQL, commencez par
type,key,rowsetExtra;ALLetkey = NULLsur une grande table sont les premiers suspects. - Lisez les arbres de plan de l'intérieur vers l'extérieur : les étapes imbriquées s'exécutent d'abord et remontent les lignes.
- Le goulot d'étranglement est l'étape au temps réel le plus élevé et au plus grand nombre de lignes écartées.
- Un grand écart entre lignes estimées et réelles signale des statistiques obsolètes.
- Une fonction ou une expression sur une colonne indexée transforme en général la recherche par index en parcours complet.
EXPLAIN ANALYZEd'unUPDATEou d'unDELETEmodifie les données : lancez-le dans une transaction puis annulez-la.
Questions fréquentes
Quelle est la différence entre EXPLAIN et EXPLAIN ANALYZE ?
EXPLAIN montre seulement le plan avec les estimations de l'optimiseur et n'exécute pas la requête. EXPLAIN ANALYZE exécute la requête et affiche le temps, les lignes et le nombre d'exécutions réels de chaque étape, pour comparer les estimations à la réalité.
Un parcours complet de table est-il toujours mauvais ?
Non. Le parcours complet est le meilleur choix pour les petites tables et pour les requêtes qui renvoient une grande partie de la table : lire les lignes à la suite coûte moins cher que des allers-retours entre l'index et la table. Le problème, c'est de parcourir une grande table pour trouver quelques lignes.
Pourquoi la base ignore-t-elle mon index ?
Raisons fréquentes : la colonne est dans une fonction ou une expression, le LIKE commence par %, les types des valeurs comparées diffèrent, la condition correspond à une grande part des lignes, ou les statistiques sont obsolètes. Le plan montre de quel cas il s'agit.
Que signifie cost dans un plan ?
Le cost est l'estimation du travail par l'optimiseur, en unités abstraites (lectures de pages et opérations CPU), pas en millisecondes. Il sert à comparer des plans d'une même requête ; le temps réel vient d'EXPLAIN ANALYZE.
Questions d'entretien
Comment trouvez-vous pourquoi une requête est lente ?
Je lance EXPLAIN ANALYZE (ou je regarde le plan d'exécution réel) et je cherche l'étape au temps le plus élevé et au plus grand nombre de lignes lues et écartées. Je vérifie ensuite si elle utilise un index, si la condition est SARGable et si les lignes estimées correspondent aux réelles.
Que signifient les types d'accès ALL, index, range et ref dans MySQL ?
ALL lit toute la table ; index lit tout l'index ; range lit une plage de l'index pour BETWEEN, > ou IN ; ref trouve des lignes par une valeur d'index. const et eq_ref trouvent au plus une ligne par une clé unique.
L'optimiseur attendait 10 lignes et en a obtenu 100 000. Que faites-vous ?
Le plan a été construit sur de mauvaises estimations, donc la méthode ou l'ordre des jointures peuvent être mauvais. Je mets à jour les statistiques (ANALYZE), je vérifie que la condition ne cache pas la colonne dans une expression et je compare à nouveau le plan. Si les données sont déséquilibrées, des statistiques étendues ou une requête réécrite peuvent aider.