Leçon 5.9 · Temps de lecture : ~9 min
Les algorithmes de jointure SQL sont les méthodes qu'une base de données utilise pour exécuter une jointure : nested loop join, hash join et merge join. Dans cette leçon, vous apprendrez comment fonctionne chaque algorithme, quand le planificateur de requêtes le choisit, quels SGBD prennent en charge quels algorithmes, et comment voir celui qui a été choisi avec EXPLAIN.
Algorithmes de jointure SQL : comment la base exécute les jointures
Dans les leçons précédentes, vous avez écrit des jointures en vous intéressant aux lignes qu'elles renvoient. Une même jointure peut être exécutée de façons très différentes, et sur de grandes tables, l'écart se compte en secondes contre des heures. On ne choisit pas l'algorithme en SQL : c'est le planificateur de requêtes qui le fait. Mais savoir comment fonctionnent les algorithmes explique pourquoi les index sur les colonnes de jointure comptent et comment lire les plans d'exécution.
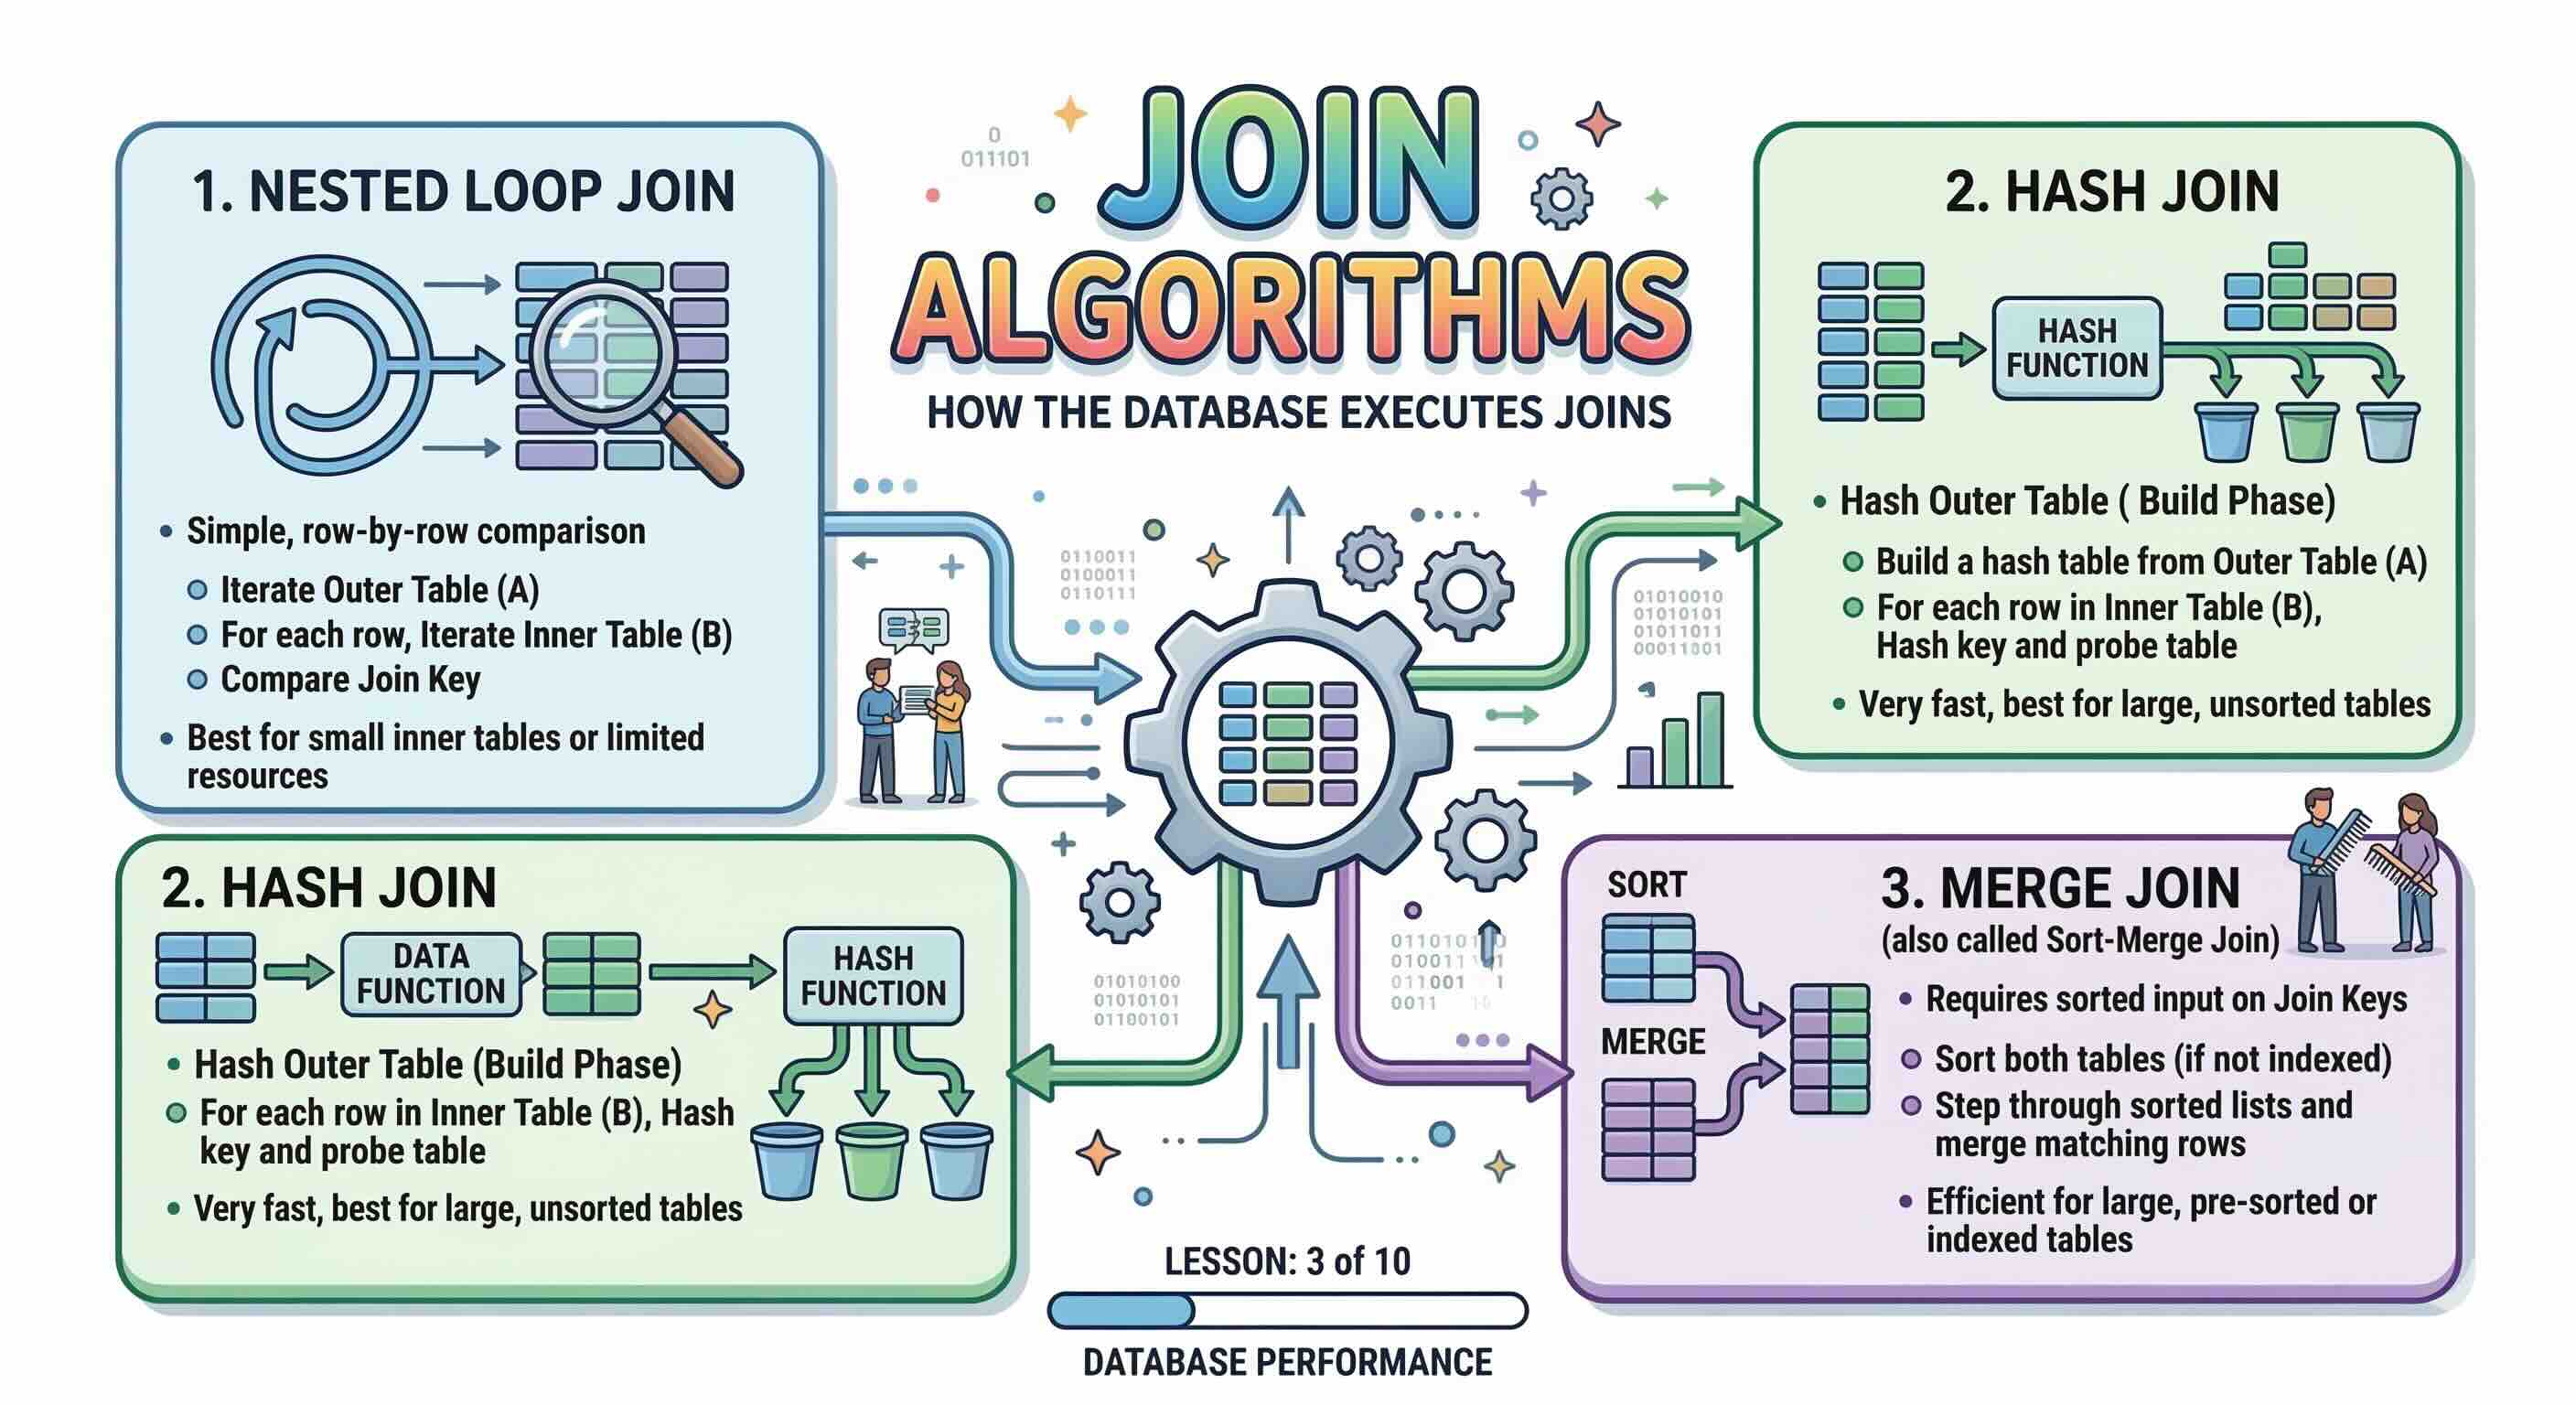
Nested Loop Join
Comment il fonctionne
La base de données prend une table comme table externe (pilote) et, pour chacune de ses lignes, cherche des correspondances dans la table interne : deux boucles imbriquées.
for each row R1 in outer_table:
    for each row R2 in inner_table:
        if R1.key = R2.key:
            output(R1, R2)
Sans index, la table interne est parcourue entièrement pour chaque ligne externe : N × M comparaisons. Avec un index sur la colonne de jointure de la table interne, chaque recherche devient une recherche rapide dans l'index. Cet index nested loop join est l'un des plans les plus efficaces quand le côté externe est petit.
Quand le planificateur l'utilise
- La table externe, ou le côté externe après filtrage, est petite.
- La table interne a un index sur la colonne de jointure.
- La condition de jointure n'est pas une égalité (
<,>,BETWEEN) : les hash et merge joins classiques ne fonctionnent qu'avec une égalité.
| Avantages | Inconvénients |
|---|---|
| Fonctionne avec n'importe quelle condition de jointure | Très lent sur de grandes tables sans index : N × M |
| Très rapide avec un petit côté externe et un index | Le coût croît vite avec la taille des deux tables |
| Peu de mémoire ; renvoie les premières lignes immédiatement |
Hash Join
Comment il fonctionne
Un hash join se déroule en deux phases :
- Construction (build) : la base lit la plus petite entrée et construit en mémoire une table de hachage sur la colonne de jointure.
- Sondage (probe) : elle lit la plus grande entrée et cherche la clé de chaque ligne dans la table de hachage.
-- build
for each row R1 in smaller_input:
    hash_table[hash(R1.key)].append(R1)

-- probe
for each row R2 in larger_input:
    for each R1 in hash_table[hash(R2.key)]:
        if R1.key = R2.key:
            output(R1, R2)
Chaque entrée est lue une seule fois, le coût est donc d'environ N + M : bien mieux qu'un nested loop sans index.
Quand le planificateur l'utilise
- Deux grandes entrées jointes par égalité.
- Aucun index utile sur les colonnes de jointure.
- Assez de mémoire pour la table de hachage (
work_memdans PostgreSQL,join_buffer_sizedans MySQL).
| Avantages | Inconvénients |
|---|---|
Efficace pour les grandes jointures sans index : N + M | Le hash join classique exige une condition d'égalité |
| N'a besoin ni d'index ni d'entrée triée | Consomme de la mémoire ; déborde sur disque si la table de hachage ne tient pas |
| Doit construire la table de hachage avant de renvoyer la première ligne |
Merge Join
Comment il fonctionne
Un merge join (sort-merge join) exige que les deux entrées soient triées par la colonne de jointure. Il parcourt ensuite les deux listes triées en même temps, comme l'étape de fusion du tri fusion :
sort outer by key   -- skipped if read through an ordered index
sort inner by key   -- skipped if read through an ordered index

while neither input is exhausted:
    if outer.key = inner.key: output matches, advance
    elif outer.key < inner.key: advance outer
    else: advance inner
Si les deux entrées peuvent être lues dans l'ordre grâce à des index, le tri est gratuit et la fusion est très rapide.
Quand le planificateur l'utilise
- De grandes entrées jointes par égalité.
- Les deux entrées sont déjà triées ou peuvent être lues via des index ordonnés.
- La requête trie de toute façon par la colonne de jointure (
ORDER BY,GROUP BY,DISTINCT).
| Avantages | Inconvénients |
|---|---|
| Très rapide sur une entrée pré-triée ou indexée | Conditions d'égalité uniquement |
| Le résultat est déjà trié par la clé de jointure | Le tri explicite d'une entrée non triée est coûteux |
| Consommation de mémoire prévisible |
Quel SGBD utilise quel algorithme
| SGBD | Nested loop | Hash join | Merge join |
|---|---|---|---|
| PostgreSQL | Oui | Oui | Oui |
| SQL Server, Oracle | Oui | Oui | Oui |
| MySQL 8.0.18+ | Oui | Oui (a remplacé le Block Nested Loop en 8.0.20) | Non |
| MariaDB | Oui (y compris block nested loop, BKA) | Oui (block hash join) | Non |
| SQLite | Oui | Non | Non |
Dans MySQL, le hash join est aussi utilisé pour les jointures sans condition d'égalité et pour les produits cartésiens ; la règle « égalité uniquement » s'applique donc à l'algorithme classique plutôt qu'à chaque implémentation.
Voir l'algorithme dans EXPLAIN
EXPLAIN montre le plan choisi par la base ; EXPLAIN ANALYZE (MySQL 8.0.18+, PostgreSQL) exécute aussi la requête et indique le temps réel de chaque étape :
EXPLAIN ANALYZE
SELECT a.first_name, a.last_name, f.title
FROM actor AS a
INNER JOIN film_actor AS fa ON fa.actor_id = a.actor_id
INNER JOIN film AS f ON f.film_id = fa.film_id;
Résultat : le plan d'exécution sous forme d'arbre. Dans MySQL, cherchez Nested loop inner join ou Inner hash join ; dans PostgreSQL, Nested Loop, Hash Join ou Merge Join.
Ici, MySQL utilise des boucles imbriquées : film_actor et film ont des index sur les colonnes de jointure, donc chaque recherche est une recherche dans un index.
Comment aider le planificateur
- Indexez les colonnes de clés étrangères utilisées dans les jointures : cela rend possible l'index nested loop.
- Filtrez tôt : un
WHEREsélectif réduit le côté externe. - Tenez les statistiques à jour (
ANALYZE TABLEdans MySQL,ANALYZEdans PostgreSQL) : le planificateur choisit selon des estimations du nombre de lignes. - Vérifiez les paramètres de mémoire si un hash join déborde sur disque avec de gros volumes.
Points clés :
- Nested loop join cherche dans la table interne pour chaque ligne externe ; rapide avec un petit côté externe et un index, il fonctionne avec n'importe quelle condition.
- Hash join construit une table de hachage à partir de la plus petite entrée et la sonde ; efficace pour les grandes jointures par égalité sans index, mais gourmand en mémoire.
- Merge join fusionne deux entrées triées ; idéal quand les données sont déjà ordonnées par un index.
- MySQL et MariaDB n'ont pas de merge join ; PostgreSQL, SQL Server et Oracle ont les trois.
- Vous influencez le choix par les index, les filtres, les statistiques et les paramètres de mémoire, et vous le vérifiez avec
EXPLAIN ANALYZE.
Questions fréquentes
Quelle est la différence entre un nested loop join et un hash join ?
Un nested loop join cherche des correspondances dans la table interne pour chaque ligne externe, ce qui est rapide avec un index et un petit côté externe. Un hash join lit chaque entrée une seule fois et associe les lignes via une table de hachage en mémoire, ce qui est plus rapide pour deux grandes entrées sans index utile.
MySQL prend-il en charge le hash join ?
Oui, depuis MySQL 8.0.18. Depuis la 8.0.20, il remplace l'algorithme block nested loop pour les jointures qui ne peuvent pas utiliser d'index. MySQL n'a pas de merge join.
Peut-on forcer un algorithme de jointure ?
Pas en SQL standard. Certaines bases proposent des indications : les optimizer hints de MySQL comme HASH_JOIN / NO_HASH_JOIN (selon la version), OPTION (HASH JOIN) dans SQL Server, des paramètres PostgreSQL comme enable_hashjoin. Utilisez-les pour le diagnostic ; pour les requêtes de production, de meilleurs index et statistiques sont généralement la bonne solution.