Урок 5.9 · Время чтения: ~9 мин
Алгоритмы соединения — это способы, которыми база данных выполняет соединение таблиц: nested loop join, hash join и merge join. В этом уроке вы узнаете, как работает каждый алгоритм, когда его выбирает планировщик запросов, какие СУБД какие алгоритмы поддерживают и как увидеть выбранный алгоритм с помощью EXPLAIN.
Алгоритмы соединения в SQL: как база данных выполняет JOIN
В предыдущих уроках вы писали соединения и думали о том, какие строки они возвращают. Одно и то же соединение можно выполнить очень разными способами, и на больших таблицах разница между ними — секунды против часов. Алгоритм не выбирают в SQL: это делает планировщик запросов. Но знание того, как работают алгоритмы, объясняет, почему важны индексы на столбцах соединения и как читать планы выполнения.
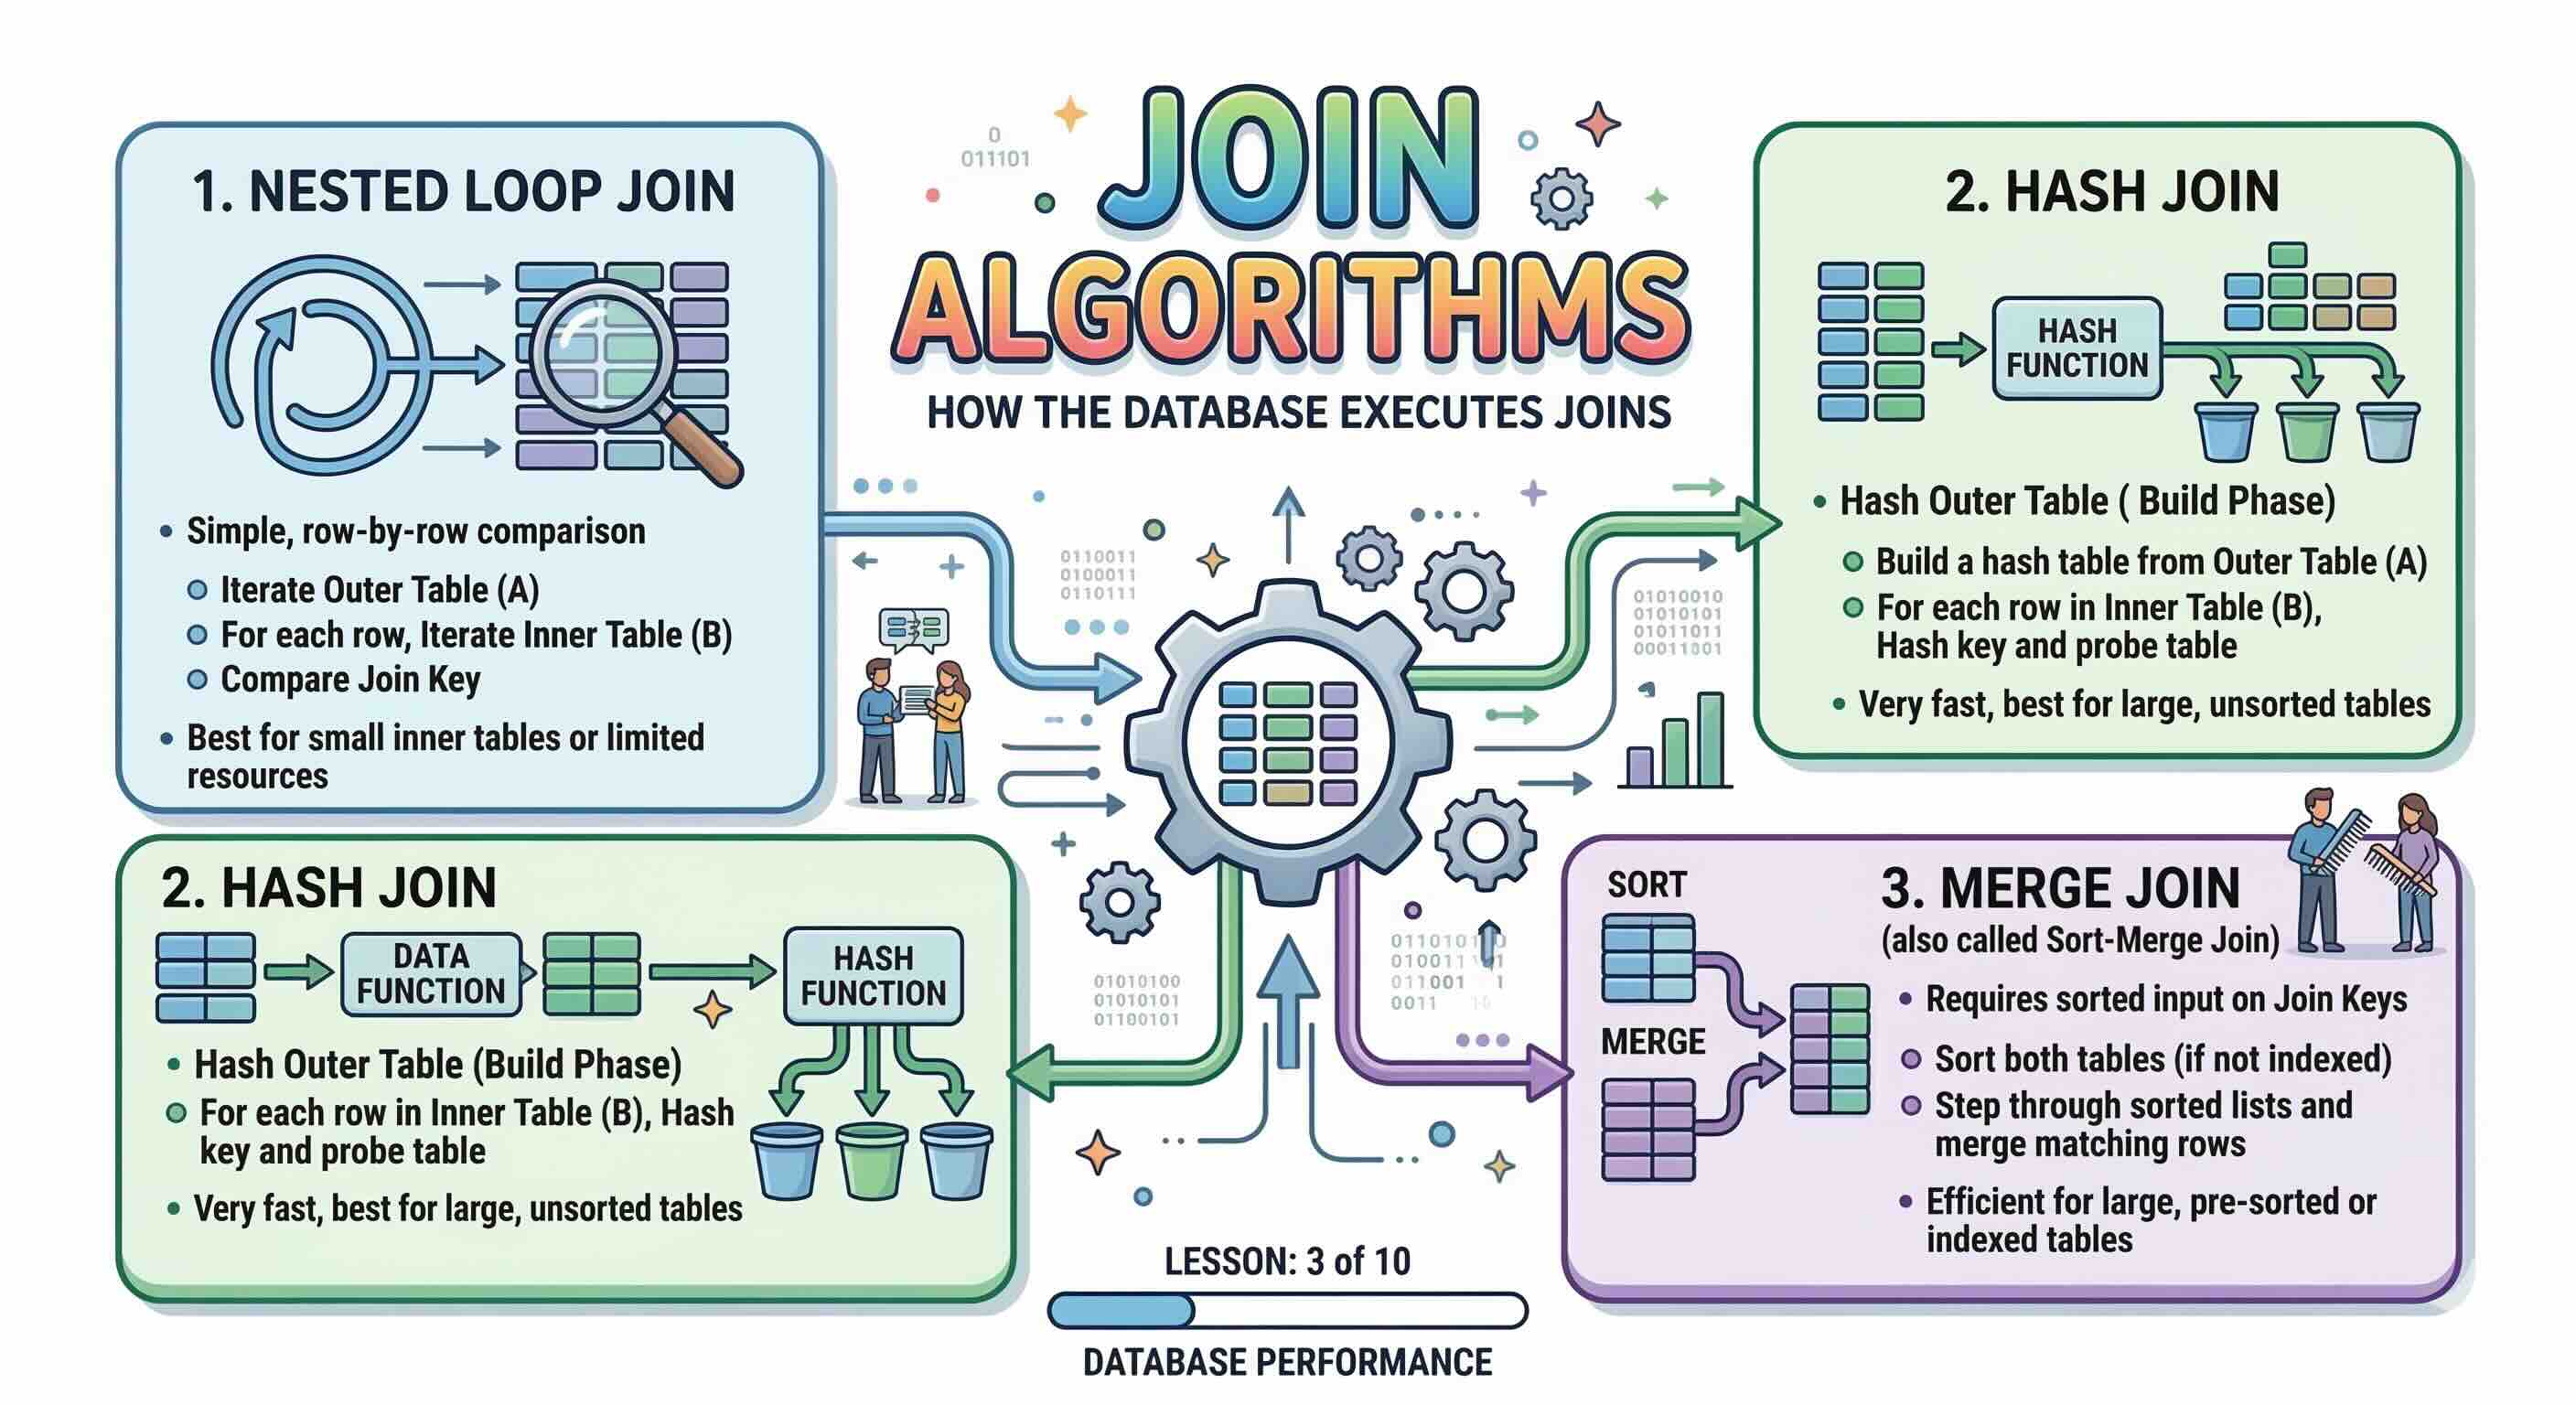
Nested Loop Join
Как он работает
База данных берёт одну таблицу как внешнюю (ведущую) и для каждой её строки ищет совпадения во внутренней таблице — два вложенных цикла.
for each row R1 in outer_table:
    for each row R2 in inner_table:
        if R1.key = R2.key:
            output(R1, R2)
Без индекса внутренняя таблица полностью просматривается для каждой внешней строки: N × M сравнений. С индексом на столбце соединения внутренней таблицы каждый поиск превращается в быстрый поиск по индексу. Такой index nested loop join — один из самых эффективных планов, когда внешняя сторона небольшая.
Когда его выбирает планировщик
- Внешняя таблица или внешняя сторона после фильтрации невелика.
- У внутренней таблицы есть индекс на столбце соединения.
- Условие соединения не является равенством (
<,>,BETWEEN): классические hash и merge join работают только с равенством.
| Плюсы | Минусы |
|---|---|
| Работает с любым условием соединения | Очень медленный на больших таблицах без индекса: N × M |
| Очень быстрый при небольшой внешней стороне и наличии индекса | Стоимость быстро растёт с размером обеих таблиц |
| Мало памяти; первые строки возвращаются сразу |
Hash Join
Как он работает
Hash join выполняется в две фазы:
- Построение (build): база данных читает меньший вход и строит в памяти хеш-таблицу по столбцу соединения.
- Проверка (probe): она читает больший вход и ищет ключ каждой строки в хеш-таблице.
-- build
for each row R1 in smaller_input:
    hash_table[hash(R1.key)].append(R1)

-- probe
for each row R2 in larger_input:
    for each R1 in hash_table[hash(R2.key)]:
        if R1.key = R2.key:
            output(R1, R2)
Каждый вход читается один раз, поэтому стоимость порядка N + M — намного лучше, чем nested loop без индексов.
Когда его выбирает планировщик
- Два больших входа, соединяемых по равенству.
- Нет полезного индекса на столбцах соединения.
- Хватает памяти для хеш-таблицы (
work_memв PostgreSQL,join_buffer_sizeв MySQL).
| Плюсы | Минусы |
|---|---|
Эффективен для больших соединений без индексов: N + M | Классическому hash join нужно условие равенства |
| Не нужны индексы и отсортированный вход | Занимает память; если хеш-таблица не помещается, сбрасывается на диск |
| Должен построить хеш-таблицу, прежде чем вернуть первую строку |
Merge Join
Как он работает
Merge join (sort-merge join) требует, чтобы оба входа были отсортированы по столбцу соединения. Затем он проходит оба отсортированных списка одновременно, как на шаге слияния в сортировке слиянием:
sort outer by key   -- skipped if read through an ordered index
sort inner by key   -- skipped if read through an ordered index

while neither input is exhausted:
    if outer.key = inner.key: output matches, advance
    elif outer.key < inner.key: advance outer
    else: advance inner
Если оба входа можно прочитать по порядку через индексы, сортировка ничего не стоит, и слияние происходит очень быстро.
Когда его выбирает планировщик
- Большие входы, соединяемые по равенству.
- Оба входа уже отсортированы или могут быть прочитаны через упорядоченные индексы.
- Запрос всё равно сортирует по столбцу соединения (
ORDER BY,GROUP BY,DISTINCT).
| Плюсы | Минусы |
|---|---|
| Очень быстрый на предварительно отсортированном или проиндексированном входе | Только условия равенства |
| Результат уже отсортирован по ключу соединения | Явная сортировка неотсортированного входа дорога |
| Предсказуемое потребление памяти |
Какая СУБД какой алгоритм использует
| СУБД | Nested loop | Hash join | Merge join |
|---|---|---|---|
| PostgreSQL | Да | Да | Да |
| SQL Server, Oracle | Да | Да | Да |
| MySQL 8.0.18+ | Да | Да (заменил Block Nested Loop в 8.0.20) | Нет |
| MariaDB | Да (включая block nested loop, BKA) | Да (block hash join) | Нет |
| SQLite | Да | Нет | Нет |
В MySQL hash join используется также для соединений без условия равенства и для декартовых произведений, поэтому правило «только равенство» относится к классическому алгоритму, а не к каждой реализации.
Как увидеть алгоритм в EXPLAIN
EXPLAIN показывает план, выбранный базой данных; EXPLAIN ANALYZE (MySQL 8.0.18+, PostgreSQL) ещё и выполняет запрос и сообщает реальное время каждого шага:
EXPLAIN ANALYZE
SELECT a.first_name, a.last_name, f.title
FROM actor AS a
INNER JOIN film_actor AS fa ON fa.actor_id = a.actor_id
INNER JOIN film AS f ON f.film_id = fa.film_id;
Результат: план выполнения в виде дерева. В MySQL ищите Nested loop inner join или Inner hash join; в PostgreSQL — Nested Loop, Hash Join или Merge Join.
Здесь MySQL использует вложенные циклы: у film_actor и film есть индексы на столбцах соединения, поэтому каждый поиск — это поиск по индексу.
Как помочь планировщику
- Индексируйте столбцы внешних ключей, по которым выполняются соединения: это делает возможным index nested loop.
- Фильтруйте рано: избирательный
WHEREделает внешнюю сторону небольшой. - Поддерживайте статистику актуальной (
ANALYZE TABLEв MySQL,ANALYZEв PostgreSQL): планировщик выбирает по оценкам количества строк. - Проверьте настройки памяти, если hash join на больших данных сбрасывается на диск.
Ключевые выводы:
- Nested loop join ищет совпадения во внутренней таблице для каждой внешней строки; быстр при небольшой внешней стороне и индексе и работает с любым условием.
- Hash join строит хеш-таблицу по меньшему входу и проверяет её; эффективен для больших соединений по равенству без индексов, но занимает память.
- Merge join сливает два отсортированных входа; идеален, когда данные уже упорядочены индексом.
- В MySQL и MariaDB нет merge join; в PostgreSQL, SQL Server и Oracle есть все три.
- Выбор зависит от индексов, фильтров, статистики и настроек памяти; проверяйте его с помощью
EXPLAIN ANALYZE.
Часто задаваемые вопросы
Чем nested loop join отличается от hash join?
Nested loop join ищет совпадения во внутренней таблице для каждой внешней строки, что быстро при наличии индекса и небольшой внешней стороне. Hash join читает каждый вход один раз и сопоставляет строки через хеш-таблицу в памяти, что быстрее для двух больших входов без полезных индексов.
Поддерживает ли MySQL hash join?
Да, начиная с MySQL 8.0.18. С версии 8.0.20 он заменяет алгоритм block nested loop для соединений, которые не могут использовать индекс. Merge join в MySQL нет.
Можно ли принудительно выбрать алгоритм соединения?
В стандартном SQL — нет. Некоторые СУБД предлагают подсказки: оптимизаторные подсказки MySQL вроде HASH_JOIN / NO_HASH_JOIN (зависят от версии), OPTION (HASH JOIN) в SQL Server, настройки PostgreSQL вроде enable_hashjoin. Используйте их для диагностики; для рабочих запросов правильным решением обычно являются лучшие индексы и статистика.