Como ler o EXPLAIN
Lição 10.4 · Tempo de leitura: ~12 min · Tarefas para praticar ↓
O EXPLAIN mostra como o banco de dados vai executar a sua consulta: quais tabelas lê, em que ordem, se usa um índice e quantas linhas espera. Nesta lição você vai ler planos reais do MySQL e do PostgreSQL linha por linha, comparar as estimativas do otimizador com os números reais do EXPLAIN ANALYZE e aprender os sinais de uma consulta lenta.
Na lição anterior você criou índices. Mas um índice só ajuda se o banco de dados realmente o usar, e a única forma de saber é olhar o plano de execução. O plano troca suposições por fatos: em vez de "a consulta está lenta, talvez falte um índice", você vê exatamente qual passo lê linhas demais.
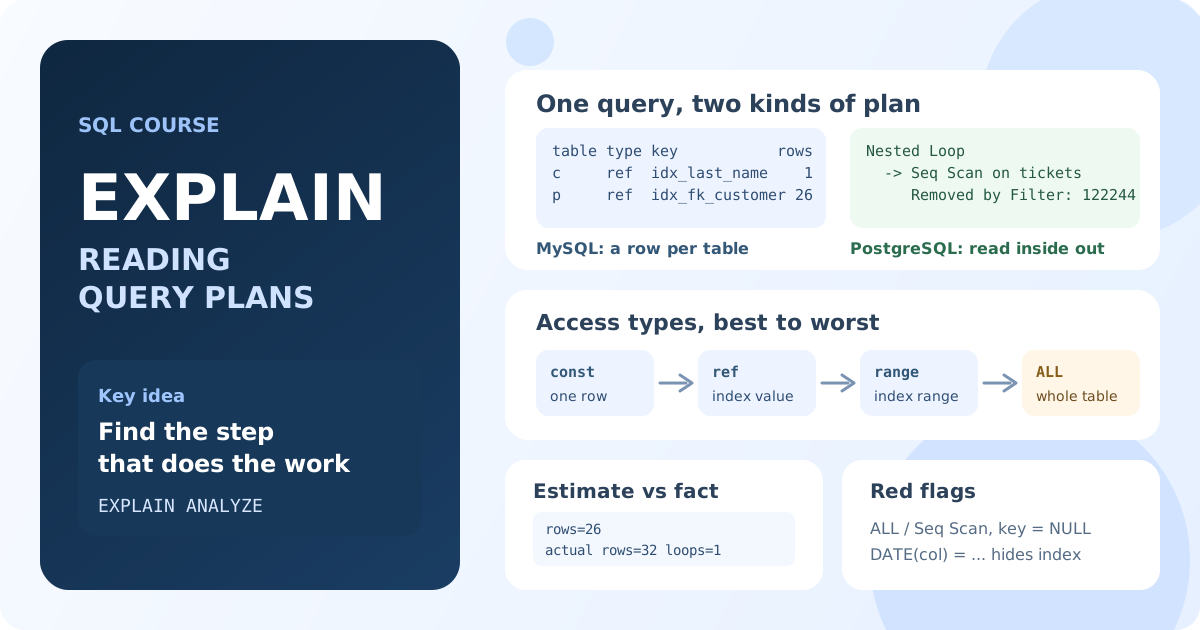
O que é um plano de execução
Antes de executar uma consulta, o otimizador escolhe como fazê-lo: qual tabela ler primeiro, se usa um índice ou lê a tabela inteira, como juntar as tabelas e como ordenar. O resultado dessa escolha é o plano de execução. O otimizador escolhe o plano com o menor custo (cost) estimado, e calcula o custo a partir de estatísticas: quantas linhas cada tabela tem e como os valores se distribuem.
O plano é obtido colocando uma palavra-chave antes da consulta:
| SGBD | Só o plano | Plano e execução real |
|---|---|---|
| MySQL, MariaDB | EXPLAIN | EXPLAIN ANALYZE (MySQL 8.0.18+), ANALYZE (MariaDB) |
| PostgreSQL | EXPLAIN | EXPLAIN ANALYZE, muitas vezes com BUFFERS |
| SQLite | EXPLAIN QUERY PLAN | não há |
| SQL Server | SET SHOWPLAN_TEXT ON ou "Display Estimated Execution Plan" no SSMS | SET STATISTICS PROFILE ON ou "Include Actual Execution Plan" |
| Oracle | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | DBMS_XPLAN.DISPLAY_CURSOR |
O EXPLAIN só monta o plano e não executa a consulta. O EXPLAIN ANALYZE a executa e acrescenta o tempo e as contagens de linhas reais.
MySQL: o formato de tabela
Vamos buscar os pagamentos dos clientes de sobrenome Smith no banco Sakila:
EXPLAIN
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
Resultado (MySQL 8.0):
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| id | select_type | table | type | possible_keys         | key                | ref                  | rows | filtered | Extra |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| 1  | SIMPLE      | c     | ref  | PRIMARY,idx_last_name | idx_last_name      | const                | 1    | 100.00   | NULL  |
| 1  | SIMPLE      | p     | ref  | idx_fk_customer_id    | idx_fk_customer_id | sakila.c.customer_id | 26   | 100.00   | NULL  |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
Cada linha é uma tabela, na ordem em que o MySQL a lê: primeiro customer, depois, para cada cliente encontrado, payment. O que significam as colunas:
table: a tabela (ou o seu alias) lida neste passo.type: como as linhas são acessadas. É a coluna mais importante.possible_keys: índices que poderiam ser usados;key: o índice escolhido.NULLemkeysignifica que nenhum índice é usado.ref: com o que o índice é comparado: uma constante (const) ou uma coluna da tabela anterior (sakila.c.customer_id).rows: quantas linhas o MySQL espera ler neste passo. É uma estimativa, não um fato.filtered: a porcentagem dessas linhas que deve passar pelas demais condições.Extra: detalhes adicionais, veja abaixo.
Lendo o plano: o MySQL encontra o cliente pelo índice em last_name (espera 1 linha) e, para esse cliente, busca os pagamentos pelo índice em customer_id (espera 26 linhas). Os dois passos usam índices, então a consulta lê algumas dezenas de linhas entre mais de 16 000 pagamentos.
Tipos de acesso na coluna type
Do melhor para o pior:
type | O que acontece | Exemplo |
|---|---|---|
const, eq_ref | no máximo uma linha por chave primária ou única | WHERE customer_id = 1 em customer |
ref | várias linhas por um valor do índice | WHERE last_name = 'SMITH' |
range | um intervalo do índice | BETWEEN, >, <, IN (...) |
index | o índice inteiro é lido | o índice tem todas as colunas necessárias, mas não há filtro pela sua primeira coluna |
ALL | a tabela inteira é lida (full table scan) | uma condição em uma coluna sem índice |
ALL em uma pequena tabela de referência não é problema. ALL em uma tabela grande, numa consulta que precisa de poucas linhas, é a primeira coisa a corrigir.
A coluna Extra
Using index: todas as colunas necessárias estão no índice e a tabela não é lida (índice de cobertura). Bom.Using where: as linhas são filtradas depois de lidas. Normal por si só, um problema junto comALLem uma tabela grande.Using index condition: a condição é verificada dentro do índice antes de ler a linha (index condition pushdown).Using temporary: uma tabela temporária intermediária é criada, em geral paraGROUP BYouDISTINCT.Using filesort: as linhas são ordenadas à parte, e não lidas na ordem do índice.
Por exemplo, os cinco clientes que mais pagaram:
EXPLAIN
SELECT customer_id, SUM(amount) AS total
FROM payment
GROUP BY customer_id
ORDER BY total DESC
LIMIT 5;
Resultado: type = index, rows = 15577, Extra = Using temporary; Using filesort. O MySQL lê o índice inteiro, agrupa os pagamentos numa tabela temporária e ordena as somas. Aqui não há como evitar isso: a ordem por uma soma calculada só é conhecida depois que todas as linhas são agrupadas. Com 16 000 linhas é rápido; com 100 milhões, um relatório assim seria calculado antes (por exemplo, numa tabela de resumo).
Como uma função esconde um índice
A tabela rental tem um índice em rental_date. Compare duas consultas que retornam os mesmos 504 aluguéis de 6 de julho de 2005:
EXPLAIN
SELECT *
FROM rental
WHERE rental_date >= '2005-07-06' AND rental_date < '2005-07-07';
Resultado: type = range, key = rental_date, rows = 504.
EXPLAIN
SELECT *
FROM rental
WHERE DATE(rental_date) = '2005-07-06';
Resultado: type = ALL, key = NULL, rows = 15831.
O índice está ordenado por rental_date, não por DATE(rental_date). Quando a coluna é envolvida por uma função, o banco não consegue buscar no índice e verifica cada linha. A correção é deixar a coluna "nua" e passar o cálculo para o outro lado da comparação, como na primeira consulta. Condições que podem usar um índice assim são chamadas de SARGable.
Árvores de plano: FORMAT=TREE e EXPLAIN ANALYZE no MySQL
O formato de tabela esconde como os passos se aninham. O MySQL 8 pode mostrar o plano como uma árvore:
EXPLAIN FORMAT=TREE
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
-> Nested loop inner join  (cost=9.45 rows=26)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26)
Leia a árvore de dentro para fora: as linhas com mais recuo executam primeiro, e cada uma passa as suas linhas para a linha de cima. Aqui o primeiro filho encontra o cliente, o segundo encontra os pagamentos de cada cliente, e o Nested loop inner join acima deles combina as linhas.
O EXPLAIN ANALYZE executa a consulta e acrescenta os números reais a cada passo:
-> Nested loop inner join  (cost=9.45 rows=26) (actual time=0.139..0.157 rows=32 loops=1)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1) (actual time=0.0572..0.0586 rows=1 loops=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26) (actual time=0.0555..0.0688 rows=32 loops=1)
rows=26é a estimativa,actual ... rows=32é o fato. O Sr. Smith fez 32 pagamentos, enquanto as estatísticas sugeriam 26 em média por cliente.actual time=0.0555..0.0688: milissegundos até a primeira e até a última linha deste passo.loops: quantas vezes o passo foi executado. O lado interno de um nested loop executa uma vez para cada linha do lado externo.
Uma estimativa 20% errada é normal. Uma estimativa errada em 100 vezes significa que o otimizador escolheu o plano com dados errados, e o plano também pode estar errado.
PostgreSQL: lendo a árvore do plano
O PostgreSQL sempre mostra uma árvore. Uma consulta pela chave primária no banco Bookings:
EXPLAIN
SELECT *
FROM bookings.flights
WHERE flight_id = 1001;
Index Scan using flights_pkey on flights  (cost=0.29..8.31 rows=1 width=63)
  Index Cond: (flight_id = 1001)
Cada nó mostra:
- a operação:
Seq Scan(a tabela inteira),Index Scan(índice mais linhas da tabela),Index Only Scan(só o índice),Bitmap Heap Scan(primeiro reúne as linhas pelo índice, depois as lê da tabela na ordem de armazenamento); cost=0.29..8.31: o custo estimado até a primeira linha e para todas as linhas, em unidades abstratas (não milissegundos);rows: o número estimado de linhas de saída;width: o tamanho médio da linha em bytes;- as linhas abaixo: a condição do índice (
Index Cond) ou o filtro (Filter).
Não há índice em departure_airport, então uma busca por aeroporto lê a tabela inteira:
EXPLAIN
SELECT flight_id, scheduled_departure
FROM bookings.flights
WHERE departure_airport = 'DME';
Seq Scan on flights  (cost=0.00..806.01 rows=3217 width=12)
  Filter: (departure_airport = 'DME'::bpchar)
Aqui a leitura completa é razoável: a consulta retorna cerca de 10% da tabela, e ler 33 000 linhas em sequência é barato.
EXPLAIN ANALYZE no PostgreSQL
As passagens de uma reserva:
EXPLAIN ANALYZE
SELECT t.passenger_name, tf.fare_conditions, tf.amount
FROM bookings.tickets t
JOIN bookings.ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '00000F';
Gather  (cost=1000.42..9103.17 rows=6 width=30) (actual time=409.864..415.535 rows=2.00 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Nested Loop  (cost=0.42..8102.57 rows=2 width=30) (actual time=388.369..389.800 rows=0.67 loops=3)
        ->  Parallel Seq Scan on tickets t  (cost=0.00..8086.07 rows=1 width=30) (actual time=386.664..387.206 rows=0.33 loops=3)
              Filter: (book_ref = '00000F'::bpchar)
              Rows Removed by Filter: 122244
        ->  Index Scan using ticket_flights_pkey on ticket_flights tf  (cost=0.42..16.47 rows=3 width=28) (actual time=5.061..7.713 rows=2.00 loops=1)
              Index Cond: (ticket_no = t.ticket_no)
Planning Time: 45.638 ms
Execution Time: 415.774 ms
Lendo de dentro para fora:
Parallel Seq Scan on tickets: três processos (loops=3, o principal e dois workers) percorrem a tabelaticketsinteira. Cada um descarta cerca de 122 000 linhas (Rows Removed by Filter) para achar uma única passagem.Index Scan on ticket_flights: para a passagem encontrada, os trechos de voo são buscados pelo índice da chave primária. Rápido: menos de 8 ms.- O
Nested Loopjunta os dois, e oGatherreúne os resultados dos workers paralelos.
A consulta inteira leva 415 ms, e quase todo esse tempo é do primeiro passo. O gargalo é o nó com o maior tempo real e o maior número de linhas descartadas. A correção é um índice em tickets (book_ref).
No PostgreSQL, rows e loops andam juntos: um nó informa as linhas por execução, então o total é rows × loops. rows=0.33 loops=3 significa uma linha no total.
Antes e depois de um índice
O mesmo diagnóstico numa tabela de teste orders com 200 000 linhas (10 000 clientes, 20 pedidos cada):
EXPLAIN ANALYZE
SELECT id, amount, created_at
FROM orders
WHERE customer_id = 42;
Sem índice:
Seq Scan on orders  (cost=0.00..3774.00 rows=20 width=14) (actual time=0.030..19.330 rows=20.00 loops=1)
  Filter: (customer_id = 42)
  Rows Removed by Filter: 199980
Execution Time: 19.379 ms
Depois de CREATE INDEX orders_customer_id_idx ON orders (customer_id);:
Bitmap Heap Scan on orders  (cost=4.45..77.18 rows=20 width=14) (actual time=0.142..0.188 rows=20.00 loops=1)
  Recheck Cond: (customer_id = 42)
  ->  Bitmap Index Scan on orders_customer_id_idx  (cost=0.00..4.45 rows=20 width=0) (actual time=0.120..0.120 rows=20.00 loops=1)
        Index Cond: (customer_id = 42)
Execution Time: 0.293 ms
As 199 980 linhas descartadas viraram zero, e a consulta ficou cerca de 65 vezes mais rápida. Agora escreva a condição como customer_id + 0 = 42: o plano volta a Parallel Seq Scan, e a estimativa passa a rows=1000 em vez de 20, porque o otimizador não tem estatísticas para a expressão.
Métodos de junção
Um plano com várias tabelas mostra como elas são juntadas:
- Nested Loop: para cada linha da entrada externa, busca as linhas correspondentes na interna. Rápido quando a entrada externa é pequena e a interna tem índice na coluna de junção, como em todos os exemplos acima.
- Hash Join: monta uma tabela hash com a entrada menor e passa a maior por ela. Bom para entradas grandes sem um índice útil.
- Merge Join: as duas entradas são ordenadas pela chave de junção e intercaladas. Bom quando os dados já estão ordenados, por exemplo lidos de índices.
O MySQL usa principalmente nested loops e, desde a 8.0.18, hash joins; o PostgreSQL e o SQL Server usam os três.
Sinais de alerta no plano
| Sinal | O que costuma significar | O que tentar |
|---|---|---|
type = ALL / Seq Scan numa tabela grande com condição seletiva | falta um índice adequado | um índice na coluna do WHERE ou do JOIN |
key = NULL apesar de haver índice | a condição não é SARGable: função, expressão, LIKE '%...', tipos diferentes | reescrever a condição para a coluna ficar "nua" |
um Rows Removed by Filter grande | muitas linhas são lidas e descartadas | um índice ou um índice composto que inclua o filtro |
rows estimado muito diferente do real | estatísticas desatualizadas ou ausentes | ANALYZE TABLE (MySQL), ANALYZE (PostgreSQL) |
Using temporary; Using filesort, Sort com external merge | agrupamento ou ordenação de um resultado grande, talvez em disco | um índice na ordem certa, menos linhas antes de ordenar |
nested loop com loops grande sobre um full scan | o lado interno é buscado sem índice | um índice na coluna de junção do lado interno |
Olhe o plano como um todo. O objetivo não é remover toda leitura completa, mas achar o passo onde vai a maior parte do tempo.
Usando o EXPLAIN ANALYZE com segurança
O EXPLAIN ANALYZE executa a consulta de verdade. Para um SELECT isso só custa tempo, mas EXPLAIN ANALYZE UPDATE ... ou DELETE ... altera os dados. No PostgreSQL, faça essa verificação dentro de uma transação:
BEGIN;
EXPLAIN ANALYZE
UPDATE orders SET amount = amount * 1.1 WHERE customer_id = 42;
ROLLBACK;
Lembre também que a primeira execução pode ler os dados do disco e as seguintes, da memória. Compare planos e tempos depois de várias execuções e com dados de volume parecido com o de produção: numa tabela de 100 linhas quase qualquer plano é rápido.
Principais pontos da lição:
- O
EXPLAINmostra o plano escolhido pelo otimizador; oEXPLAIN ANALYZEexecuta a consulta e acrescenta o tempo e as linhas reais. - No MySQL comece por
type,key,rowseExtra;ALLekey = NULLnuma tabela grande são os primeiros suspeitos. - Leia as árvores de plano de dentro para fora: os passos aninhados executam primeiro e passam as linhas para cima.
- O gargalo é o passo com o maior tempo real e o maior número de linhas descartadas.
- Uma grande diferença entre linhas estimadas e reais aponta para estatísticas desatualizadas.
- Uma função ou expressão sobre uma coluna indexada costuma transformar a busca pelo índice numa leitura completa.
- O
EXPLAIN ANALYZEdeUPDATEouDELETEaltera os dados: execute-o numa transação e desfaça com rollback.
Perguntas frequentes
Qual é a diferença entre EXPLAIN e EXPLAIN ANALYZE?
O EXPLAIN só mostra o plano com as estimativas do otimizador e não executa a consulta. O EXPLAIN ANALYZE executa a consulta e mostra o tempo, as linhas e as execuções reais de cada passo, para comparar as estimativas com a realidade.
Uma leitura completa da tabela é sempre ruim?
Não. A leitura completa é a melhor escolha para tabelas pequenas e para consultas que retornam grande parte da tabela: ler as linhas em sequência sai mais barato do que alternar entre o índice e a tabela. O problema é ler uma tabela grande inteira para achar poucas linhas.
Por que o banco de dados ignora o meu índice?
Motivos comuns: a coluna está dentro de uma função ou expressão, o LIKE começa com %, os tipos dos valores comparados diferem, a condição corresponde a uma grande parte das linhas ou as estatísticas estão desatualizadas. O plano mostra qual é o caso.
O que significa cost no plano?
Cost é a estimativa do otimizador para o trabalho, em unidades abstratas (leituras de páginas e operações de CPU), não em milissegundos. Serve para comparar planos da mesma consulta; o tempo real vem do EXPLAIN ANALYZE.
Perguntas de entrevista
Como você descobre por que uma consulta está lenta?
Executo o EXPLAIN ANALYZE (ou vejo o plano de execução real) e procuro o passo com o maior tempo e o maior número de linhas lidas e descartadas. Depois verifico se ele usa um índice, se a condição é SARGable e se as linhas estimadas coincidem com as reais.
O que significam os tipos de acesso ALL, index, range e ref no MySQL?
ALL lê a tabela inteira; index lê o índice inteiro; range lê um intervalo do índice para BETWEEN, > ou IN; ref encontra linhas por um valor do índice. const e eq_ref encontram no máximo uma linha por uma chave única.
O otimizador esperava 10 linhas, mas vieram 100 000. O que você faz?
O plano foi montado com estimativas erradas, então o método ou a ordem das junções podem estar errados. Atualizo as estatísticas (ANALYZE), verifico se a condição não esconde a coluna numa expressão e comparo o plano de novo. Se os dados forem desbalanceados, estatísticas estendidas ou uma consulta reescrita podem ajudar.