Как читать EXPLAIN
Урок 10.4 · Время чтения: ~12 мин · Задачи для практики ↓
EXPLAIN показывает, как база данных собирается выполнить запрос: какие таблицы она читает, в каком порядке, использует ли индекс и сколько строк ожидает. В этом уроке вы построчно разберёте настоящие планы из MySQL и PostgreSQL, сравните оценки оптимизатора с фактическими цифрами EXPLAIN ANALYZE и научитесь замечать признаки медленного запроса.
В предыдущем уроке вы создавали индексы. Но индекс помогает, только если база данных действительно его использует, а узнать это можно только из плана выполнения. План заменяет догадки фактами: вместо «запрос медленный, наверное, нужен индекс» вы видите, на каком именно шаге читается слишком много строк.
Что такое план выполнения
Перед выполнением запроса оптимизатор выбирает способ: какую таблицу читать первой, использовать индекс или читать таблицу целиком, как соединять таблицы и как сортировать. Результат этого выбора и есть план выполнения. Оптимизатор берёт план с наименьшей оценкой стоимости (cost), а стоимость он оценивает по статистике: сколько строк в каждой таблице и как распределены значения.
План получают, поставив ключевое слово перед запросом:
| СУБД | Только план | План и фактическое выполнение |
|---|---|---|
| MySQL, MariaDB | EXPLAIN | EXPLAIN ANALYZE (MySQL 8.0.18+), ANALYZE (MariaDB) |
| PostgreSQL | EXPLAIN | EXPLAIN ANALYZE, часто с BUFFERS |
| SQLite | EXPLAIN QUERY PLAN | нет |
| SQL Server | SET SHOWPLAN_TEXT ON или «Display Estimated Execution Plan» в SSMS | SET STATISTICS PROFILE ON или «Include Actual Execution Plan» |
| Oracle | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | DBMS_XPLAN.DISPLAY_CURSOR |
EXPLAIN только строит план и не выполняет запрос. EXPLAIN ANALYZE выполняет его и добавляет реальное время и число строк.
MySQL: табличный формат
Найдём платежи клиентов по фамилии Smith в базе Sakila:
EXPLAIN
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
Результат (MySQL 8.0):
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| id | select_type | table | type | possible_keys         | key                | ref                  | rows | filtered | Extra |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
| 1  | SIMPLE      | c     | ref  | PRIMARY,idx_last_name | idx_last_name      | const                | 1    | 100.00   | NULL  |
| 1  | SIMPLE      | p     | ref  | idx_fk_customer_id    | idx_fk_customer_id | sakila.c.customer_id | 26   | 100.00   | NULL  |
+----+-------------+-------+------+-----------------------+--------------------+----------------------+------+----------+-------+
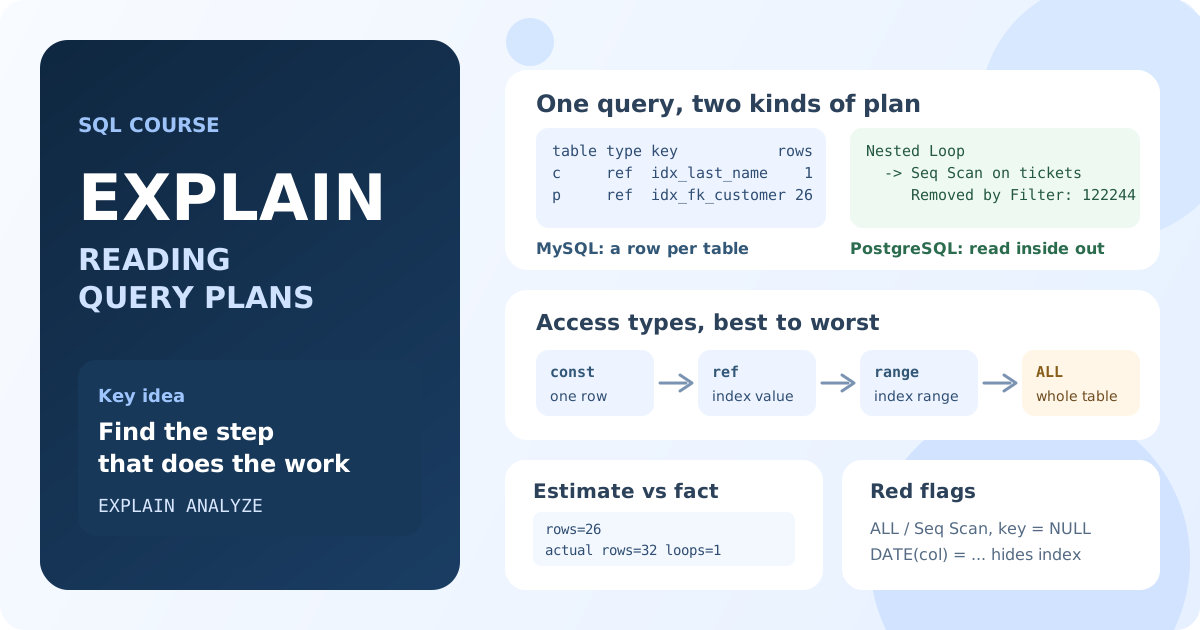
Каждая строка плана - одна таблица в том порядке, в котором MySQL её читает: сначала customer, затем для каждого найденного клиента payment. Что означают столбцы:
table- таблица (или её псевдоним), которая читается на этом шаге.type- способ доступа к строкам. Самый важный столбец.possible_keys- индексы, которые можно было бы использовать;key- индекс, который выбран.NULLвkeyозначает, что индекс не используется.ref- с чем сравнивается индекс: с константой (const) или со столбцом предыдущей таблицы (sakila.c.customer_id).rows- сколько строк MySQL ожидает прочитать на этом шаге. Это оценка, а не факт.filtered- какой процент этих строк, по оценке, пройдёт остальные условия.Extra- дополнительные сведения, о них ниже.
Как читать этот план: MySQL находит клиента по индексу на last_name (ожидает 1 строку), затем для этого клиента ищет платежи по индексу на customer_id (ожидает 26 строк). Оба шага используют индексы, поэтому запрос читает несколько десятков строк из более чем 16 000 платежей.
Типы доступа в столбце type
От лучшего к худшему:
type | Что происходит | Пример |
|---|---|---|
const, eq_ref | не больше одной строки по первичному или уникальному ключу | WHERE customer_id = 1 в customer |
ref | несколько строк по значению индекса | WHERE last_name = 'SMITH' |
range | диапазон индекса | BETWEEN, >, <, IN (...) |
index | читается весь индекс | в индексе есть все нужные столбцы, но фильтра по его первому столбцу нет |
ALL | читается вся таблица (полное сканирование) | условие по столбцу без индекса |
ALL для маленького справочника - нормально. ALL для большой таблицы в запросе, которому нужно несколько строк, - первое, что стоит исправить.
Столбец Extra
Using index- все нужные столбцы есть в индексе, сама таблица не читается (покрывающий индекс). Хорошо.Using where- строки фильтруются после чтения. Само по себе нормально, проблема вместе сALLна большой таблице.Using index condition- условие проверяется внутри индекса до чтения строки (index condition pushdown).Using temporary- строится промежуточная временная таблица, обычно дляGROUP BYилиDISTINCT.Using filesort- строки сортируются отдельно, а не читаются в порядке индекса.
Например, пять клиентов с наибольшей суммой платежей:
EXPLAIN
SELECT customer_id, SUM(amount) AS total
FROM payment
GROUP BY customer_id
ORDER BY total DESC
LIMIT 5;
Результат: type = index, rows = 15577, Extra = Using temporary; Using filesort. MySQL читает весь индекс, группирует платежи во временной таблице и сортирует суммы. Избежать этого здесь нельзя: порядок по вычисленной сумме неизвестен, пока все строки не сгруппированы. На 16 000 строк это быстро; на 100 миллионах такой отчёт считают заранее (например, в сводную таблицу).
Как функция прячет индекс
В таблице rental есть индекс на rental_date. Сравните два запроса, которые возвращают одни и те же 504 аренды за 6 июля 2005 года:
EXPLAIN
SELECT *
FROM rental
WHERE rental_date >= '2005-07-06' AND rental_date < '2005-07-07';
Результат: type = range, key = rental_date, rows = 504.
EXPLAIN
SELECT *
FROM rental
WHERE DATE(rental_date) = '2005-07-06';
Результат: type = ALL, key = NULL, rows = 15831.
Индекс отсортирован по rental_date, а не по DATE(rental_date). Когда столбец обёрнут в функцию, база не может искать по индексу и проверяет каждую строку. Исправление - оставить столбец «голым», а вычисление перенести на другую сторону сравнения, как в первом запросе. Условия, которые могут использовать индекс, называют SARGable.
Дерево плана: MySQL FORMAT=TREE и EXPLAIN ANALYZE
Табличный формат скрывает вложенность шагов. MySQL 8 умеет показывать план деревом:
EXPLAIN FORMAT=TREE
SELECT c.first_name, c.last_name, p.amount, p.payment_date
FROM customer c
JOIN payment p ON p.customer_id = c.customer_id
WHERE c.last_name = 'SMITH';
-> Nested loop inner join  (cost=9.45 rows=26)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26)
Дерево читают изнутри наружу: строки с наибольшим отступом выполняются первыми, и каждая передаёт свои строки строке выше. Здесь первый дочерний шаг находит клиента, второй находит платежи для каждого клиента, а Nested loop inner join над ними объединяет строки.
EXPLAIN ANALYZE выполняет запрос и добавляет к каждому шагу фактические цифры:
-> Nested loop inner join  (cost=9.45 rows=26) (actual time=0.139..0.157 rows=32 loops=1)
    -> Index lookup on c using idx_last_name (last_name='SMITH')  (cost=0.35 rows=1) (actual time=0.0572..0.0586 rows=1 loops=1)
    -> Index lookup on p using idx_fk_customer_id (customer_id=c.customer_id)  (cost=9.1 rows=26) (actual time=0.0555..0.0688 rows=32 loops=1)
rows=26- оценка,actual ... rows=32- факт. Мистер Смит сделал 32 платежа, а статистика предполагала в среднем 26 на клиента.actual time=0.0555..0.0688- миллисекунды до первой и до последней строки этого шага.loops- сколько раз выполнялся шаг. Внутренняя сторона вложенного цикла выполняется для каждой строки внешней стороны.
Ошибка оценки на 20% - норма. Ошибка в 100 раз означает, что оптимизатор выбирал план по неверным данным, и план тоже может быть неверным.
PostgreSQL: читаем дерево плана
PostgreSQL всегда показывает дерево. Запрос по первичному ключу в базе Bookings:
EXPLAIN
SELECT *
FROM bookings.flights
WHERE flight_id = 1001;
Index Scan using flights_pkey on flights  (cost=0.29..8.31 rows=1 width=63)
  Index Cond: (flight_id = 1001)
В каждом узле указаны:
- операция:
Seq Scan(вся таблица),Index Scan(индекс и строки таблицы),Index Only Scan(только индекс),Bitmap Heap Scan(сначала собирает подходящие строки по индексу, затем читает их из таблицы в порядке хранения); cost=0.29..8.31- оценка стоимости до первой строки и для всех строк, в условных единицах (не в миллисекундах);rows- ожидаемое число строк на выходе;width- средний размер строки в байтах;- строки ниже - условие индекса (
Index Cond) или фильтр (Filter).
Индекса на departure_airport нет, поэтому поиск по аэропорту читает всю таблицу:
EXPLAIN
SELECT flight_id, scheduled_departure
FROM bookings.flights
WHERE departure_airport = 'DME';
Seq Scan on flights  (cost=0.00..806.01 rows=3217 width=12)
  Filter: (departure_airport = 'DME'::bpchar)
Здесь полное сканирование оправдано: запрос возвращает около 10% таблицы, а прочитать 33 000 строк подряд дёшево.
EXPLAIN ANALYZE в PostgreSQL
Билеты одного бронирования:
EXPLAIN ANALYZE
SELECT t.passenger_name, tf.fare_conditions, tf.amount
FROM bookings.tickets t
JOIN bookings.ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '00000F';
Gather  (cost=1000.42..9103.17 rows=6 width=30) (actual time=409.864..415.535 rows=2.00 loops=1)
  Workers Planned: 2
  Workers Launched: 2
  ->  Nested Loop  (cost=0.42..8102.57 rows=2 width=30) (actual time=388.369..389.800 rows=0.67 loops=3)
        ->  Parallel Seq Scan on tickets t  (cost=0.00..8086.07 rows=1 width=30) (actual time=386.664..387.206 rows=0.33 loops=3)
              Filter: (book_ref = '00000F'::bpchar)
              Rows Removed by Filter: 122244
        ->  Index Scan using ticket_flights_pkey on ticket_flights tf  (cost=0.42..16.47 rows=3 width=28) (actual time=5.061..7.713 rows=2.00 loops=1)
              Index Cond: (ticket_no = t.ticket_no)
Planning Time: 45.638 ms
Execution Time: 415.774 ms
Читаем изнутри наружу:
Parallel Seq Scan on tickets: три процесса (loops=3- основной и два рабочих) сканируют всю таблицуtickets. Каждый отбрасывает около 122 000 строк (Rows Removed by Filter), чтобы найти один билет.Index Scan on ticket_flights: для найденного билета его перелёты берутся по индексу первичного ключа. Быстро: меньше 8 мс.Nested Loopсоединяет их,Gatherсобирает результаты параллельных процессов.
Весь запрос занимает 415 мс, и почти всё время уходит на первый шаг. Узкое место - узел с наибольшим фактическим временем и большим числом отброшенных строк. Исправление - индекс на tickets (book_ref).
В PostgreSQL rows и loops нужно читать вместе: узел показывает строки за один проход, поэтому всего строк rows × loops. rows=0.33 loops=3 - это одна строка.
До и после индекса
Та же диагностика на тестовой таблице orders из 200 000 строк (10 000 клиентов по 20 заказов):
EXPLAIN ANALYZE
SELECT id, amount, created_at
FROM orders
WHERE customer_id = 42;
Без индекса:
Seq Scan on orders  (cost=0.00..3774.00 rows=20 width=14) (actual time=0.030..19.330 rows=20.00 loops=1)
  Filter: (customer_id = 42)
  Rows Removed by Filter: 199980
Execution Time: 19.379 ms
После CREATE INDEX orders_customer_id_idx ON orders (customer_id);:
Bitmap Heap Scan on orders  (cost=4.45..77.18 rows=20 width=14) (actual time=0.142..0.188 rows=20.00 loops=1)
  Recheck Cond: (customer_id = 42)
  ->  Bitmap Index Scan on orders_customer_id_idx  (cost=0.00..4.45 rows=20 width=0) (actual time=0.120..0.120 rows=20.00 loops=1)
        Index Cond: (customer_id = 42)
Execution Time: 0.293 ms
Вместо 199 980 отброшенных строк - ни одной, а запрос стал примерно в 65 раз быстрее. Теперь запишите условие как customer_id + 0 = 42: план вернётся к Parallel Seq Scan, а оценка станет rows=1000 вместо 20, потому что у оптимизатора нет статистики для выражения.
Способы соединения таблиц
План с несколькими таблицами показывает, как они соединяются:
- Nested Loop - для каждой строки внешнего набора ищутся подходящие строки во внутреннем. Быстро, когда внешний набор маленький, а у внутреннего есть индекс по столбцу соединения, как во всех примерах выше.
- Hash Join - из меньшего набора строится хеш-таблица, через неё прогоняется больший. Хорош для больших наборов без подходящего индекса.
- Merge Join - оба набора отсортированы по ключу соединения и сливаются. Хорош, когда данные уже упорядочены, например прочитаны из индексов.
MySQL в основном использует вложенные циклы и, начиная с 8.0.18, hash join; PostgreSQL и SQL Server используют все три способа.
Тревожные признаки в плане
| Признак | Что обычно означает | Что попробовать |
|---|---|---|
type = ALL / Seq Scan по большой таблице при избирательном условии | нет подходящего индекса | индекс по столбцу из WHERE или JOIN |
key = NULL, хотя индекс есть | условие не SARGable: функция, выражение, LIKE '%...', несовпадение типов | переписать условие, чтобы столбец остался «голым» |
большое Rows Removed by Filter | много строк читается и выбрасывается | индекс или составной индекс, включающий фильтр |
ожидаемые rows сильно отличаются от фактических | устаревшая или отсутствующая статистика | ANALYZE TABLE (MySQL), ANALYZE (PostgreSQL) |
Using temporary; Using filesort, Sort с external merge | группировка или сортировка большого результата, возможно на диске | индекс в нужном порядке, меньше строк до сортировки |
вложенный цикл с большим loops над полным сканированием | внутренняя сторона ищется без индекса | индекс по столбцу соединения внутренней таблицы |
Смотрите на план целиком. Цель - не убрать каждое полное сканирование, а найти шаг, на который уходит больше всего времени.
Как безопасно использовать EXPLAIN ANALYZE
EXPLAIN ANALYZE действительно выполняет запрос. Для SELECT это стоит только времени, но EXPLAIN ANALYZE UPDATE ... или DELETE ... изменяет данные. В PostgreSQL оборачивайте такую проверку в транзакцию:
BEGIN;
EXPLAIN ANALYZE
UPDATE orders SET amount = amount * 1.1 WHERE customer_id = 42;
ROLLBACK;
Помните и о том, что первый запуск может читать данные с диска, а следующие - из памяти. Сравнивайте планы и время после нескольких запусков и на данных, близких к рабочим по объёму: на таблице из 100 строк быстрым будет почти любой план.
Главное из урока:
EXPLAINпоказывает план, который выбрал оптимизатор;EXPLAIN ANALYZEвыполняет запрос и добавляет фактическое время и число строк.- В MySQL начинайте с
type,key,rowsиExtra;ALLиkey = NULLна большой таблице - первые подозреваемые. - Дерево плана читают изнутри наружу: вложенные шаги выполняются первыми и передают строки наверх.
- Узкое место - шаг с наибольшим фактическим временем и большим числом отброшенных строк.
- Большая разница между ожидаемыми и фактическими строками указывает на устаревшую статистику.
- Функция или выражение над индексированным столбцом обычно превращают поиск по индексу в полное сканирование.
EXPLAIN ANALYZEдляUPDATEилиDELETEменяет данные: запускайте его в транзакции с откатом.
Часто задаваемые вопросы
Чем EXPLAIN отличается от EXPLAIN ANALYZE?
EXPLAIN только показывает план с оценками оптимизатора и не выполняет запрос. EXPLAIN ANALYZE выполняет запрос и показывает фактическое время, число строк и проходов для каждого шага, так что оценки можно сравнить с реальностью.
Полное сканирование таблицы - это всегда плохо?
Нет. Полное сканирование - лучший выбор для маленьких таблиц и для запросов, которые возвращают большую часть таблицы: читать строки подряд дешевле, чем переходить между индексом и таблицей. Проблема возникает, когда большая таблица сканируется ради нескольких строк.
Почему база данных не использует мой индекс?
Частые причины: столбец обёрнут в функцию или выражение, LIKE начинается с %, типы сравниваемых значений различаются, условию соответствует большая доля строк или статистика устарела. Какая из причин действует, видно по плану.
Что означает cost в плане?
Cost - оценка объёма работы в условных единицах (чтение страниц и операции процессора), а не миллисекунды. Она полезна для сравнения планов одного и того же запроса; реальное время показывает EXPLAIN ANALYZE.
Вопросы на собеседовании
Как выяснить, почему запрос медленный?
Я запускаю EXPLAIN ANALYZE (или смотрю фактический план выполнения) и ищу шаг с наибольшим временем и наибольшим числом прочитанных и отброшенных строк. Затем проверяю, использует ли он индекс, SARGable ли условие и совпадают ли ожидаемые строки с фактическими.
Что означают типы доступа ALL, index, range и ref в MySQL?
ALL читает всю таблицу; index читает весь индекс; range читает диапазон индекса для BETWEEN, > или IN; ref находит строки по значению индекса. const и eq_ref находят не больше одной строки по уникальному ключу.
Оптимизатор ожидал 10 строк, а получил 100 000. Что вы сделаете?
План построен на неверных оценках, поэтому способ или порядок соединения могут быть неверными. Я обновлю статистику (ANALYZE), проверю, не спрятан ли столбец в выражении, и снова сравню план. Если данные распределены неравномерно, помогут расширенная статистика или переписанный запрос.