Leçon 9.6 · Temps de lecture : ~10 min
La normalisation des bases de données est une façon de concevoir les tables pour que chaque fait soit stocké à un seul endroit. Une base normalisée répartit les données dans des tables liées par des clés, ce qui supprime les doublons et les erreurs qu'ils provoquent. Dans cette leçon, vous allez découvrir les trois premières formes normales (1NF, 2NF, 3NF) et la BCNF, voir comment découper une table large avec SQL et comprendre quand dupliquer volontairement des données est le meilleur choix.
Normalisation des bases de données : 1NF, 2NF et 3NF
Dans les leçons précédentes de ce module, vous avez créé des tables, vous les avez modifiées et vous avez construit des vues par-dessus. Reste une question : quelles tables créer au départ, que mettre dans une même table et que placer dans une table à part.
La normalisation répond à cette question avec quelques règles formelles appelées formes normales. Sakila est une base bien normalisée, ses tables servent donc d'exemples tout au long de la leçon.
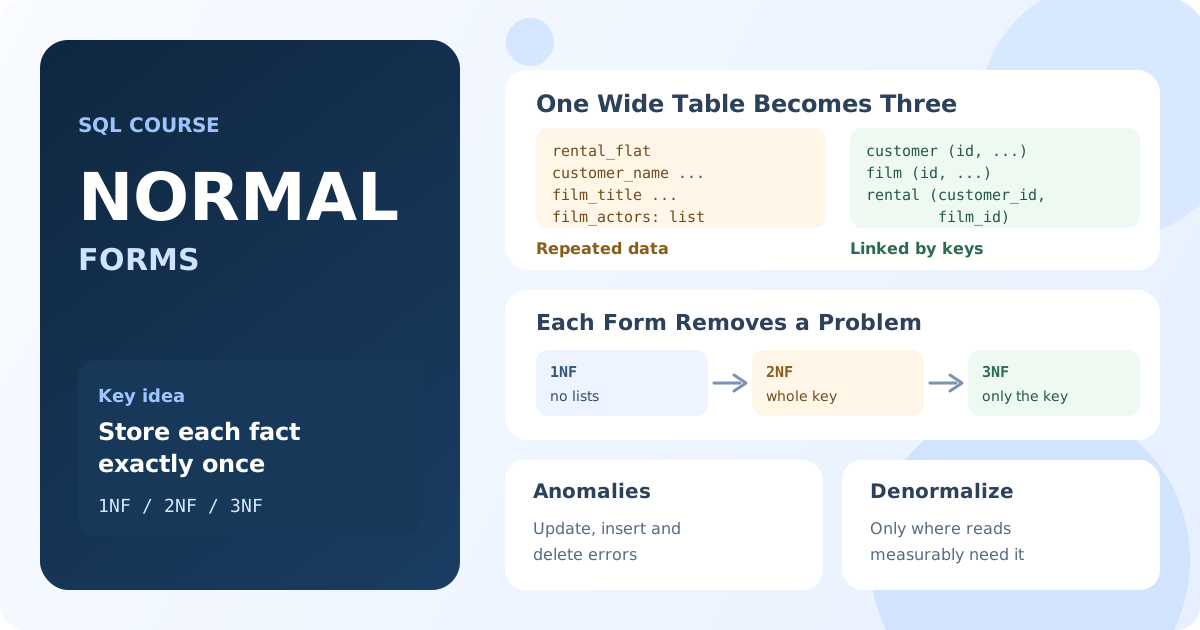
Qu'est-ce que la normalisation d'une base de données ?
La normalisation consiste à organiser les colonnes et les tables de sorte que :
- chaque table décrive un seul type d'entité : un client, un film, une location ;
- chaque fait soit stocké une fois, les autres tables y faisant référence par une clé ;
- chaque colonne non clé dépende de la clé de sa table, et uniquement d'elle.
Les règles sont regroupées en formes normales : 1NF, 2NF, 3NF, BCNF (forme normale de Boyce-Codd) et au-delà. Chaque forme inclut la précédente. En pratique, un schéma en troisième forme normale (3NF) est considéré comme normalisé ; les formes supérieures traitent des cas rares.
Pourquoi normaliser : les anomalies de données
Imaginez que les locations soient stockées dans une seule table large :
| rental_id | rental_date | customer_email | customer_name | customer_city | film_title | film_actors |
|---|---|---|---|---|---|---|
| 1 | 2026-05-01 | mary@example.org | MARY SMITH | Sasebo | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
| 2 | 2026-05-02 | mary@example.org | MARY SMITH | Sasebo | ACE GOLDFINGER | BOB FAWCETT, MINNIE ZELLWEGER |
| 3 | 2026-05-02 | patricia@example.org | PATRICIA JOHNSON | San Bernardino | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
La table est facile à lire, mais les données du client et du film sont répétées à chaque location. Cela provoque trois types de problèmes, appelés anomalies :
- Anomalie de mise à jour. Mary déménage. Il faut modifier toutes ses locations ; si une ligne est oubliée, la base contient deux villes différentes pour le même client.
- Anomalie d'insertion. Impossible d'ajouter un nouveau film tant que personne ne l'a loué, car chaque ligne est une location.
- Anomalie de suppression. Supprimer l'unique location de Patricia supprime aussi tout ce que l'on sait de Patricia.
La normalisation supprime ces anomalies en déplaçant chaque fait vers la table à laquelle il appartient.
Première forme normale (1NF)
Une table est en première forme normale lorsque :
- chaque colonne contient une seule valeur (atomique), pas une liste ;
- il n'y a pas de groupes de colonnes répétés comme
phone1,phone2,phone3; - chaque ligne peut être identifiée par une clé primaire.
La colonne film_actors ci-dessus enfreint la 1NF : elle stocke une liste de noms dans une seule valeur. Une telle colonne est difficile à interroger. Pour trouver les films avec Penelope Guiness, il faut chercher dans le texte avec LIKE, ce qui n'utilise pas d'index et trouve par erreur des noms proches. Compter les films par acteur est encore plus difficile.
Sakila contient un vrai exemple de ce compromis. Dans MySQL, la colonne film.special_features est de type SET et stocke des valeurs comme Trailers,Commentaries :
SELECT special_features, COUNT(*) AS films
FROM film
GROUP BY special_features
ORDER BY films DESC
LIMIT 3;
Résultat : 15 combinaisons de quatre options, en tête Trailers,Commentaries,Behind the Scenes (79 films). Pour compter les films par option, il faut découper ces chaînes.
La solution 1NF est une table séparée avec une ligne par valeur. C'est exactement ce que fait Sakila pour les acteurs : la table film_actor stocke une paire (actor_id, film_id) par ligne.
SELECT a.first_name, a.last_name, COUNT(*) AS films
FROM film_actor AS fa
JOIN actor AS a ON a.actor_id = fa.actor_id
GROUP BY a.actor_id, a.first_name, a.last_name
ORDER BY films DESC
LIMIT 3;
Résultat : les acteurs ayant le plus de films ; GINA DEGENERES arrive en tête avec 42. Avec une liste dans une colonne texte, cette requête serait difficile à écrire.
Deuxième forme normale (2NF)
Une table est en deuxième forme normale lorsqu'elle est en 1NF et que chaque colonne non clé dépend de toute la clé primaire, et non d'une partie seulement.
La 2NF ne concerne que les tables avec une clé composite de plusieurs colonnes. Supposons que film_actor stocke aussi les noms :
| actor_id | film_id | actor_name | film_title |
|---|---|---|---|
| 1 | 1 | PENELOPE GUINESS | ACADEMY DINOSAUR |
| 1 | 23 | PENELOPE GUINESS | ANACONDA CONFESSIONS |
La clé est (actor_id, film_id), mais actor_name ne dépend que de actor_id et film_title que de film_id. C'est une dépendance partielle : le nom de l'acteur est répété pour chacun de ses films.
La correction consiste à déplacer chaque colonne vers la table dont elle dépend de la clé : les noms vers actor, les titres vers film. La vraie table film_actor ne garde que les deux clés et last_update.
Troisième forme normale (3NF)
Une table est en troisième forme normale lorsqu'elle est en 2NF et qu'aucune colonne non clé ne dépend d'une autre colonne non clé. Une telle chaîne, clé → colonne A → colonne B, s'appelle une dépendance transitive.
Par exemple, si la table address stockait le pays :
| address_id | address | city_id | city | country |
|---|---|---|---|---|
| 5 | 1913 Hanoi Way | 463 | Sasebo | Japan |
| 6 | 1121 Loja Avenue | 449 | San Bernardino | United States |
city et country dépendent de city_id, pas de address_id. Chaque adresse d'une même ville répète le nom de la ville et le pays, et renommer un pays oblige à modifier des milliers d'adresses.
Sakila résout ce problème avec une chaîne de tables : address stocke city_id, city stocke country_id, et seul country contient le nom. Chaque nom est stocké une fois, et une requête les réunit avec JOIN :
SELECT co.country, COUNT(*) AS customers
FROM customer AS c
JOIN address AS a ON a.address_id = c.address_id
JOIN city AS ci ON ci.city_id = a.city_id
JOIN country AS co ON co.country_id = ci.country_id
GROUP BY co.country
ORDER BY customers DESC
LIMIT 5;
Résultat : India (60), China (53), United States (36), Japan (31) et Mexico (30). Les données normalisées se lisent avec des jointures : c'est le prix à payer pour stocker chaque fait une seule fois.
Une formule courte pour retenir la 1NF à la 3NF : chaque colonne non clé doit dépendre de la clé, de toute la clé et de rien d'autre que la clé.
Forme normale de Boyce-Codd (BCNF)
La BCNF est une version plus stricte de la 3NF : toute colonne qui détermine une autre colonne doit être une clé candidate. La différence n'apparaît que dans les tables qui ont plusieurs clés candidates qui se chevauchent, ce qui est rare. La plupart des tables en 3NF sont déjà en BCNF. Les quatrième et cinquième formes normales traitent des dépendances multivaluées et sont rarement abordées en dehors de la théorie des bases de données.
Comment normaliser une table avec SQL
Découpons la table large du début de la leçon, stockée sous le nom rental_flat, en tables normalisées. Exécutez ces instructions dans votre propre base : les bases d'exemple de SQLtest sont en lecture seule. D'abord, la nouvelle structure :
CREATE TABLE customer_n (
    customer_id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(50) NOT NULL UNIQUE,
    name VARCHAR(90) NOT NULL,
    city VARCHAR(50) NOT NULL
);

CREATE TABLE film_n (
    film_id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL UNIQUE
);

CREATE TABLE rental_n (
    rental_id INT PRIMARY KEY,
    rental_date DATE NOT NULL,
    customer_id INT NOT NULL,
    film_id INT NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customer_n (customer_id),
    FOREIGN KEY (film_id) REFERENCES film_n (film_id)
);
Remarque : c'est la syntaxe MySQL. Dans PostgreSQL, remplacez INT AUTO_INCREMENT par INT GENERATED ALWAYS AS IDENTITY.
Ensuite, on copie les données. SELECT DISTINCT garde une ligne par client et par film, et les locations retrouvent leurs clés avec JOIN :
INSERT INTO customer_n (email, name, city)
SELECT DISTINCT customer_email, customer_name, customer_city
FROM rental_flat;

INSERT INTO film_n (title)
SELECT DISTINCT film_title
FROM rental_flat;

INSERT INTO rental_n (rental_id, rental_date, customer_id, film_id)
SELECT r.rental_id, r.rental_date, c.customer_id, f.film_id
FROM rental_flat AS r
JOIN customer_n AS c ON c.email = r.customer_email
JOIN film_n AS f ON f.title = r.film_title;
Résultat : 2 clients, 2 films et 3 locations. La ville de Mary est désormais stockée dans une seule ligne : un seul UPDATE la modifie partout.
Si SELECT DISTINCT renvoie deux lignes pour le même e-mail, les données sont déjà incohérentes : le même client a des noms ou des villes différents selon les locations. La contrainte UNIQUE sur email rejettera la deuxième ligne, et il faudra décider quelle valeur est correcte. La normalisation révèle souvent ce genre de problèmes.
La liste des acteurs va de la même façon dans deux tables, actor et film_actor. La ville suivrait l'exemple de la 3NF : une table city séparée et une colonne city_id dans customer_n.
Dénormalisation : quand les doublons sont acceptables
La dénormalisation consiste à stocker volontairement des données redondantes pour rendre la lecture plus rapide ou plus simple. C'est un compromis conscient, pas une erreur de conception, et Sakila en contient elle-même quelques exemples :
paymentstockecustomer_id, alors qu'on peut le retrouver viarental_id. Ce doublon évite une jointure dans les rapports de paiements ; les deux valeurs concordent dans les 16 044 paiements liés à une location.- La table
film_textreprendtitleetdescriptiondefilmpour la recherche plein texte. - La vue
film_listrenvoie les acteurs sous forme d'une seule chaîne séparée par des virgules. Une vue ne stocke rien : elle offre un format large pratique, sans les anomalies.
Raisons courantes de dénormaliser :
- les rapports et tableaux de bord qui joignent de nombreuses grandes tables à chaque requête ;
- les compteurs et totaux, comme le montant total des paiements d'un client, coûteux à recalculer ;
- les entrepôts de données en schéma en étoile, chargés par lots et rarement mis à jour.
La règle de base : concevez d'abord un schéma normalisé, puis dénormalisez les endroits précis où vous avez mesuré un problème de performance. Chaque doublon doit avoir un moyen de rester synchronisé : un trigger, une tâche planifiée ou le code de l'application.
Points clés :
- La normalisation stocke chaque fait une fois et lie les tables par des clés ; elle évite les anomalies de mise à jour, d'insertion et de suppression.
- 1NF : une valeur par colonne, pas de listes ni de groupes de colonnes répétés, une clé primaire dans chaque table.
- 2NF : aucune colonne ne dépend d'une partie d'une clé composite.
- 3NF : aucune colonne ne dépend d'une autre colonne non clé ; « la clé, toute la clé et rien que la clé ».
- Les données normalisées se lisent avec
JOIN; une vue peut les présenter dans un format large. - Dénormalisez délibérément et seulement là où la lecture l'exige, avec un plan pour garder les copies synchronisées.
Cette leçon termine le module sur la création et la modification des tables. Le module suivant porte sur l'écriture d'un SQL lisible et rapide : bonnes pratiques, optimisation des requêtes et index.
Questions fréquentes
Qu'est-ce que la normalisation d'une base de données ?
La normalisation consiste à organiser les données en tables liées pour que chaque fait ne soit stocké qu'une fois. Elle supprime les doublons et les anomalies qu'ils entraînent, comme un même client avec deux adresses différentes dans deux lignes.
Quelle est la différence entre 1NF, 2NF et 3NF ?
La 1NF exige des valeurs atomiques et une clé primaire. La 2NF interdit en plus les colonnes qui ne dépendent que d'une partie d'une clé composite. La 3NF interdit en plus les colonnes qui dépendent d'autres colonnes non clés, comme un nom de pays stocké à côté d'un identifiant de ville.
Une base normalisée est-elle toujours meilleure ?
Pour des données qui changent, généralement oui : elle garde les données cohérentes et le schéma flexible. Pour le reporting et l'analyse, une dénormalisation contrôlée peut rendre les lectures bien plus rapides. Commencez normalisé et dénormalisez là où un besoin a été mesuré.
La normalisation ralentit-elle les requêtes ?
Les lectures demandent plus de jointures, ce qui coûte un peu de temps, mais avec des index sur les colonnes clés les jointures sont rapides. Les écritures sont souvent plus rapides, car chaque modification met à jour une ligne au lieu de nombreuses copies.
Questions d'entretien
Expliquez les anomalies de mise à jour, d'insertion et de suppression.
Une anomalie de mise à jour survient quand un même fait est stocké dans plusieurs lignes et qu'une mise à jour en oublie certaines. Une anomalie d'insertion survient quand on ne peut pas ajouter un fait sans données sans rapport, comme un film sans location. Une anomalie de suppression survient quand supprimer un fait en supprime un autre, comme l'unique location d'un client qui fait disparaître le client.
Qu'est-ce qu'une dépendance transitive ? Donnez un exemple.
C'est quand une colonne non clé dépend d'une autre colonne non clé au lieu de la clé. Dans address(address_id, city_id, city_name), city_name dépend de city_id, pas de address_id. La solution est une table city séparée, ce qui amène le schéma en 3NF.
Quand dénormaliseriez-vous un schéma ?
Quand les lectures sont beaucoup plus fréquentes que les écritures et que les jointures sont devenues un goulot d'étranglement mesuré, par exemple dans les rapports, les tableaux de bord et les entrepôts de données. Stockez les données redondantes avec un moyen clair de les synchroniser, comme un trigger ou une actualisation planifiée.