La casse en SQL selon les SGBD
Leçon 1.9 · Temps de lecture : ~9 min
La casse en SQL intervient à trois niveaux : les mots-clés, les noms d'objets et les données. Les mots-clés comme SELECT sont insensibles à la casse dans tous les SGBD, mais savoir si Customer et customer désignent la même table dépend du SGBD, des guillemets et parfois même du système d'exploitation. Dans cette leçon, vous découvrirez les règles des principaux SGBD, le piège classique des noms entre guillemets, la façon dont les comparaisons de chaînes traitent la casse et un style de nommage qui évite tous ces problèmes.
Dans la leçon 1.8, vous avez vu que les SGBD suivent le standard SQL avec leur propre dialecte. La casse est l'une des différences les plus visibles : une requête qui fonctionne dans SQL Server peut échouer dans PostgreSQL avec relation "Customer" does not exist, et une requête écrite sur un portable Windows peut échouer sur un serveur Linux.
Connaître les règles avant d'écrire vos premières requêtes vous épargne des heures à chercher une table qui « existe forcément ».
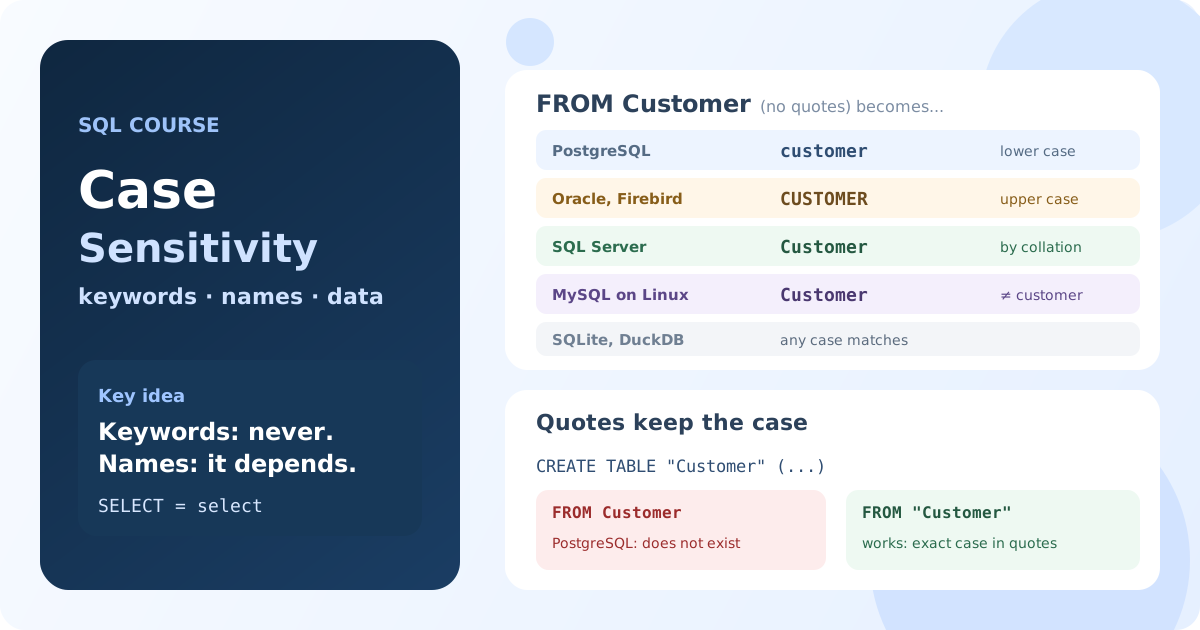
Trois niveaux de casse en SQL
Quand on demande « SQL est-il sensible à la casse ? », on parle en fait de trois choses différentes :
- Les mots-clés et les noms de fonctions :
SELECT,select,COUNT,count. - Les identifiants : les noms des bases, tables, colonnes et alias, que vous avez rencontrés dans la leçon 1.7.
- Les données : la chaîne
'abc'est-elle égale à'ABC'dans une conditionWHERE?
Chaque niveau a ses propres règles : voyons-les un par un.
Les mots-clés SQL sont insensibles à la casse
Les mots-clés et les noms des fonctions intégrées s'écrivent dans n'importe quelle casse, quel que soit le SGBD :
sElEcT title
FrOm film
WhErE film_id = 1;
Résultat : ACADEMY DINOSAUR. MySQL, PostgreSQL, SQL Server, Oracle, Firebird et SQLite exécutent la requête avec n'importe quel mélange de casses.
Écrire les mots-clés en MAJUSCULES n'est qu'une convention : cela sépare le langage des noms de tables et de colonnes et rend les longues requêtes plus lisibles. Ce cours écrit les mots-clés en majuscules et les noms en minuscules, comme le recommandent la plupart des guides de style.
Identifiants sans guillemets : chaque SGBD convertit à sa façon
Le standard SQL dit qu'un nom sans guillemets est converti en majuscules : customer, Customer et CUSTOMER sont donc le même nom. Les SGBD appliquent cette idée de manières différentes.
PostgreSQL : les noms passent en minuscules
PostgreSQL convertit tout nom sans guillemets en minuscules, à l'inverse du standard :
SELECT Model, AIRCRAFT_CODE
FROM Aircrafts
WHERE aircraft_code = '773';
Résultat : Boeing 777-300. La table est enregistrée sous le nom aircrafts, et les en-têtes des colonnes reviennent sous la forme model et aircraft_code.
Les alias sont convertis eux aussi : SELECT model AS TotalModel renvoie une colonne nommée totalmodel. La casse que vous avez tapée disparaît dès l'analyse de la requête.
Oracle et Firebird : les noms passent en majuscules
Oracle et Firebird suivent le standard et convertissent les noms sans guillemets en majuscules :
select first_name, Last_Name
from Employee
where emp_no = 2;
Résultat dans Firebird : Robert Nelson, avec les en-têtes FIRST_NAME et LAST_NAME. Il se passe la même chose dans Oracle avec hr.Employees.
C'est pourquoi les outils affichent les tables d'Oracle et de Firebird en capitales : EMPLOYEES, EMPLOYEE.
SQL Server : la collation décide
SQL Server ne convertit pas du tout les noms. Il garde la casse utilisée dans CREATE TABLE et compare les noms selon la collation de la base : l'ensemble des règles de comparaison du texte.
La collation par défaut, par exemple SQL_Latin1_General_CP1_CI_AS, est insensible à la casse (CI) : ces noms sont donc identiques.
select name, listprice
from PRODUCT
where productid = 680;
Résultat : HL Road Frame - Black, 58. Dans AdventureWorks, les en-têtes reviennent tels que vous les avez tapés : name et listprice.
Une base créée avec une collation sensible à la casse (_CS_) traite Product et PRODUCT comme des noms différents. Ces bases sont rares mais existent : vérifiez DATABASEPROPERTYEX(DB_NAME(), 'Collation') avant de supposer quoi que ce soit.
MySQL et MariaDB : les noms de tables suivent le système d'exploitation
Dans MySQL et MariaDB, une base est un dossier et une table un fichier : les règles de casse des bases et des tables viennent donc du système de fichiers. Le paramètre lower_case_table_names les contrôle :
| Valeur | Par défaut sous | Noms de tables |
|---|---|---|
0 | Linux | enregistrés tels quels, comparés en tenant compte de la casse |
1 | Windows | enregistrés en minuscules, comparés sans tenir compte de la casse |
2 | macOS | enregistrés tels quels, comparés sans tenir compte de la casse |
Le bac à sable de ce cours tourne sous Linux : une mauvaise casse dans le nom d'une table provoque donc une erreur.
SELECT title
FROM FILM
WHERE film_id = 1;
Résultat : Table 'sakila.FILM' doesn't exist. Avec FROM film, la requête fonctionne.
Sous Linux, Customer et customer peuvent même être deux tables différentes dans la même base. Les alias de tables suivent la même règle : FROM film F avec WHERE f.film_id = 1 échoue avec Unknown column 'f.title'.
En revanche, les noms de colonnes sont insensibles à la casse dans MySQL et MariaDB sur tous les systèmes : SELECT TITLE, Film_ID FROM film fonctionne.
SQLite et DuckDB : jamais sensibles à la casse
SQLite et DuckDB comparent les noms sans tenir compte de la casse, même entre guillemets, et retiennent la casse utilisée à la création de l'objet :
CREATE TEMP TABLE "Customer" ("FullName" text);
INSERT INTO "Customer" VALUES ('Orlando Gee');

SELECT fullname
FROM CUSTOMER;
Résultat dans SQLite et DuckDB : Orlando Gee sous l'en-tête FullName. Impossible de créer une seconde table nommée customer : le nom est pris.
Les identifiants entre guillemets gardent leur casse
Les guillemets transforment un nom en identifiant délimité : le SGBD l'utilise exactement tel qu'il est écrit, avec sa casse, ses espaces et ses mots réservés. Le standard utilise des guillemets doubles ; MySQL utilise des accents graves, et SQL Server accepte aussi les crochets :
| SGBD | Nom entre guillemets |
|---|---|
| PostgreSQL, Oracle, Firebird, SQLite, DuckDB | "Customer" |
| MySQL, MariaDB | `Customer` |
| SQL Server | [Customer] ou "Customer" |
Dans PostgreSQL, Oracle et Firebird, un nom entre guillemets est sensible à la casse. C'est l'origine de l'erreur de casse la plus courante.
Le piège "Customer" dans PostgreSQL
Beaucoup d'outils, d'ORM et de scripts de migration créent des tables aux noms entre guillemets. Voici ce qui se passe ensuite :
CREATE TEMP TABLE "Customer" ("CustomerID" int, "FullName" text);
INSERT INTO "Customer" VALUES (1, 'Orlando Gee');

SELECT *
FROM Customer;
Résultat : relation "customer" does not exist. Le Customer sans guillemets est devenu customer, alors que la table s'appelle Customer.
Dès qu'un nom a été créé entre guillemets avec des majuscules, chaque requête doit aussi le mettre entre guillemets, avec exactement la même casse :
SELECT "FullName"
FROM "Customer";
Résultat : Orlando Gee. Sans guillemets, SELECT FullName échoue avec column "fullname" does not exist.
PostgreSQL vous met même sur la piste : Perhaps you meant to reference the column "Customer.FullName". Oracle et Firebird ont le problème inverse : hr."employees" échoue, car la table est enregistrée sous le nom EMPLOYEES.
Dans MySQL, les guillemets doubles sont une chaîne
Dans MySQL et MariaDB, les guillemets doubles ne désignent même pas un nom : par défaut, ils délimitent une chaîne, comme les guillemets simples.
SELECT "title"
FROM film
WHERE film_id = 1;
Résultat : le mot title, et non le titre du film. MySQL renvoie la constante texte 'title' pour chaque ligne.
La requête n'échoue pas : l'erreur passe donc facilement inaperçue. Utilisez les accents graves pour les noms dans MySQL, ou activez le mode ANSI_QUOTES pour que les guillemets doubles suivent le standard.
La casse dans les données : comparer des chaînes
Le troisième niveau, ce sont les données elles-mêmes. Que 'abc' = 'ABC' soit vrai dépend du SGBD et de la collation de la colonne :
| SGBD | 'abc' = 'ABC' par défaut | LIKE | Recherche insensible à la casse |
|---|---|---|---|
| MySQL, MariaDB | vrai | insensible à la casse | déjà par défaut ; BINARY ou collation _bin pour une recherche exacte |
| SQL Server | vrai (collation CI) | insensible à la casse | déjà par défaut ; COLLATE ..._CS_AS pour une recherche exacte |
| PostgreSQL | faux | sensible à la casse | ILIKE, LOWER() |
| Oracle | faux | sensible à la casse | UPPER(), LOWER() |
| Firebird | faux | sensible à la casse | CONTAINING, UPPER() |
| SQLite | faux | insensible (lettres latines) | COLLATE NOCASE, LOWER() |
| DuckDB | faux | sensible à la casse | ILIKE, COLLATE NOCASE |
La même condition donne des résultats différents. Dans PostgreSQL, la base Bookings ne contient pas de ville 'moscow' :
SELECT COUNT(*)
FROM airports
WHERE city = 'moscow';
Résultat : 0. Avec WHERE lower(city) = 'moscow' ou WHERE city ILIKE 'moscow', la requête trouve 3 aéroports de Moscou.
Dans MySQL, la requête équivalente sur Sakila trouve les acteurs du premier coup :
SELECT COUNT(*)
FROM actor
WHERE last_name = 'davis';
Résultat : 3, bien que les noms soient enregistrés sous la forme DAVIS. Avec WHERE BINARY last_name = 'davis', le résultat est 0.
C'est pourquoi une requête portée de MySQL ou de SQL Server vers PostgreSQL peut renvoyer moins de lignes sans prévenir. Quand la casse des données n'a pas d'importance, dites-le dans la requête : comparez LOWER(colonne) à une valeur en minuscules. Les collations font bien plus que gérer la casse : elles définissent aussi le tri et les accents, et auront leur propre leçon plus loin dans le cours.
La casse selon les SGBD
| SGBD | Noms sans guillemets | Noms entre guillemets | 'abc' = 'ABC' |
|---|---|---|---|
| PostgreSQL | minuscules | sensibles à la casse | faux |
| Oracle | majuscules | sensibles à la casse | faux |
| Firebird | majuscules | sensibles à la casse | faux |
| SQL Server | tels qu'écrits, comparés selon la collation (en général insensibles) | comme sans guillemets | vrai avec une collation CI |
| MySQL, MariaDB | tables et bases : selon lower_case_table_names (sensibles sous Linux) ; colonnes : insensibles | comme sans guillemets | vrai |
| SQLite | insensibles | insensibles | faux |
| DuckDB | insensibles | insensibles | faux |
Les mots-clés et les noms de fonctions sont insensibles à la casse dans tous ces SGBD.
Des règles de nommage qui évitent les problèmes de casse
Inutile de retenir tout le tableau si vous suivez quelques règles :
- Nommez tables et colonnes en minuscules avec des tirets bas :
customer_order,total_amount. Ces noms ont le même sens dans tous les SGBD et n'ont jamais besoin de guillemets. - Ne créez pas de noms entre guillemets avec des majuscules ou des espaces. Si un outil les a créés, mettez-les partout entre guillemets avec la casse exacte.
- Écrivez chaque nom partout avec la même casse, même là où le SGBD le tolère : une requête écrite sous Windows ou dans SQL Server fonctionnera alors aussi sous Linux et dans PostgreSQL.
- Écrivez les mots-clés en majuscules pour la lisibilité ; le SGBD n'en a que faire.
- Pour les conditions sur du texte, décidez si la casse compte et indiquez-le explicitement avec
LOWER(),UPPER()ouILIKE, au lieu de compter sur la collation par défaut.
D'autres conseils de nommage sont réunis dans la leçon 10.1. Avec ces règles en tête, vous êtes prêt pour le module suivant, où vous commencerez à interroger les données avec SELECT.
Points clés :
- Les mots-clés et les noms de fonctions SQL sont insensibles à la casse dans tous les SGBD ; les majuscules sont une convention de style.
- Les noms sans guillemets sont convertis en minuscules dans PostgreSQL et en majuscules dans Oracle et Firebird ; SQL Server les compare selon la collation de la base.
- Dans MySQL et MariaDB, les noms de tables sont sensibles à la casse sous Linux (
lower_case_table_names = 0), contrairement aux noms de colonnes. - Un nom entre guillemets garde sa casse : une table créée sous le nom
"Customer"dans PostgreSQL doit toujours s'écrire"Customer". 'abc' = 'ABC'est vrai par défaut dans MySQL et SQL Server, et faux dans PostgreSQL, Oracle, Firebird, SQLite et DuckDB.- Des noms en
snake_caseminuscule, sans guillemets, fonctionnent de la même façon partout.
Questions fréquentes
SQL est-il sensible à la casse ?
Les mots-clés SQL ne le sont pas : SELECT et select sont identiques partout. Les noms de tables et de colonnes dépendent du SGBD : PostgreSQL, Oracle et Firebird convertissent les noms sans guillemets dans une seule casse, SQL Server utilise la collation, et les noms de tables de MySQL suivent le système d'exploitation. Les comparaisons de chaînes dépendent de la collation des données.
Les noms de tables sont-ils sensibles à la casse dans MySQL ?
Sous Linux, oui : avec la valeur par défaut lower_case_table_names = 0, FILM et film sont deux tables différentes. Sous Windows et macOS, c'est la même table. Les noms de colonnes sont insensibles à la casse sur tous les systèmes ; par sécurité, nommez donc les tables en minuscules.
Pourquoi PostgreSQL dit-il qu'une relation n'existe pas alors que la table est là ?
La table a très probablement été créée avec un nom entre guillemets contenant des majuscules, comme "Customer". PostgreSQL convertit le Customer sans guillemets de votre requête en customer, qui est un autre nom. Écrivez le nom entre guillemets doubles avec la casse exacte : FROM "Customer".
Comment faire une recherche insensible à la casse dans PostgreSQL ?
Utilisez ILIKE au lieu de LIKE (WHERE city ILIKE 'moscow'), ou comparez des valeurs en minuscules : WHERE lower(city) = 'moscow'. Pour des recherches fréquentes, un index sur lower(city) rend la seconde variante rapide.
Faut-il écrire les mots-clés SQL en majuscules ?
Le SGBD n'en a que faire : c'est une question de style. Mots-clés en majuscules et noms en minuscules, c'est la convention la plus répandue, car elle fait ressortir la structure de la requête. L'essentiel est de rester cohérent au sein d'un projet.