Leçon 10.6 · Temps de lecture : ~10 min
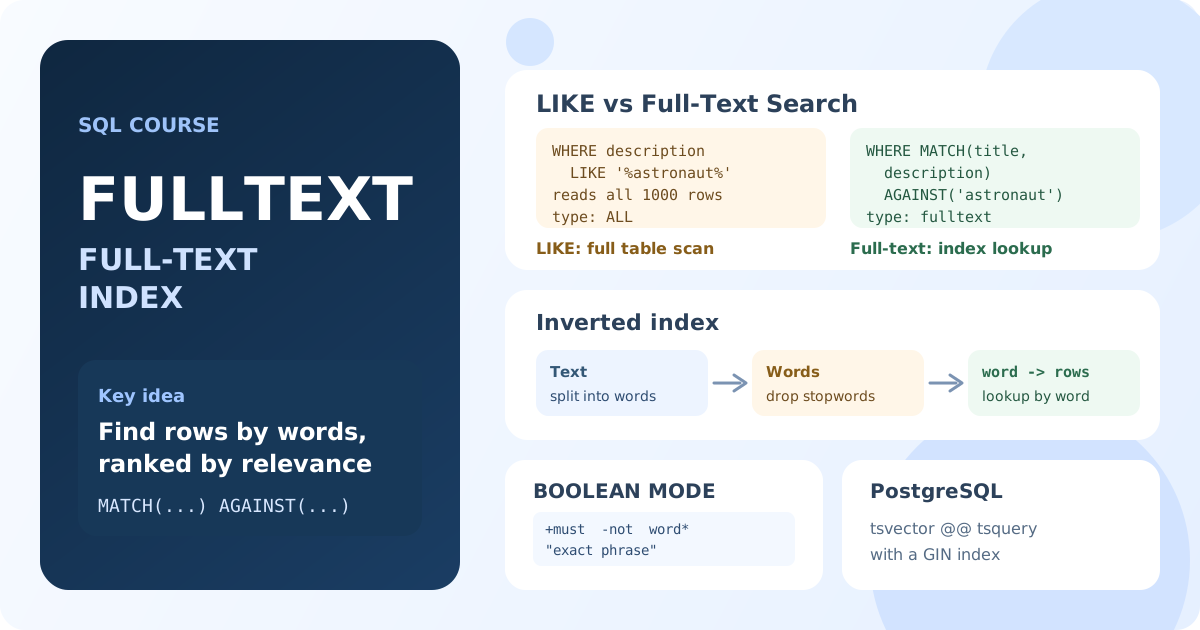
Un index full-text (index de texte intégral) est un index des mots contenus dans des colonnes de texte : pour chaque mot, il stocke les lignes qui le contiennent. Il permet de trouver des lignes par mots et de les classer par pertinence, alors que LIKE '%mot%' doit lire toute la table pour cela. Dans cette leçon, vous allez créer un index full-text dans MySQL, chercher avec MATCH … AGAINST en mode langage naturel et en mode booléen, découvrir les règles qui rendent certains mots introuvables et voir comment PostgreSQL résout le même problème.
Index full-text en SQL
Dans les leçons précédentes, vous avez vu comment les index B-tree accélèrent la recherche par valeur ou par début de valeur. Chercher un mot au milieu d'un texte est différent : WHERE description LIKE '%astronaut%' ne peut pas utiliser un index B-tree, car le mot peut commencer n'importe où dans la chaîne.
C'est précisément le rôle des index full-text. Les exemples MySQL s'exécutent sur la table Sakila film_text, qui possède déjà un index full-text ; la partie PostgreSQL a été vérifiée sur PostgreSQL 17.
Qu'est-ce qu'un index full-text ?
Quand vous créez un index full-text, la base découpe le texte en mots (tokens), écarte les mots trop courts et les mots très fréquents comme « the » ou « and » (mots vides) et construit un index inversé : une liste de mots, chacun associé aux lignes qui le contiennent.
| Index B-tree | Index full-text | |
|---|---|---|
| Indexe | les valeurs entières de la colonne | les mots isolés |
| Recherches rapides | =, plages, LIKE 'abc%' | mots et phrases n'importe où dans le texte |
LIKE '%mot%' | non utilisé | non utilisé non plus |
| Ordre du résultat | par valeur | par pertinence |
| Syntaxe MySQL | WHERE col = … | WHERE MATCH(col) AGAINST(…) |
Un index full-text ne fonctionne qu'avec sa propre syntaxe de recherche : MATCH … AGAINST dans MySQL, @@ dans PostgreSQL. Un LIKE ordinaire ne l'utilise jamais.
Créer un index full-text dans MySQL
Un index full-text s'ajoute sur des colonnes CHAR, VARCHAR ou TEXT :
CREATE FULLTEXT INDEX ft_film_description ON film (title, description);
On obtient la même chose avec ALTER TABLE film ADD FULLTEXT INDEX ft_film_description (title, description); ou dans le CREATE TABLE. Les bases d'exemple de SQLtest sont en lecture seule : exécutez ces instructions dans votre propre base.
Sakila possède déjà un tel index sur film_text :
SHOW INDEX FROM film_text;
Résultat : PRIMARY (type BTREE) sur film_id, et idx_title_description (type FULLTEXT) sur les colonnes title et description.
Chercher avec MATCH … AGAINST
MATCH liste les colonnes indexées, AGAINST les mots à chercher :
SELECT film_id, title,
    ROUND(MATCH(title, description) AGAINST ('astronaut crocodile'), 3) AS score
FROM film_text
WHERE MATCH(title, description) AGAINST ('astronaut crocodile')
ORDER BY score DESC
LIMIT 5;
Résultat : PHANTOM GLORY (4.239), STONE FIRE (4.196), ROAD ROXANNE, NEIGHBORS CHARADE (4.153) et LOVELY JINGLE (3.146). Les films qui contiennent les deux mots arrivent en premier.
C'est le mode langage naturel (natural language mode), utilisé par défaut. Une ligne correspond si elle contient l'un des mots : ici, 173 films contiennent « astronaut » ou « crocodile ». Le même MATCH … AGAINST dans le SELECT renvoie le score de pertinence, et l'on peut trier le résultat par ce score.
La liste de colonnes de MATCH doit correspondre exactement à celle d'un index full-text. MATCH(description) AGAINST ('astronaut') échoue avec « Can't find FULLTEXT index matching the column list », car l'index porte sur title et description ensemble.
Mode booléen
IN BOOLEAN MODE ajoute des opérateurs pour des recherches précises :
| Opérateur | Signification | Exemple | Films dans film_text |
|---|---|---|---|
+ | le mot est obligatoire | '+astronaut +crocodile' | 4 |
- | le mot doit être absent | '+astronaut -crocodile' | 74 |
* | préfixe | 'dino*' | 3 |
" " | phrase exacte | '"mad scientist"' | 97 |
SELECT film_id, title
FROM film_text
WHERE MATCH(title, description) AGAINST ('+astronaut +crocodile' IN BOOLEAN MODE);
Résultat : 4 films dont le titre ou la description contient les deux mots.
Sans opérateurs, le mode booléen trouve lui aussi les lignes contenant l'un des mots, mais ne les trie pas par pertinence.
Recherche full-text et LIKE
Comparez les plans des deux recherches :
EXPLAIN SELECT film_id FROM film_text WHERE MATCH(title, description) AGAINST ('astronaut');

EXPLAIN SELECT film_id FROM film_text WHERE description LIKE '%astronaut%';
Résultat : la première requête utilise l'index idx_title_description (type d'accès fulltext) ; la seconde lit les 1000 lignes (type ALL).
Les deux recherches ne trouvent pas non plus la même chose :
LIKE '%cat%'trouve n'importe quelle sous-chaîne : « cat », mais aussi « category » et « Catherine ». Un index full-text trouve des mots entiers.LIKEvérifie un motif dans une colonne ; la recherche full-text cherche plusieurs mots dans plusieurs colonnes et classe le résultat.- Sur une table de plusieurs millions de lignes,
LIKE '%mot%'lit chaque ligne, alors qu'un index full-text ne lit que la liste du mot.
Les règles qui surprennent les débutants
Certains mots sont tout simplement introuvables, et ce n'est pas un bug :
- Longueur minimale des mots. Les mots plus courts ne sont pas indexés : 3 caractères dans InnoDB (
innodb_ft_min_token_size), 4 dans MyISAM (ft_min_word_len).film_textest une table MyISAM, doncAGAINST ('cat')n'y trouve rien, alors qu'une table InnoDB trouve « cat ». - Mots vides. Les mots fréquents comme « the », « a », « and » sont ignorés :
AGAINST ('the')renvoie 0 ligne. - Pas de formes de mots dans MySQL. L'index stocke les mots tels quels : « running » ne trouve pas « run ». Pour les différentes terminaisons, utilisez un préfixe en mode booléen :
'run*'. - La règle des 50 %. En mode langage naturel de MyISAM, un mot présent dans plus de la moitié des lignes est jugé trop fréquent et ignoré.
La longueur minimale et la liste des mots vides se modifient dans les paramètres du serveur, puis l'index doit être reconstruit.
Recherche full-text dans PostgreSQL
PostgreSQL n'a pas de mot-clé FULLTEXT. Le texte est converti en tsvector (une liste de mots normalisés), la requête en tsquery, et l'opérateur @@ vérifie s'ils correspondent :
SELECT to_tsvector('english', 'Runners should run slowly at first');
Résultat : 'first':6 'run':3 'runner':1 'slowli':4. Les mots sont réduits à leur radical, et « should » et « at » sont écartés comme mots vides.
Grâce aux radicaux, chercher « run » trouve aussi « running », et « cats » trouve « cat », ce que MySQL ne fait pas. Pour la vitesse, on stocke le tsvector dans une colonne générée et on l'indexe avec GIN, le type d'index de PostgreSQL pour la recherche full-text :
ALTER TABLE film
ADD COLUMN search tsvector
    GENERATED ALWAYS AS (to_tsvector('english', title || ' ' || description)) STORED;

CREATE INDEX film_search_idx ON film USING GIN (search);

SELECT title, ts_rank(search, query) AS rank
FROM film, websearch_to_tsquery('english', 'astronaut -crocodile') AS query
WHERE search @@ query
ORDER BY rank DESC
LIMIT 5;
Remarque : websearch_to_tsquery comprend la syntaxe des moteurs de recherche : guillemets pour les phrases, or, et - pour exclure un mot. ts_rank joue le rôle du score de pertinence de MySQL.
Les autres bases ont leurs propres outils : SQL Server utilise un catalogue full-text avec CONTAINS et FREETEXT, SQLite l'extension FTS5. Pour chercher dans des millions de documents en tenant compte des fautes de frappe et des synonymes, on utilise des moteurs dédiés comme Elasticsearch.
Quand utiliser un index full-text
Bons cas d'usage :
- la recherche par mots dans des descriptions, articles, commentaires, noms de produits ;
- les « barres de recherche » dont les résultats doivent être classés par pertinence ;
- les grandes tables sur lesquelles
LIKE '%mot%'est devenu lent.
Mauvais cas d'usage :
- la recherche par valeur exacte ou par début de valeur : un index B-tree fait mieux ;
- les codes courts et les valeurs plus courtes que la longueur minimale des mots ;
- la recherche de sous-chaînes arbitraires à l'intérieur des mots, comme une partie d'une référence produit.
Points clés :
- Un index full-text associe chaque mot aux lignes qui le contiennent ;
LIKE '%mot%'n'utilise ni index B-tree ni index full-text. - Dans MySQL, on le crée avec
FULLTEXT INDEXet on cherche avecMATCH(colonnes) AGAINST('mots'); les colonnes doivent correspondre exactement à l'index. - Le mode langage naturel renvoie les lignes contenant l'un des mots, classées par pertinence ; le mode booléen ajoute
+,-,*et les phrases. - Les mots courts et les mots vides ne sont pas indexés, et MySQL ne gère pas les formes de mots : « running » ne trouve pas « run ».
- PostgreSQL utilise
tsvector,tsquery, l'opérateur@@et un index GIN, et gère les formes de mots.
Questions fréquentes
Qu'est-ce qu'un index full-text en SQL ?
C'est un index des mots contenus dans des colonnes de texte : pour chaque mot, la base stocke les lignes qui le contiennent. Il rend la recherche par mots rapide et permet de classer les résultats par pertinence.
Pourquoi LIKE '%mot%' n'utilise-t-il pas d'index ?
Un index B-tree est trié par le début de la valeur, et un motif qui commence par % peut correspondre n'importe où dans la chaîne : la base doit donc lire chaque ligne. La recherche full-text avec MATCH … AGAINST ou @@ utilise un index full-text.
Pourquoi ma recherche full-text ne trouve-t-elle rien pour un mot court ?
Les mots plus courts que la longueur minimale (3 caractères dans InnoDB, 4 dans MyISAM) et les mots vides comme « the » ne sont pas indexés. Cherchez un mot plus long, utilisez une autre méthode ou modifiez les paramètres du serveur et reconstruisez l'index.
Quelle est la différence entre le mode langage naturel et le mode booléen ?
Le mode langage naturel trouve les lignes contenant l'un des mots et les trie par pertinence. Le mode booléen comprend des opérateurs : + pour un mot obligatoire, - pour exclure un mot, * pour un préfixe et les guillemets pour une phrase.
Questions d'entretien
En quoi un index full-text diffère-t-il d'un index B-tree ?
Un index B-tree stocke les valeurs entières d'une colonne dans l'ordre et sert aux recherches par égalité, par plage et par préfixe. Un index full-text stocke les mots isolés avec les lignes qui les contiennent et sert aux recherches de mots et de phrases n'importe où dans le texte, avec un classement par pertinence.
Comment accéléreriez-vous une recherche avec LIKE '%mot-clé%' sur une grande table ?
En ajoutant un index full-text sur les colonnes recherchées et en réécrivant la requête avec MATCH … AGAINST dans MySQL, ou avec une colonne tsvector, un index GIN et @@ dans PostgreSQL. Il faut vérifier que les mots cherchés ne sont pas plus courts que la longueur minimale et ne sont pas des mots vides.
Pourquoi une recherche full-text peut-elle renvoyer moins de lignes que LIKE ?
La recherche full-text trouve des mots entiers, tandis que LIKE trouve des sous-chaînes : « cat » avec LIKE trouve aussi « category ». Les mots courts, les mots vides et, dans MySQL, les autres formes de mots ne sont pas trouvés du tout par l'index full-text.