Leçon 1.5 · Temps de lecture : ~7 min
En plus des nombres, du texte et des dates, les bases de données ont des types de données complexes pour les valeurs qui ont une structure interne : documents, listes, fichiers, identifiants uniques, positions et vecteurs pour la recherche par IA. Cette leçon est un tour rapide : ce que stocke chaque type, un exemple de valeur et les bases qui le prennent en charge. Inutile de retenir la syntaxe : le but est de reconnaître ces types quand vous les rencontrez dans une table.
Types de données complexes en SQL
Dans la leçon précédente, chaque colonne contenait une valeur simple : un nombre, une chaîne ou une date. Certaines données s'y prêtent mal : l'ensemble des attributs d'un produit, un contrat scanné, un point sur une carte. Pour ces données, les bases proposent des types spéciaux.
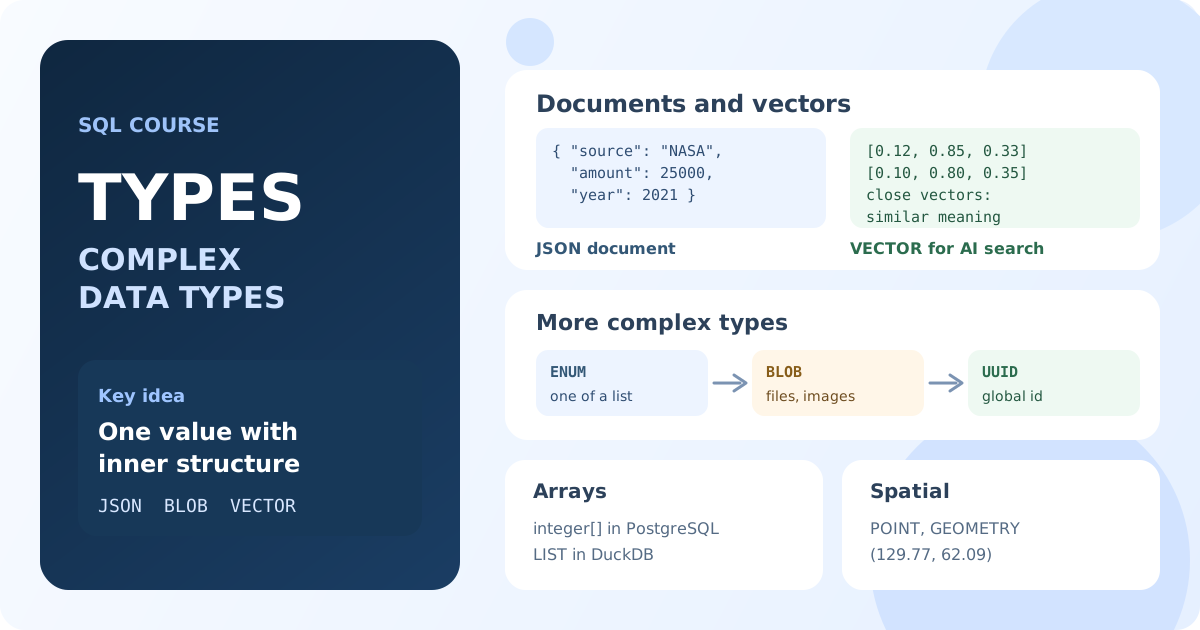
JSON : des documents
Une colonne JSON stocke un document entier avec des clés, des valeurs, des objets imbriqués et des listes. Dans la base University, un projet de recherche garde ses financements dans une seule colonne JSON :
[{ "source": "Private Foundation", "amount": 244542.96, "year": 2020}]
- MySQL et MariaDB ont le type
JSON; PostgreSQL ajsonet le binaire, plus rapide,jsonb; SQL Server et SQLite stockent le JSON sous forme de texte et le lisent avec des fonctions JSON. - Le JSON convient aux attributs qui varient d'une ligne à l'autre ou qui arrivent d'un autre système sous forme de document.
XML est le format de document plus ancien, avec le même but ; PostgreSQL et SQL Server ont un type xml pour lui.
Tableaux et structures imbriquées
Un tableau est une liste de valeurs dans une cellule, comme [1, 2, 3]. PostgreSQL prend en charge les tableaux de n'importe quel type (integer[], text[]), et les bases analytiques comme DuckDB ajoutent LIST, STRUCT et MAP. MySQL, MariaDB, SQL Server et SQLite n'ont pas de type tableau : une liste va dans du JSON ou, plus souvent, dans une table séparée, avec une ligne par élément.
ENUM et SET : une liste fixe de valeurs
ENUM autorise exactement une valeur parmi une liste déclarée avec la colonne. Dans Sakila, film.rating est ENUM('G', 'PG', 'PG-13', 'R', 'NC-17') : un film ne peut donc pas recevoir une classification hors de cette liste. SET, un type de MySQL et MariaDB, autorise n'importe quelle combinaison des valeurs listées : film.special_features contient des valeurs comme Trailers,Deleted Scenes.
PostgreSQL crée les types enum à part (CREATE TYPE ... AS ENUM) ; les autres bases utilisent une colonne ordinaire avec une vérification ou une table de référence.
BLOB : les données binaires
BLOB (Binary Large Object) stocke des octets : images, fichiers PDF, archives. Dans Sakila, staff.picture est un MEDIUMBLOB contenant la photo d'un employé. Le type s'appelle BLOB dans MySQL, MariaDB et SQLite, bytea dans PostgreSQL et VARBINARY(MAX) dans SQL Server.
Les gros fichiers alourdissent les sauvegardes et ralentissent la copie de la base : les applications gardent donc souvent les fichiers dans un stockage de fichiers et n'enregistrent que le chemin ou l'URL dans une colonne texte.
UUID : des identifiants uniques
Un UUID est un identifiant de 128 bits comme a1c7abde-ccc7-11f1-92da-da8de233f452, unique entre les tables, les serveurs et les systèmes. On l'utilise quand des lignes sont créées à plusieurs endroits en même temps et qu'un simple compteur ne peut pas être partagé. PostgreSQL et MariaDB ont un type uuid, SQL Server l'appelle UNIQUEIDENTIFIER, MySQL stocke les UUID dans CHAR(36) ou BINARY(16).
Types spatiaux : points et formes
Les types spatiaux stockent de la géométrie : points, lignes et polygones. Dans la base Bookings, chaque aéroport a des coordinates de type point, comme (129.77, 62.09) pour Iakoutsk. MySQL et MariaDB ont GEOMETRY et POINT, SQL Server a geometry et geography, et PostgreSQL obtient une prise en charge complète avec l'extension PostGIS. Les fonctions spatiales mesurent des distances, trouvent ce qui se trouve dans une zone ou les objets les plus proches.
VECTOR : des embeddings pour la recherche par IA
Un VECTOR est une liste de nombres de longueur fixe, par exemple [0.1, 0.2, 0.3]. Les modèles d'IA transforment des textes, des images et des produits en ces vecteurs (embeddings), de sorte que des choses similaires obtiennent des vecteurs proches. La base peut alors trouver les lignes dont les vecteurs sont les plus proches d'un vecteur de requête : « les documents semblables à cette question ». C'est la base de la recherche sémantique et des applications RAG.
- MariaDB a
VECTOR(n)depuis la version 11.7, avec des fonctions commeVEC_DISTANCE_COSINE. - MySQL a ajouté
VECTORdans la version 9, SQL Server dans la version 2025. - PostgreSQL obtient les vecteurs avec l'extension pgvector.
Les types complexes selon la base de données
| Données | MySQL | MariaDB | PostgreSQL | SQL Server | SQLite |
|---|---|---|---|---|---|
| Document | JSON | JSON | json, jsonb, xml | texte, xml | texte |
| Liste | — | — | tableaux (integer[]) | — | — |
| Liste fixe de valeurs | ENUM, SET | ENUM, SET | CREATE TYPE ... AS ENUM | — | — |
| Données binaires | BLOB | BLOB | bytea | VARBINARY(MAX) | BLOB |
| Identifiant unique | CHAR(36), BINARY(16) | UUID | uuid | UNIQUEIDENTIFIER | texte |
| Position | GEOMETRY, POINT | GEOMETRY, POINT | point, PostGIS | geometry, geography | — |
| Vecteur | VECTOR (9.0+) | VECTOR (11.7+) | pgvector | VECTOR (2025) | — |
Quand utiliser un type complexe
Un type complexe est un bon choix quand la valeur est utilisée en entier ou demande une recherche spéciale : un document stocké et renvoyé tel quel, une photo, un embedding pour la recherche de similarité. Si vous filtrez, joignez ou comptez souvent sur une partie de la valeur — une clé dans le JSON, un élément d'un tableau —, cette partie mérite en général sa propre colonne ou table. Les requêtes restent ainsi simples et la base peut utiliser des index ordinaires.
Points clés :
- Les types complexes stockent des valeurs à structure interne : documents, listes, fichiers, identifiants, positions et vecteurs.
JSONstocke des documents ; PostgreSQL a aussijsonb, les tableaux etxml.ENUMetSETlimitent une colonne à une liste de valeurs déclarée.BLOB,byteaetVARBINARYstockent des fichiers binaires ; les gros fichiers sont souvent gardés hors de la base.UUIDdonne des identifiants uniques entre systèmes ; les types spatiaux stockent des points et des formes.VECTORstocke des embeddings d'IA pour la recherche de similarité ; la prise en charge dépend de la base et de sa version.
Questions fréquentes
Faut-il stocker les images dans une colonne BLOB ?
Les petites images, oui, mais les gros fichiers gonflent la base et ralentissent les sauvegardes. L'approche courante consiste à garder les fichiers dans un stockage de fichiers et à enregistrer leur chemin dans la base.
Vaut-il mieux utiliser du JSON ou des colonnes séparées ?
Utilisez des colonnes séparées pour les données que chaque ligne possède et sur lesquelles vous filtrez ou faites des jointures. Utilisez le JSON pour les attributs qui varient d'une ligne à l'autre ou arrivent sous forme de document tout prêt.
Qu'est-ce qu'un vecteur dans une base de données ?
Une liste de nombres de longueur fixe qui représente le sens d'un texte, d'une image ou d'un autre objet. Les objets similaires ont des vecteurs proches : la base peut donc trouver les plus proches d'une requête.
Questions d'entretien
Quels types de données complexes connaissez-vous, et quand les utiliseriez-vous ?
JSON pour les documents semi-structurés, les tableaux pour les listes dans PostgreSQL, ENUM pour un ensemble fixe de valeurs, BLOB pour les fichiers binaires, UUID pour des identifiants uniques globaux, les types spatiaux pour les positions et VECTOR pour les embeddings dans la recherche de similarité. Chacun sert quand la valeur est manipulée en entier ou demande ses opérations particulières.
Quels sont les inconvénients de stocker des données en JSON plutôt qu'en colonnes ?
Les valeurs dans le JSON sont plus difficiles à valider, à contraindre, à joindre et à indexer ; les requêtes s'allongent, et les erreurs de type n'apparaissent qu'à la lecture des données.
Pourquoi les bases vectorielles comptent-elles pour les applications d'IA ?
Les modèles d'IA représentent les textes et les images sous forme d'embeddings. Une base avec un type vectoriel et une recherche des plus proches voisins trouve rapidement les éléments les plus semblables, ce qui est au cœur de la recherche sémantique et de la génération augmentée par la recherche (RAG).