Lição 9.6 · Tempo de leitura: ~10 min
A normalização de banco de dados é uma forma de projetar tabelas para que cada fato fique guardado em um único lugar. Um banco normalizado divide os dados em tabelas relacionadas, ligadas por chaves, o que elimina duplicatas e os erros que elas causam. Nesta lição você vai conhecer as três primeiras formas normais (1FN, 2FN, 3FN) e a FNBC, ver como dividir uma tabela larga com SQL e entender quando duplicar dados de propósito é a melhor escolha.
Normalização de Banco de Dados: 1FN, 2FN e 3FN
Nas lições anteriores deste módulo você criou tabelas, alterou-as e construiu views sobre elas. Falta responder qual conjunto de tabelas criar desde o início: o que fica em uma tabela e o que merece uma tabela própria.
A normalização responde a essa pergunta com algumas regras formais chamadas formas normais. O Sakila é um banco bem normalizado, por isso suas tabelas servem de exemplo ao longo da lição.
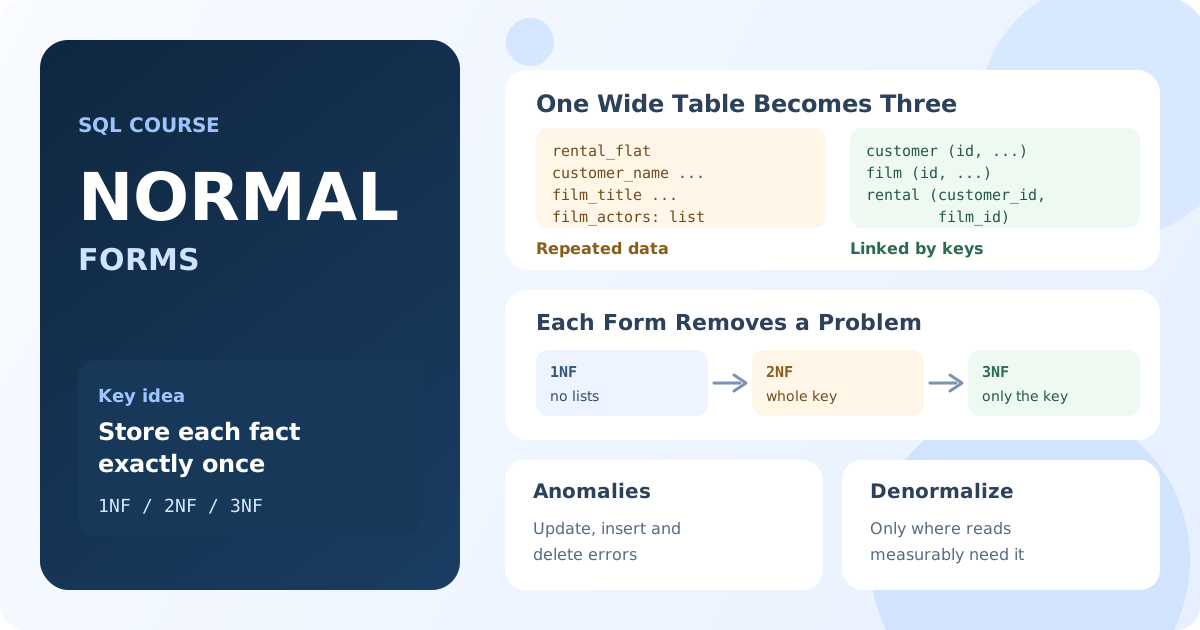
O Que É Normalização de Banco de Dados?
Normalização é o processo de organizar colunas e tabelas de modo que:
- cada tabela descreva um único tipo de entidade: um cliente, um filme, um aluguel;
- cada fato seja guardado uma vez, e as outras tabelas se refiram a ele por uma chave;
- cada coluna não chave dependa da chave da sua tabela, e só dela.
As regras são agrupadas em formas normais: 1FN, 2FN, 3FN, FNBC (forma normal de Boyce-Codd) e superiores. Cada forma inclui a anterior. Na prática, um esquema na terceira forma normal (3FN) é considerado normalizado; as formas superiores tratam de casos raros.
Por Que Normalizar: Anomalias de Dados
Imagine que os aluguéis fiquem guardados em uma única tabela larga:
| rental_id | rental_date | customer_email | customer_name | customer_city | film_title | film_actors |
|---|---|---|---|---|---|---|
| 1 | 2026-05-01 | mary@example.org | MARY SMITH | Sasebo | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
| 2 | 2026-05-02 | mary@example.org | MARY SMITH | Sasebo | ACE GOLDFINGER | BOB FAWCETT, MINNIE ZELLWEGER |
| 3 | 2026-05-02 | patricia@example.org | PATRICIA JOHNSON | San Bernardino | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
A tabela é fácil de ler, mas os dados do cliente e do filme se repetem em cada aluguel. Isso causa três tipos de problemas, chamados anomalias:
- Anomalia de atualização. Mary se muda para outra cidade. É preciso atualizar todos os aluguéis dela; se uma linha ficar de fora, o banco terá duas cidades diferentes para o mesmo cliente.
- Anomalia de inserção. Não dá para cadastrar um filme novo até que alguém o alugue, porque cada linha é um aluguel.
- Anomalia de exclusão. Apagar o único aluguel de Patricia apaga também tudo o que se sabe sobre ela.
A normalização elimina essas anomalias levando cada fato para a tabela à qual ele pertence.
Primeira Forma Normal (1FN)
Uma tabela está na primeira forma normal quando:
- cada coluna guarda um único valor (atômico), e não uma lista;
- não há grupos de colunas repetidas como
phone1,phone2,phone3; - cada linha pode ser identificada por uma chave primária.
A coluna film_actors acima viola a 1FN: ela guarda uma lista de nomes em um único valor. Uma coluna assim é difícil de consultar. Para achar os filmes com Penelope Guiness, é preciso buscar dentro do texto com LIKE, o que não usa índice e encontra nomes parecidos por engano. Contar filmes por ator é ainda mais difícil.
O Sakila tem um exemplo real desse compromisso. No MySQL, a coluna film.special_features é do tipo SET e guarda valores como Trailers,Commentaries:
SELECT special_features, COUNT(*) AS films
FROM film
GROUP BY special_features
ORDER BY films DESC
LIMIT 3;
Resultado: 15 combinações de quatro recursos, começando por Trailers,Commentaries,Behind the Scenes (79 filmes). Para contar filmes por recurso, é preciso quebrar essas strings.
A solução da 1FN é uma tabela separada, com uma linha por valor. É exatamente o que o Sakila faz com os atores: a tabela film_actor guarda um par (actor_id, film_id) por linha.
SELECT a.first_name, a.last_name, COUNT(*) AS films
FROM film_actor AS fa
JOIN actor AS a ON a.actor_id = fa.actor_id
GROUP BY a.actor_id, a.first_name, a.last_name
ORDER BY films DESC
LIMIT 3;
Resultado: os atores com mais filmes; GINA DEGENERES lidera com 42. Com uma lista em uma coluna de texto, essa consulta seria pouco prática.
Segunda Forma Normal (2FN)
Uma tabela está na segunda forma normal quando está na 1FN e cada coluna não chave depende da chave primária inteira, e não de parte dela.
A 2FN só importa para tabelas com chave composta de várias colunas. Suponha que film_actor também guardasse nomes:
| actor_id | film_id | actor_name | film_title |
|---|---|---|---|
| 1 | 1 | PENELOPE GUINESS | ACADEMY DINOSAUR |
| 1 | 23 | PENELOPE GUINESS | ANACONDA CONFESSIONS |
A chave é (actor_id, film_id), mas actor_name depende só de actor_id, e film_title só de film_id. Isso é uma dependência parcial: o nome do ator se repete para cada um dos seus filmes.
A correção é mover cada coluna para a tabela de cuja chave ela depende: os nomes para actor, os títulos para film. A film_actor real guarda apenas as duas chaves e last_update.
Terceira Forma Normal (3FN)
Uma tabela está na terceira forma normal quando está na 2FN e nenhuma coluna não chave depende de outra coluna não chave. Uma cadeia assim, chave → coluna A → coluna B, se chama dependência transitiva.
Por exemplo, se a tabela address guardasse o país:
| address_id | address | city_id | city | country |
|---|---|---|---|---|
| 5 | 1913 Hanoi Way | 463 | Sasebo | Japan |
| 6 | 1121 Loja Avenue | 449 | San Bernardino | United States |
city e country dependem de city_id, e não de address_id. Todo endereço da mesma cidade repete o nome da cidade e o país, e renomear um país exigiria atualizar milhares de endereços.
O Sakila resolve isso com uma cadeia de tabelas: address guarda city_id, city guarda country_id, e só country guarda o nome. Cada nome é guardado uma vez, e a consulta os reúne com JOIN:
SELECT co.country, COUNT(*) AS customers
FROM customer AS c
JOIN address AS a ON a.address_id = c.address_id
JOIN city AS ci ON ci.city_id = a.city_id
JOIN country AS co ON co.country_id = ci.country_id
GROUP BY co.country
ORDER BY customers DESC
LIMIT 5;
Resultado: India (60), China (53), United States (36), Japan (31) e Mexico (30). Dados normalizados são lidos com joins; esse é o preço de guardar cada fato uma única vez.
Um jeito curto de lembrar da 1FN à 3FN: cada coluna não chave deve depender da chave, da chave inteira e de nada além da chave.
Forma Normal de Boyce-Codd (FNBC)
A FNBC (BCNF) é uma versão mais rígida da 3FN: toda coluna que determina outra coluna deve ser uma chave candidata. A diferença só aparece em tabelas com várias chaves candidatas sobrepostas, o que é raro. A maioria das tabelas na 3FN já está na FNBC. A quarta e a quinta formas normais tratam de dependências multivaloradas e raramente são discutidas fora da teoria de bancos de dados.
Como Normalizar uma Tabela com SQL
Vamos dividir a tabela larga do início, guardada como rental_flat, em tabelas normalizadas. Execute estes comandos no seu próprio banco: os bancos de exemplo do SQLtest são somente leitura. Primeiro, a nova estrutura:
CREATE TABLE customer_n (
    customer_id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(50) NOT NULL UNIQUE,
    name VARCHAR(90) NOT NULL,
    city VARCHAR(50) NOT NULL
);

CREATE TABLE film_n (
    film_id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL UNIQUE
);

CREATE TABLE rental_n (
    rental_id INT PRIMARY KEY,
    rental_date DATE NOT NULL,
    customer_id INT NOT NULL,
    film_id INT NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customer_n (customer_id),
    FOREIGN KEY (film_id) REFERENCES film_n (film_id)
);
Observação: esta é a sintaxe do MySQL. No PostgreSQL, troque INT AUTO_INCREMENT por INT GENERATED ALWAYS AS IDENTITY.
Depois, copiamos os dados. SELECT DISTINCT deixa uma linha por cliente e por filme, e os aluguéis encontram suas chaves com JOIN:
INSERT INTO customer_n (email, name, city)
SELECT DISTINCT customer_email, customer_name, customer_city
FROM rental_flat;

INSERT INTO film_n (title)
SELECT DISTINCT film_title
FROM rental_flat;

INSERT INTO rental_n (rental_id, rental_date, customer_id, film_id)
SELECT r.rental_id, r.rental_date, c.customer_id, f.film_id
FROM rental_flat AS r
JOIN customer_n AS c ON c.email = r.customer_email
JOIN film_n AS f ON f.title = r.film_title;
Resultado: 2 clientes, 2 filmes e 3 aluguéis. A cidade de Mary agora fica em uma única linha, e um só UPDATE a altera em todos os lugares.
Se SELECT DISTINCT retornar duas linhas com o mesmo e-mail, os dados já estão inconsistentes: o mesmo cliente tem nomes ou cidades diferentes em aluguéis diferentes. A restrição UNIQUE em email vai rejeitar a segunda linha, e você terá de decidir qual valor está correto. A normalização costuma revelar problemas desse tipo.
A lista de atores vai do mesmo jeito para um par de tabelas, actor e film_actor. A cidade seguiria o exemplo da 3FN: uma tabela city separada e uma coluna city_id em customer_n.
Desnormalização: Quando Duplicatas São Aceitáveis
Desnormalização é guardar dados redundantes de propósito para tornar a leitura mais rápida ou mais simples. É um compromisso consciente, não um erro de modelagem, e o próprio Sakila tem alguns exemplos:
paymentguardacustomer_id, embora ele possa ser obtido viarental_id. A duplicata economiza um join nos relatórios de pagamentos; os dois valores coincidem em todos os 16.044 pagamentos ligados a um aluguel.- A tabela
film_textrepetetitleedescriptiondefilmpara a busca de texto completo. - A view
film_listdevolve os atores como uma única string separada por vírgulas. Uma view não guarda nada, então oferece um formato largo conveniente sem as anomalias.
Motivos comuns para desnormalizar:
- relatórios e dashboards que juntam muitas tabelas grandes a cada requisição;
- contadores e totais, como o valor total de pagamentos de um cliente, caros de recalcular;
- data warehouses com esquema estrela, carregados em lotes e raramente atualizados.
A regra prática: projete primeiro um esquema normalizado e depois desnormalize pontos específicos onde você mediu um problema de desempenho. Toda duplicata precisa de uma forma de se manter sincronizada: um trigger, uma tarefa agendada ou o código da aplicação.
Principais Conclusões:
- A normalização guarda cada fato uma vez e liga as tabelas por chaves; ela evita anomalias de atualização, inserção e exclusão.
- 1FN: um valor por coluna, sem listas nem grupos de colunas repetidas, uma chave primária em cada tabela.
- 2FN: nenhuma coluna depende de parte de uma chave composta.
- 3FN: nenhuma coluna depende de outra coluna não chave; "a chave, a chave inteira e nada além da chave".
- Dados normalizados são lidos com
JOIN; uma view pode apresentá-los em formato largo. - Desnormalize de forma deliberada e só onde a leitura exige, com um plano para manter as cópias sincronizadas.
Esta lição encerra o módulo sobre criação e alteração de tabelas. O próximo módulo trata de escrever SQL legível e rápido: boas práticas, otimização de consultas e índices.
Perguntas Frequentes
O que é normalização de banco de dados?
Normalização é o processo de organizar os dados em tabelas relacionadas para que cada fato seja guardado apenas uma vez. Ela remove dados duplicados e as anomalias que eles causam, como um mesmo cliente com dois endereços diferentes em linhas diferentes.
Qual é a diferença entre 1FN, 2FN e 3FN?
A 1FN exige valores atômicos e uma chave primária. A 2FN proíbe, além disso, colunas que dependem só de parte de uma chave composta. A 3FN proíbe, além disso, colunas que dependem de outras colunas não chave, como o nome de um país guardado ao lado do ID de uma cidade.
Um banco normalizado é sempre melhor?
Para dados que mudam, geralmente sim: ele mantém os dados consistentes e o esquema flexível. Para relatórios e análises, uma desnormalização controlada pode tornar as leituras bem mais rápidas. Comece normalizado e desnormalize onde houver uma necessidade medida.
A normalização deixa as consultas mais lentas?
As leituras exigem mais joins, o que custa algum tempo, mas com índices nas colunas-chave os joins são rápidos. As escritas costumam ser mais rápidas, porque cada alteração atualiza uma linha em vez de muitas cópias.
Perguntas de Entrevista
Explique as anomalias de atualização, inserção e exclusão.
Uma anomalia de atualização ocorre quando um fato é guardado em várias linhas e uma atualização deixa algumas de fora. Uma anomalia de inserção ocorre quando não é possível adicionar um fato sem dados não relacionados, como um filme sem aluguel. Uma anomalia de exclusão ocorre quando apagar um fato apaga outro, como o único aluguel de um cliente removendo o próprio cliente.
O que é uma dependência transitiva? Dê um exemplo.
É quando uma coluna não chave depende de outra coluna não chave em vez da chave. Em address(address_id, city_id, city_name), city_name depende de city_id, e não de address_id. A solução é uma tabela city separada, o que leva o esquema à 3FN.
Quando você desnormalizaria um esquema?
Quando as leituras são muito mais frequentes que as escritas e os joins viraram um gargalo medido, por exemplo em relatórios, dashboards e data warehouses. Guarde os dados redundantes com uma forma clara de sincronizá-los, como um trigger ou uma atualização agendada.