Lição 10.6 · Tempo de leitura: ~10 min
Um índice full-text (índice de texto completo) é um índice das palavras em colunas de texto: para cada palavra, ele guarda as linhas que a contêm. Ele permite encontrar linhas por palavras e ordená-las por relevância, algo que LIKE '%palavra%' só consegue lendo a tabela inteira. Nesta lição você vai criar um índice full-text no MySQL, buscar com MATCH … AGAINST nos modos de linguagem natural e booleano, conhecer as regras que tornam algumas palavras impossíveis de encontrar e ver como o PostgreSQL resolve a mesma tarefa.
Índices Full-Text em SQL
Nas lições anteriores você viu como os índices B-tree aceleram a busca por um valor ou pelo início de um valor. Buscar uma palavra no meio de um texto é diferente: WHERE description LIKE '%astronaut%' não consegue usar um índice B-tree, porque a palavra pode começar em qualquer ponto da string.
É exatamente para isso que existem os índices full-text. Os exemplos de MySQL rodam na tabela film_text do Sakila, que já tem um índice full-text; a parte de PostgreSQL foi verificada no PostgreSQL 17.
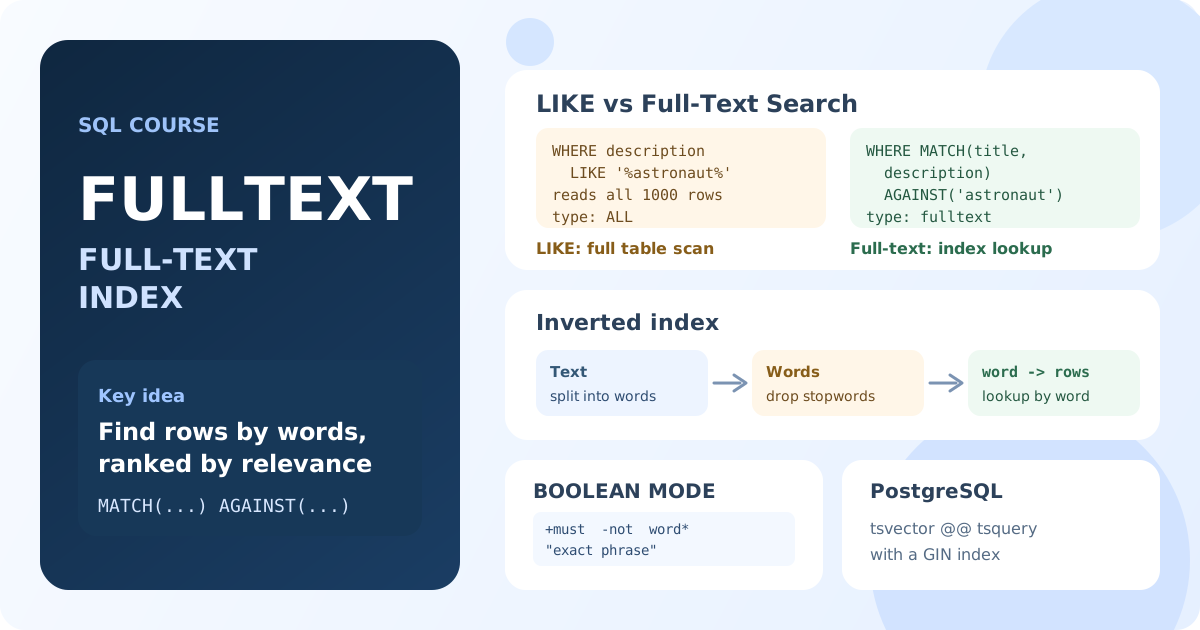
O Que É um Índice Full-Text?
Ao criar um índice full-text, o banco divide o texto em palavras (tokens), descarta palavras curtas demais e palavras muito comuns como "the" ou "and" (stopwords) e monta um índice invertido: uma lista de palavras, cada uma com as linhas que a contêm.
| Índice B-tree | Índice full-text | |
|---|---|---|
| Indexa | valores inteiros da coluna | palavras individuais |
| Buscas rápidas | =, intervalos, LIKE 'abc%' | palavras e frases em qualquer ponto do texto |
LIKE '%palavra%' | não é usado | também não é usado |
| Ordem do resultado | por valor | por relevância |
| Sintaxe no MySQL | WHERE col = … | WHERE MATCH(col) AGAINST(…) |
Um índice full-text só funciona com a sua própria sintaxe de busca: MATCH … AGAINST no MySQL, @@ no PostgreSQL. Um LIKE comum nunca o usa.
Criando um Índice Full-Text no MySQL
Um índice full-text é criado em colunas CHAR, VARCHAR ou TEXT:
CREATE FULLTEXT INDEX ft_film_description ON film (title, description);
O mesmo pode ser feito com ALTER TABLE film ADD FULLTEXT INDEX ft_film_description (title, description); ou dentro do CREATE TABLE. Os bancos de exemplo do SQLtest são somente leitura, então execute esses comandos no seu próprio banco.
O Sakila já tem um índice assim na tabela film_text:
SHOW INDEX FROM film_text;
Resultado: PRIMARY (tipo BTREE) em film_id, e idx_title_description (tipo FULLTEXT) nas colunas title e description.
Buscando com MATCH … AGAINST
MATCH lista as colunas indexadas, AGAINST as palavras a buscar:
SELECT film_id, title,
    ROUND(MATCH(title, description) AGAINST ('astronaut crocodile'), 3) AS score
FROM film_text
WHERE MATCH(title, description) AGAINST ('astronaut crocodile')
ORDER BY score DESC
LIMIT 5;
Resultado: PHANTOM GLORY (4.239), STONE FIRE (4.196), ROAD ROXANNE, NEIGHBORS CHARADE (4.153) e LOVELY JINGLE (3.146). Os filmes com as duas palavras vêm primeiro.
Esse é o modo de linguagem natural (natural language mode), o padrão. Uma linha corresponde se contém qualquer uma das palavras: aqui, 173 filmes contêm "astronaut" ou "crocodile". O mesmo MATCH … AGAINST no SELECT devolve a pontuação de relevância, e o resultado pode ser ordenado por ela.
A lista de colunas no MATCH precisa ser exatamente a lista de colunas de um índice full-text. MATCH(description) AGAINST ('astronaut') falha com "Can't find FULLTEXT index matching the column list", porque o índice cobre title e description juntos.
Modo Booleano
IN BOOLEAN MODE acrescenta operadores para buscas precisas:
| Operador | Significado | Exemplo | Filmes em film_text |
|---|---|---|---|
+ | a palavra é obrigatória | '+astronaut +crocodile' | 4 |
- | a palavra deve estar ausente | '+astronaut -crocodile' | 74 |
* | prefixo | 'dino*' | 3 |
" " | frase exata | '"mad scientist"' | 97 |
SELECT film_id, title
FROM film_text
WHERE MATCH(title, description) AGAINST ('+astronaut +crocodile' IN BOOLEAN MODE);
Resultado: 4 filmes cujo título ou descrição contém as duas palavras.
Sem operadores, o modo booleano também encontra linhas com qualquer uma das palavras, mas não as ordena por relevância.
Busca Full-Text e LIKE
Compare os planos das duas buscas:
EXPLAIN SELECT film_id FROM film_text WHERE MATCH(title, description) AGAINST ('astronaut');

EXPLAIN SELECT film_id FROM film_text WHERE description LIKE '%astronaut%';
Resultado: a primeira consulta usa o índice idx_title_description (tipo de acesso fulltext); a segunda lê todas as 1000 linhas (tipo ALL).
As duas buscas também encontram coisas diferentes:
LIKE '%cat%'encontra qualquer substring: "cat", mas também "category" e "Catherine". Um índice full-text encontra palavras inteiras.LIKEverifica um padrão em uma coluna; a busca full-text procura várias palavras em várias colunas e ordena o resultado.- Em uma tabela com milhões de linhas,
LIKE '%palavra%'lê cada linha, enquanto o índice full-text lê só a lista da palavra.
Regras Que Surpreendem Iniciantes
Algumas palavras simplesmente não são encontradas, e isso não é um bug:
- Tamanho mínimo da palavra. Palavras menores não são indexadas: 3 caracteres no InnoDB (
innodb_ft_min_token_size), 4 no MyISAM (ft_min_word_len).film_texté uma tabela MyISAM, entãoAGAINST ('cat')não encontra nada nela, enquanto uma tabela InnoDB encontra "cat". - Stopwords. Palavras comuns como "the", "a", "and" são ignoradas:
AGAINST ('the')devolve 0 linhas. - Sem formas de palavras no MySQL. O índice guarda as palavras como estão: "running" não encontra "run". Para terminações diferentes, use um prefixo no modo booleano:
'run*'. - A regra dos 50%. No modo de linguagem natural do MyISAM, uma palavra presente em mais da metade das linhas é considerada comum demais e ignorada.
O tamanho mínimo e a lista de stopwords são configurações do servidor, e depois de alterá-las é preciso reconstruir o índice.
Busca Full-Text no PostgreSQL
O PostgreSQL não tem a palavra-chave FULLTEXT. O texto é convertido em tsvector (uma lista de palavras normalizadas), a consulta em tsquery, e o operador @@ verifica se combinam:
SELECT to_tsvector('english', 'Runners should run slowly at first');
Resultado: 'first':6 'run':3 'runner':1 'slowli':4. As palavras são reduzidas aos radicais, e "should" e "at" são descartadas como stopwords.
Graças aos radicais, buscar "run" também encontra "running", e "cats" encontra "cat", o que o MySQL não faz. Para ter velocidade, guarde o tsvector em uma coluna gerada e indexe-o com GIN, o tipo de índice do PostgreSQL para busca full-text:
ALTER TABLE film
ADD COLUMN search tsvector
    GENERATED ALWAYS AS (to_tsvector('english', title || ' ' || description)) STORED;

CREATE INDEX film_search_idx ON film USING GIN (search);

SELECT title, ts_rank(search, query) AS rank
FROM film, websearch_to_tsquery('english', 'astronaut -crocodile') AS query
WHERE search @@ query
ORDER BY rank DESC
LIMIT 5;
Observação: websearch_to_tsquery entende a sintaxe de buscadores: aspas para frases, or, e - para excluir uma palavra. ts_rank faz o papel da pontuação de relevância do MySQL.
Outros bancos têm suas próprias ferramentas: o SQL Server usa um catálogo full-text com CONTAINS e FREETEXT, o SQLite a extensão FTS5. Para buscar em milhões de documentos considerando erros de digitação e sinônimos, os projetos usam mecanismos dedicados, como o Elasticsearch.
Quando Usar um Índice Full-Text
Bons usos:
- busca por palavras em descrições, artigos, comentários, nomes de produtos;
- "caixas de busca" cujos resultados devem ser ordenados por relevância;
- tabelas grandes em que
LIKE '%palavra%'ficou lento.
Usos ruins:
- busca por valor exato ou pelo início de um valor: um índice B-tree faz isso melhor;
- códigos curtos e valores menores que o tamanho mínimo da palavra;
- busca de substrings arbitrárias dentro das palavras, como parte de um código de produto.
Principais Conclusões:
- Um índice full-text associa cada palavra às linhas que a contêm;
LIKE '%palavra%'não usa nem índice B-tree nem índice full-text. - No MySQL, ele é criado com
FULLTEXT INDEXe a busca é feita comMATCH(colunas) AGAINST('palavras'); as colunas devem coincidir exatamente com o índice. - O modo de linguagem natural devolve linhas com qualquer uma das palavras, ordenadas por relevância; o modo booleano acrescenta
+,-,*e frases. - Palavras curtas e stopwords não são indexadas, e o MySQL não considera formas de palavras: "running" não encontra "run".
- O PostgreSQL usa
tsvector,tsquery, o operador@@e um índice GIN, e considera as formas das palavras.
Perguntas Frequentes
O que é um índice full-text em SQL?
É um índice das palavras em colunas de texto: para cada palavra, o banco guarda as linhas que a contêm. Ele torna a busca por palavras rápida e permite ordenar os resultados por relevância.
Por que LIKE '%palavra%' não usa índice?
Um índice B-tree é ordenado pelo início do valor, e um padrão que começa com % pode corresponder em qualquer ponto da string, então o banco precisa ler cada linha. A busca full-text com MATCH … AGAINST ou @@ usa um índice full-text.
Por que minha busca full-text não encontra nada para uma palavra curta?
Palavras menores que o tamanho mínimo (3 caracteres no InnoDB, 4 no MyISAM) e stopwords como "the" não são indexadas. Use uma palavra mais longa, outro método de busca ou altere as configurações do servidor e reconstrua o índice.
Qual é a diferença entre o modo de linguagem natural e o modo booleano?
O modo de linguagem natural encontra linhas com qualquer uma das palavras e as ordena por relevância. O modo booleano entende operadores: + para palavra obrigatória, - para excluir uma palavra, * para prefixo e aspas para frase.
Perguntas de Entrevista
Como um índice full-text difere de um índice B-tree?
Um índice B-tree guarda os valores inteiros da coluna em ordem e atende buscas por igualdade, intervalo e prefixo. Um índice full-text guarda palavras individuais com as linhas que as contêm e atende buscas de palavras e frases em qualquer ponto do texto, com ordenação por relevância.
Como você aceleraria uma busca com LIKE '%palavra-chave%' em uma tabela grande?
Adicionaria um índice full-text nas colunas pesquisadas e reescreveria a consulta com MATCH … AGAINST no MySQL, ou com uma coluna tsvector, um índice GIN e @@ no PostgreSQL. Também verificaria se as palavras buscadas não são menores que o tamanho mínimo e não são stopwords.
Por que uma busca full-text pode devolver menos linhas que LIKE?
A busca full-text encontra palavras inteiras, enquanto LIKE encontra substrings, então "cat" com LIKE também encontra "category". Palavras curtas, stopwords e, no MySQL, outras formas das palavras não são encontradas pelo índice full-text.