Lição 1.5 · Tempo de leitura: ~7 min
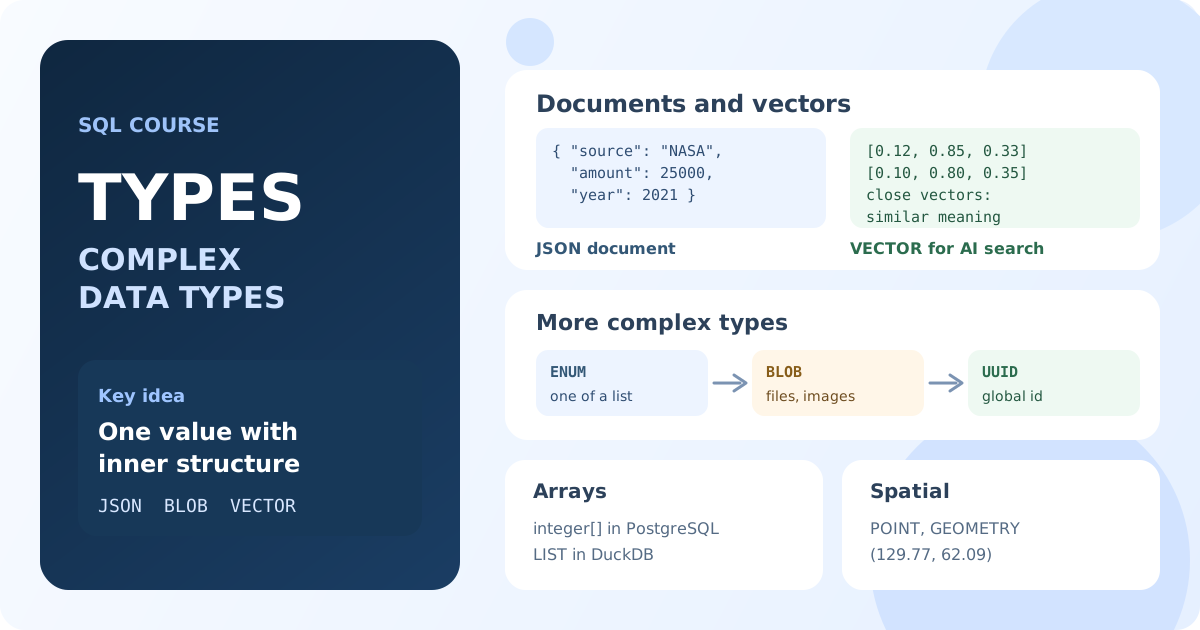
Além de números, texto e datas, os bancos de dados têm tipos de dados complexos para valores com estrutura interna: documentos, listas, arquivos, identificadores únicos, localizações e vetores para busca com IA. Esta lição é um passeio rápido: o que cada tipo guarda, um valor de exemplo e quais bancos o suportam. Não é preciso decorar a sintaxe — o objetivo é reconhecer esses tipos quando você encontrá-los numa tabela.
Tipos de dados complexos em SQL
Na lição anterior cada coluna guardava um valor simples: um número, uma string ou uma data. Alguns dados não cabem bem nisso: o conjunto de atributos de um produto, um contrato digitalizado, um ponto no mapa. Para esses dados os bancos oferecem tipos especiais.
JSON: documentos
Uma coluna JSON guarda um documento inteiro com chaves, valores, objetos aninhados e listas. No banco University, um projeto de pesquisa guarda seus financiamentos numa única coluna JSON:
[{ "source": "Private Foundation", "amount": 244542.96, "year": 2020}]
- MySQL e MariaDB têm o tipo
JSON; o PostgreSQL temjsone o binário, mais rápido,jsonb; SQL Server e SQLite guardam JSON como texto e o leem com funções JSON. - JSON serve para atributos que mudam de linha para linha ou que chegam de outro sistema como documento.
XML é o formato de documento mais antigo, com o mesmo propósito; PostgreSQL e SQL Server têm um tipo xml para ele.
Arrays e estruturas aninhadas
Um array é uma lista de valores numa célula, como [1, 2, 3]. O PostgreSQL suporta arrays de qualquer tipo (integer[], text[]), e bancos analíticos como o DuckDB acrescentam LIST, STRUCT e MAP. MySQL, MariaDB, SQL Server e SQLite não têm tipo array: uma lista vai para um JSON ou, com mais frequência, para uma tabela separada, com uma linha por item.
ENUM e SET: uma lista fixa de valores
ENUM permite exatamente um valor de uma lista declarada junto com a coluna. No Sakila, film.rating é ENUM('G', 'PG', 'PG-13', 'R', 'NC-17'), então um filme não pode receber uma classificação fora dessa lista. SET, um tipo do MySQL e do MariaDB, permite qualquer combinação dos valores listados: film.special_features guarda valores como Trailers,Deleted Scenes.
O PostgreSQL cria tipos enum separadamente (CREATE TYPE ... AS ENUM); outros bancos usam uma coluna comum com uma verificação ou uma tabela de referência.
BLOB: dados binários
BLOB (Binary Large Object) guarda bytes: imagens, arquivos PDF, arquivos compactados. No Sakila, staff.picture é um MEDIUMBLOB com a foto de um funcionário. O tipo se chama BLOB no MySQL, no MariaDB e no SQLite, bytea no PostgreSQL e VARBINARY(MAX) no SQL Server.
Arquivos grandes deixam o banco pesado para backup e lento para copiar, por isso as aplicações costumam manter os arquivos num armazenamento de arquivos e salvar no banco apenas o caminho ou a URL numa coluna de texto.
UUID: identificadores únicos
Um UUID é um identificador de 128 bits como a1c7abde-ccc7-11f1-92da-da8de233f452, único entre tabelas, servidores e sistemas. É usado quando linhas são criadas em muitos lugares ao mesmo tempo e um contador simples não pode ser compartilhado. PostgreSQL e MariaDB têm o tipo uuid, o SQL Server o chama de UNIQUEIDENTIFIER, o MySQL guarda UUIDs em CHAR(36) ou BINARY(16).
Tipos espaciais: pontos e formas
Os tipos espaciais guardam geometria: pontos, linhas e polígonos. No banco Bookings cada aeroporto tem coordinates do tipo point, como (129.77, 62.09) para Yakutsk. MySQL e MariaDB têm GEOMETRY e POINT, o SQL Server tem geometry e geography, e o PostgreSQL ganha suporte completo com a extensão PostGIS. As funções espaciais medem distâncias, encontram o que está dentro de uma área ou quais objetos estão mais próximos.
VECTOR: embeddings para busca com IA
Um VECTOR é uma lista de números de tamanho fixo, por exemplo [0.1, 0.2, 0.3]. Modelos de IA transformam textos, imagens e produtos nesses vetores (embeddings), de modo que coisas parecidas recebem vetores próximos. O banco pode então encontrar as linhas cujos vetores estão mais perto de um vetor de consulta: "documentos parecidos com esta pergunta". Essa é a base da busca semântica e das aplicações RAG.
- O MariaDB tem
VECTOR(n)desde a versão 11.7, com funções comoVEC_DISTANCE_COSINE. - O MySQL adicionou
VECTORna versão 9, o SQL Server na versão 2025. - O PostgreSQL ganha vetores com a extensão pgvector.
Tipos complexos em diferentes bancos de dados
| Dados | MySQL | MariaDB | PostgreSQL | SQL Server | SQLite |
|---|---|---|---|---|---|
| Documento | JSON | JSON | json, jsonb, xml | texto, xml | texto |
| Lista | — | — | arrays (integer[]) | — | — |
| Lista fixa de valores | ENUM, SET | ENUM, SET | CREATE TYPE ... AS ENUM | — | — |
| Dados binários | BLOB | BLOB | bytea | VARBINARY(MAX) | BLOB |
| Identificador único | CHAR(36), BINARY(16) | UUID | uuid | UNIQUEIDENTIFIER | texto |
| Localização | GEOMETRY, POINT | GEOMETRY, POINT | point, PostGIS | geometry, geography | — |
| Vetor | VECTOR (9.0+) | VECTOR (11.7+) | pgvector | VECTOR (2025) | — |
Quando usar um tipo complexo
Um tipo complexo é uma boa escolha quando o valor é usado inteiro ou precisa de uma busca especial: um documento guardado e devolvido como está, uma foto, um embedding para busca por similaridade. Se você filtra, junta ou conta com frequência por uma parte do valor — uma chave dentro do JSON, um item de um array —, essa parte geralmente merece uma coluna ou tabela própria. Assim as consultas continuam simples e o banco pode usar índices comuns.
Principais conclusões:
- Tipos complexos guardam valores com estrutura interna: documentos, listas, arquivos, identificadores, localizações e vetores.
JSONguarda documentos; o PostgreSQL também temjsonb, arrays exml.ENUMeSETlimitam uma coluna a uma lista declarada de valores.BLOB,byteaeVARBINARYguardam arquivos binários; arquivos grandes costumam ficar fora do banco.UUIDdá identificadores únicos entre sistemas; os tipos espaciais guardam pontos e formas.VECTORguarda embeddings de IA para busca por similaridade; o suporte depende do banco e da sua versão.
Perguntas frequentes
Devo guardar imagens numa coluna BLOB?
Imagens pequenas tudo bem, mas arquivos grandes deixam o banco grande e os backups lentos. Uma abordagem comum é manter os arquivos num armazenamento de arquivos e salvar o caminho deles no banco.
É melhor usar JSON ou colunas separadas?
Use colunas separadas para dados que toda linha tem e pelos quais você filtra ou junta. Use JSON para atributos que mudam entre as linhas ou chegam como um documento pronto.
O que é um vetor num banco de dados?
Uma lista de números de tamanho fixo que representa o significado de um texto, imagem ou outro objeto. Objetos parecidos têm vetores próximos, então o banco consegue encontrar os mais próximos de uma consulta.
Perguntas de entrevista
Que tipos de dados complexos você conhece e quando os usaria?
JSON para documentos semiestruturados, arrays para listas no PostgreSQL, ENUM para um conjunto fixo de valores, BLOB para arquivos binários, UUID para identificadores globalmente únicos, tipos espaciais para localizações e VECTOR para embeddings em busca por similaridade. Cada um é usado quando o valor é tratado inteiro ou precisa das suas operações especiais.
Quais as desvantagens de guardar dados em JSON em vez de colunas?
Valores dentro do JSON são mais difíceis de validar, restringir, juntar e indexar; as consultas ficam mais longas, e erros de tipo só aparecem quando os dados são lidos.
Por que bancos de dados vetoriais importam para aplicações de IA?
Modelos de IA representam textos e imagens como embeddings. Um banco com tipo vetorial e busca de vizinhos mais próximos encontra rapidamente os itens mais parecidos, que é o núcleo da busca semântica e da geração aumentada por recuperação (RAG).