Условная агрегация в SQL с помощью CASE
Урок 4.4 · Время чтения: ~8 мин · Задачи для практики ↓
Условная агрегация вычисляет несколько метрик одним SQL-запросом: внутрь агрегатной функции помещается выражение CASE - SUM(CASE WHEN ... THEN ... END). В этом уроке вы изучите условные суммы, подсчёты и средние, ошибки с ELSE, которые дают неверные числа, и научитесь превращать строки в столбцы (pivot).
С GROUP BY вы получаете одно значение на группу: количество платежей, общую сумму. Отчётам обычно нужно больше: для каждого сотрудника - сколько платежей были маленькими, средними и крупными и сколько принёс каждый диапазон. Без условной агрегации пришлось бы выполнить три запроса с разными фильтрами WHERE и вручную объединить результаты.
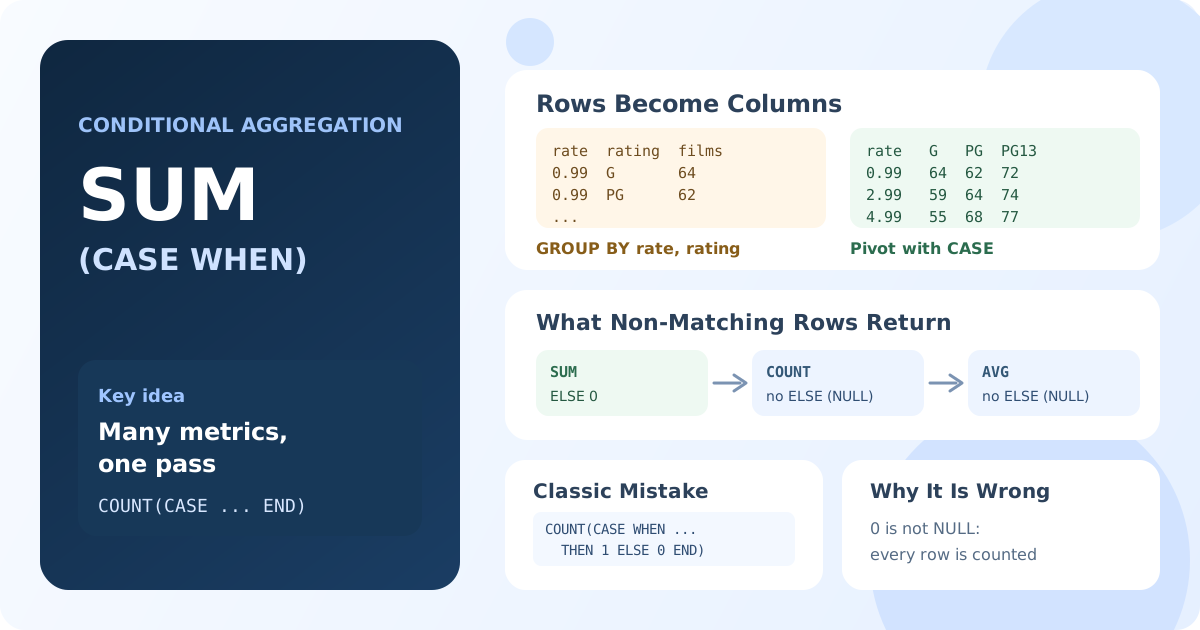
Основная идея
Агрегатная функция обрабатывает каждую строку группы. CASE внутри неё решает, какой вклад вносит строка:
SUM(CASE WHEN condition THEN value ELSE 0 END)
COUNT(CASE WHEN condition THEN 1 END)
AVG(CASE WHEN condition THEN value END)
Строки, не подходящие под условие, дают в сумму 0 или NULL, который агрегатные функции пропускают. Так каждая метрика считается только по «своим» строкам, а все метрики - за один проход по таблице.
Условная сумма
SELECT staff_id,
       SUM(CASE WHEN amount < 2 THEN amount ELSE 0 END) AS low_total,
       SUM(CASE WHEN amount >= 2 AND amount < 6 THEN amount ELSE 0 END) AS medium_total,
       SUM(CASE WHEN amount >= 6 THEN amount ELSE 0 END) AS high_total,
       SUM(amount) AS total
FROM payment
GROUP BY staff_id;
Результат: для каждого сотрудника выручка от маленьких, средних и крупных платежей и общая сумма. Три диапазона в сумме дают общий итог.
Для SUM ELSE 0 - правильный выбор: строки вне диапазона ничего не добавляют. Без ELSE диапазон, в который не попала ни одна строка, вернёт NULL вместо 0.
Условный подсчёт
SELECT staff_id,
       COUNT(CASE WHEN amount < 2 THEN 1 END) AS low_payments,
       COUNT(CASE WHEN amount >= 2 AND amount < 6 THEN 1 END) AS medium_payments,
       COUNT(CASE WHEN amount >= 6 THEN 1 END) AS high_payments
FROM payment
GROUP BY staff_id;
Результат: количество платежей в каждом диапазоне для каждого сотрудника.
COUNT(expression) считает значения, отличные от NULL. Когда условие ложно и ELSE нет, CASE возвращает NULL, и строка не учитывается.
Частая ошибка: COUNT(CASE WHEN ... THEN 1 ELSE 0 END). Ноль - это не NULL, поэтому COUNT считает каждую строку, и во всех трёх столбцах получается одно и то же число. Если вам удобнее ELSE 0, используйте SUM: SUM(CASE WHEN ... THEN 1 ELSE 0 END).
Столбец можно посчитать и напрямую. COUNT(return_date) считает только возвращённые аренды:
SELECT staff_id,
       COUNT(*) AS all_rentals,
       COUNT(return_date) AS returned,
       COUNT(CASE WHEN return_date IS NULL THEN 1 END) AS not_returned
FROM rental
GROUP BY staff_id;
Результат: для каждого сотрудника все аренды, возвращённые аренды и аренды, по которым фильм ещё не вернули.
Условное среднее
SELECT staff_id,
       AVG(amount) AS avg_payment,
       AVG(CASE WHEN amount >= 5 THEN amount END) AS avg_big_payment
FROM payment
GROUP BY staff_id;
Результат: для каждого сотрудника среднее всех платежей и среднее платежей от $5.
Для AVG не пишите ELSE 0. Среднее - это сумма, делённая на количество значений; нули будут учтены как значения и занизят среднее. Без ELSE неподходящие строки дают NULL и пропускаются.
| Функция | Что возвращать для неподходящих строк |
|---|---|
SUM(CASE ...) | ELSE 0 |
COUNT(CASE ...) | без ELSE (NULL) |
AVG(CASE ...), MIN, MAX | без ELSE (NULL) |
Pivot: строки в столбцы
Сводная таблица (pivot) показывает значения категории в виде отдельных столбцов. Обычный GROUP BY rental_rate, rating даёт по строке на каждую комбинацию. С условной агрегацией каждый рейтинг становится столбцом:
SELECT rental_rate,
       COUNT(CASE WHEN rating = 'G' THEN 1 END) AS g,
       COUNT(CASE WHEN rating = 'PG' THEN 1 END) AS pg,
       COUNT(CASE WHEN rating = 'PG-13' THEN 1 END) AS pg13,
       COUNT(CASE WHEN rating = 'R' THEN 1 END) AS r,
       COUNT(CASE WHEN rating = 'NC-17' THEN 1 END) AS nc17,
       COUNT(*) AS all_films
FROM film
GROUP BY rental_rate
ORDER BY rental_rate;
Результат: три строки, по одной на ставку аренды ($0.99, $2.99, $4.99), с количеством фильмов каждого рейтинга в отдельных столбцах.
То же работает и с другими агрегатами. Средняя длительность фильмов по рейтингу - снова без ELSE:
SELECT rental_rate,
       ROUND(AVG(CASE WHEN rating = 'G' THEN length END), 1) AS g_avg_length,
       ROUND(AVG(CASE WHEN rating = 'R' THEN length END), 1) AS r_avg_length
FROM film
GROUP BY rental_rate
ORDER BY rental_rate;
Pivot по дням недели, построенный из даты:
SELECT MONTH(rental_date) AS rental_month,
       SUM(CASE WHEN DAYOFWEEK(rental_date) IN (1, 7) THEN 1 ELSE 0 END) AS weekend_rentals,
       SUM(CASE WHEN DAYOFWEEK(rental_date) BETWEEN 2 AND 6 THEN 1 ELSE 0 END) AS weekday_rentals
FROM rental
GROUP BY MONTH(rental_date)
ORDER BY rental_month;
Результат: для каждого месяца количество аренд в выходные и в будни. В MySQL DAYOFWEEK() возвращает 1 для воскресенья и 7 для субботы.
В некоторых СУБД есть оператор PIVOT (SQL Server, Oracle), но условная агрегация работает везде и является переносимым вариантом.
Доли и соотношения
Две условные агрегации можно объединить в одном выражении:
SELECT customer_id,
       COUNT(*) AS payments,
       ROUND(100 * SUM(CASE WHEN amount >= 5 THEN 1 ELSE 0 END) / COUNT(*), 1) AS big_payment_pct
FROM payment
GROUP BY customer_id
ORDER BY big_payment_pct DESC
LIMIT 10;
Результат: 10 клиентов с наибольшей долей платежей от $5.
Предложение FILTER
PostgreSQL и SQLite (3.30+) поддерживают более короткий стандартный синтаксис FILTER:
-- PostgreSQL, SQLite
SELECT customer_id,
       COUNT(*) AS all_payments,
       COUNT(*) FILTER (WHERE amount >= 5) AS big_payments,
       SUM(amount) FILTER (WHERE amount >= 5) AS big_total
FROM payment
GROUP BY customer_id;
Это то же самое, что COUNT(CASE WHEN amount >= 5 THEN 1 END). MySQL, MariaDB и SQL Server не поддерживают FILTER, поэтому переносимой формой остаётся CASE.
Ключевые выводы:
- Условная агрегация - это агрегатная функция с
CASEвнутри: несколько метрик за один запрос и один проход. SUM(CASE ... ELSE 0 END)для сумм;COUNT(CASE ... END)безELSEдля подсчёта.COUNT(CASE ... ELSE 0 END)считает все строки - частая ошибка.AVG(CASE ...)пишите безELSE, иначе нули занизят среднее.- Pivot с
CASEпревращает значения категории в столбцы и работает в любой СУБД.
Часто задаваемые вопросы
Что такое условная агрегация в SQL?
Это агрегатная функция, аргументом которой служит выражение CASE, например SUM(CASE WHEN amount >= 5 THEN amount ELSE 0 END). Каждая метрика считается только по строкам, подходящим под её условие, поэтому один запрос может вернуть много метрик с разными фильтрами.
Почему COUNT(CASE WHEN ... ELSE 0 END) считает все строки?
COUNT считает значения, отличные от NULL, а 0 - не NULL. Уберите ELSE, чтобы неподходящие строки возвращали NULL, или используйте SUM(CASE WHEN ... THEN 1 ELSE 0 END).
Как превратить строки в столбцы в MySQL?
В MySQL нет оператора PIVOT. Используйте по одной условной агрегации на каждый выходной столбец: COUNT(CASE WHEN rating = 'G' THEN 1 END) AS g, и группируйте по измерению строк.