Урок 9.6 · Время чтения: ~10 мин
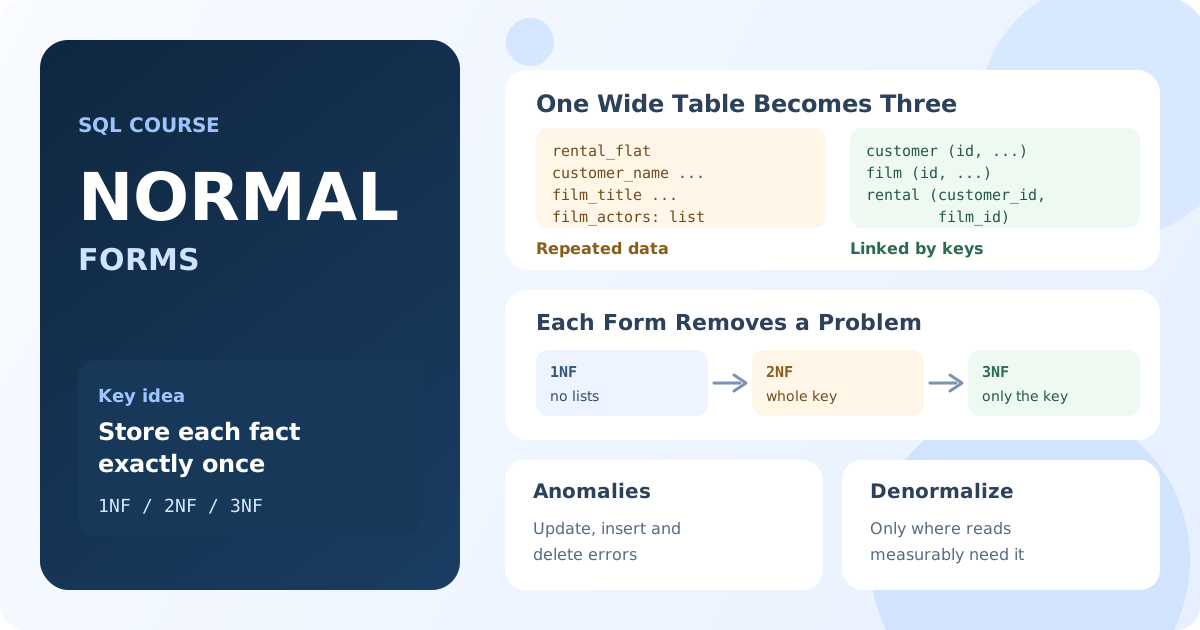
Нормализация баз данных — это способ проектировать таблицы так, чтобы каждый факт хранился ровно в одном месте. Нормализованная база разносит данные по связанным таблицам, которые ссылаются друг на друга по ключам: это убирает дубли и ошибки, которые из-за них возникают. В этом уроке вы разберете первые три нормальные формы (1НФ, 2НФ, 3НФ) и НФБК, научитесь разделять широкую таблицу с помощью SQL и узнаете, когда намеренное дублирование данных лучше.
Нормализация баз данных: 1НФ, 2НФ и 3НФ
В предыдущих уроках модуля вы создавали таблицы, изменяли их и строили поверх них представления. Остался вопрос, какие таблицы создавать изначально: что хранить в одной таблице, а что вынести в отдельную.
На этот вопрос отвечает нормализация — набор формальных правил, которые называются нормальными формами. База Sakila хорошо нормализована, поэтому примеры в уроке построены на ее таблицах.
Что такое нормализация баз данных
Нормализация — это организация столбцов и таблиц по таким принципам:
- каждая таблица описывает один вид сущностей: клиента, фильм, аренду;
- каждый факт хранится один раз, а другие таблицы ссылаются на него по ключу;
- каждый неключевой столбец зависит от ключа своей таблицы, и только от него.
Правила сгруппированы в нормальные формы: 1НФ, 2НФ, 3НФ, НФБК (нормальная форма Бойса–Кодда) и более высокие. Каждая следующая форма включает предыдущую. На практике схему в третьей нормальной форме (3НФ) считают нормализованной: более высокие формы касаются редких случаев.
Зачем нормализовать: аномалии данных
Представьте, что аренды хранятся в одной широкой таблице:
| rental_id | rental_date | customer_email | customer_name | customer_city | film_title | film_actors |
|---|---|---|---|---|---|---|
| 1 | 2026-05-01 | mary@example.org | MARY SMITH | Sasebo | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
| 2 | 2026-05-02 | mary@example.org | MARY SMITH | Sasebo | ACE GOLDFINGER | BOB FAWCETT, MINNIE ZELLWEGER |
| 3 | 2026-05-02 | patricia@example.org | PATRICIA JOHNSON | San Bernardino | ACADEMY DINOSAUR | PENELOPE GUINESS, CHRISTIAN GABLE |
Такую таблицу удобно читать, но данные клиента и фильма повторяются в каждой аренде. Из-за этого возникают три вида проблем, которые называют аномалиями:
- Аномалия обновления. Мэри переезжает в другой город. Нужно обновить все ее аренды; если пропустить хотя бы одну строку, в базе окажется два разных города одного клиента.
- Аномалия вставки. Новый фильм нельзя добавить, пока его кто-нибудь не возьмет в аренду: каждая строка — это аренда.
- Аномалия удаления. Удаление единственной аренды Патрисии удаляет и все сведения о самой Патрисии.
Нормализация устраняет эти аномалии: каждый факт переезжает в таблицу, к которой он относится.
Первая нормальная форма (1НФ)
Таблица находится в первой нормальной форме, если:
- в каждом столбце хранится одно (атомарное) значение, а не список;
- нет повторяющихся групп столбцов вроде
phone1,phone2,phone3; - каждую строку можно найти по первичному ключу.
Столбец film_actors из примера выше нарушает 1НФ: в одном значении хранится список имен. По такому столбцу сложно делать запросы. Чтобы найти фильмы с Пенелопой Гиннесс, приходится искать подстроку через LIKE, а такой поиск не использует индекс и по ошибке находит похожие имена. Посчитать число фильмов у каждого актера еще сложнее.
В Sakila есть реальный пример такого компромисса. В MySQL столбец film.special_features имеет тип SET и хранит значения вида Trailers,Commentaries:
SELECT special_features, COUNT(*) AS films
FROM film
GROUP BY special_features
ORDER BY films DESC
LIMIT 3;
Результат: 15 сочетаний из четырех вариантов, первое — Trailers,Commentaries,Behind the Scenes (79 фильмов). Чтобы посчитать фильмы по каждому варианту отдельно, эти строки придется разбирать.
Решение по 1НФ — отдельная таблица, где на каждое значение приходится одна строка. Так в Sakila хранятся актеры: таблица film_actor содержит по одной паре (actor_id, film_id) в строке.
SELECT a.first_name, a.last_name, COUNT(*) AS films
FROM film_actor AS fa
JOIN actor AS a ON a.actor_id = fa.actor_id
GROUP BY a.actor_id, a.first_name, a.last_name
ORDER BY films DESC
LIMIT 3;
Результат: актеры с наибольшим числом фильмов, первой идет GINA DEGENERES (42 фильма). Если бы актеры хранились списком в текстовом столбце, такой запрос было бы трудно написать.
Вторая нормальная форма (2НФ)
Таблица находится во второй нормальной форме, если она в 1НФ и каждый неключевой столбец зависит от всего первичного ключа, а не от его части.
2НФ важна только для таблиц с составным ключом из нескольких столбцов. Допустим, в film_actor хранились бы еще и названия:
| actor_id | film_id | actor_name | film_title |
|---|---|---|---|
| 1 | 1 | PENELOPE GUINESS | ACADEMY DINOSAUR |
| 1 | 23 | PENELOPE GUINESS | ANACONDA CONFESSIONS |
Ключ здесь — (actor_id, film_id), но actor_name зависит только от actor_id, а film_title — только от film_id. Это частичная зависимость: имя актера повторяется для каждого его фильма.
Чтобы ее устранить, каждый столбец переносят в таблицу, от ключа которой он зависит: имена — в actor, названия — в film. Настоящая таблица film_actor хранит только два ключа и last_update.
Третья нормальная форма (3НФ)
Таблица находится в третьей нормальной форме, если она во 2НФ и ни один неключевой столбец не зависит от другого неключевого столбца. Такая цепочка ключ → столбец A → столбец B называется транзитивной зависимостью.
Например, если бы таблица address хранила страну:
| address_id | address | city_id | city | country |
|---|---|---|---|---|
| 5 | 1913 Hanoi Way | 463 | Sasebo | Japan |
| 6 | 1121 Loja Avenue | 449 | San Bernardino | United States |
city и country зависят от city_id, а не от address_id. Каждый адрес в одном городе повторяет название города и страну, и при переименовании страны пришлось бы обновлять тысячи адресов.
В Sakila это решено цепочкой таблиц: address хранит city_id, city хранит country_id, а название страны есть только в country. Каждое название хранится один раз, а запрос собирает их через JOIN:
SELECT co.country, COUNT(*) AS customers
FROM customer AS c
JOIN address AS a ON a.address_id = c.address_id
JOIN city AS ci ON ci.city_id = a.city_id
JOIN country AS co ON co.country_id = ci.country_id
GROUP BY co.country
ORDER BY customers DESC
LIMIT 5;
Результат: India (60), China (53), United States (36), Japan (31) и Mexico (30). Нормализованные данные читают через соединения — это плата за то, что каждый факт хранится один раз.
Короткая формула для 1НФ–3НФ: каждый неключевой столбец должен зависеть от ключа, от всего ключа и ни от чего, кроме ключа.
Нормальная форма Бойса–Кодда (НФБК)
НФБК (BCNF) — более строгий вариант 3НФ: каждый столбец, от которого зависит другой столбец, должен быть потенциальным ключом. Разница проявляется только в таблицах с несколькими пересекающимися потенциальными ключами, а они встречаются редко. Большинство таблиц в 3НФ уже находятся в НФБК. Четвертая и пятая нормальные формы касаются многозначных зависимостей, и за пределами теории баз данных их обсуждают редко.
Как нормализовать таблицу с помощью SQL
Разделим широкую таблицу из начала урока (пусть она называется rental_flat) на нормализованные таблицы. Выполняйте эти команды в своей базе: учебные базы на SQLtest доступны только для чтения. Сначала новая структура:
CREATE TABLE customer_n (
    customer_id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(50) NOT NULL UNIQUE,
    name VARCHAR(90) NOT NULL,
    city VARCHAR(50) NOT NULL
);

CREATE TABLE film_n (
    film_id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL UNIQUE
);

CREATE TABLE rental_n (
    rental_id INT PRIMARY KEY,
    rental_date DATE NOT NULL,
    customer_id INT NOT NULL,
    film_id INT NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customer_n (customer_id),
    FOREIGN KEY (film_id) REFERENCES film_n (film_id)
);
Примечание: это синтаксис MySQL. В PostgreSQL замените INT AUTO_INCREMENT на INT GENERATED ALWAYS AS IDENTITY.
Затем переносим данные. SELECT DISTINCT оставляет по одной строке на клиента и на фильм, а аренды находят свои ключи через JOIN:
INSERT INTO customer_n (email, name, city)
SELECT DISTINCT customer_email, customer_name, customer_city
FROM rental_flat;

INSERT INTO film_n (title)
SELECT DISTINCT film_title
FROM rental_flat;

INSERT INTO rental_n (rental_id, rental_date, customer_id, film_id)
SELECT r.rental_id, r.rental_date, c.customer_id, f.film_id
FROM rental_flat AS r
JOIN customer_n AS c ON c.email = r.customer_email
JOIN film_n AS f ON f.title = r.film_title;
Результат: 2 клиента, 2 фильма и 3 аренды. Город Мэри теперь хранится в одной строке, и один UPDATE меняет его везде.
Если SELECT DISTINCT вернет две строки с одинаковым email, значит, данные уже противоречивы: у одного клиента в разных арендах разные имена или города. Ограничение UNIQUE на email не пропустит вторую строку, и придется решить, какое значение верное. Нормализация часто вскрывает такие проблемы.
Список актеров так же выносится в пару таблиц actor и film_actor. Город — по примеру из раздела про 3НФ: отдельная таблица city и столбец city_id в customer_n.
Денормализация: когда дубли допустимы
Денормализация — это намеренное хранение избыточных данных, чтобы чтение стало быстрее или проще. Это осознанный компромисс, а не ошибка проектирования, и даже в Sakila есть такие примеры:
paymentхранитcustomer_id, хотя его можно найти черезrental_id. Дубль экономит соединение в отчетах по платежам; значения совпадают во всех 16 044 платежах, связанных с арендой.- Таблица
film_textповторяетtitleиdescriptionизfilmдля полнотекстового поиска. - Представление
film_listвозвращает актеров одной строкой через запятую. Представление ничего не хранит, поэтому дает удобный широкий формат без аномалий.
Типичные причины денормализовать:
- отчеты и дашборды, которые на каждый запрос соединяют много больших таблиц;
- счетчики и итоги, например общая сумма платежей клиента, которые дорого пересчитывать;
- аналитические хранилища со схемой «звезда», куда данные загружают пакетами и редко обновляют.
Практическое правило: сначала проектируйте нормализованную схему, а денормализуйте только те места, где измерили проблему с производительностью. Для каждого дубля нужен способ поддерживать его актуальным: триггер, задание по расписанию или код приложения.
Ключевые выводы этого урока:
- Нормализация хранит каждый факт один раз и связывает таблицы ключами; она предотвращает аномалии обновления, вставки и удаления.
- 1НФ: одно значение в столбце, без списков и повторяющихся групп столбцов, первичный ключ в каждой таблице.
- 2НФ: ни один столбец не зависит от части составного ключа.
- 3НФ: ни один столбец не зависит от другого неключевого столбца — «от ключа, от всего ключа и ни от чего, кроме ключа».
- Нормализованные данные читают через
JOIN; представление может показать их в широком формате. - Денормализуйте осознанно и только там, где этого требует чтение, с планом синхронизации копий.
Этим уроком завершается модуль о создании и изменении таблиц. Следующий модуль посвящен тому, как писать понятный и быстрый SQL: лучшим практикам, оптимизации запросов и индексам.
Часто задаваемые вопросы
Что такое нормализация базы данных?
Нормализация — это организация данных в связанные таблицы так, чтобы каждый факт хранился только один раз. Она убирает дублирование и связанные с ним аномалии, например когда у одного клиента в разных строках оказываются разные адреса.
Чем отличаются 1НФ, 2НФ и 3НФ?
1НФ требует атомарных значений и первичного ключа. 2НФ дополнительно запрещает столбцы, которые зависят только от части составного ключа. 3НФ дополнительно запрещает столбцы, которые зависят от других неключевых столбцов, например название страны рядом с идентификатором города.
Всегда ли нормализованная база лучше?
Для изменяемых данных обычно да: она сохраняет данные согласованными, а схему гибкой. Для отчетов и аналитики контролируемая денормализация может сильно ускорить чтение. Начинайте с нормализованной схемы и денормализуйте там, где потребность подтверждена измерениями.
Замедляет ли нормализация запросы?
Для чтения нужно больше соединений, и это стоит времени, но с индексами по ключевым столбцам соединения работают быстро. Запись часто становится быстрее: изменение затрагивает одну строку, а не множество копий.
Вопросы на собеседовании
Объясните аномалии обновления, вставки и удаления.
Аномалия обновления — один факт хранится в нескольких строках, и при обновлении часть из них пропускают. Аномалия вставки — нельзя добавить факт без посторонних данных, например фильм без аренды. Аномалия удаления — удаление одного факта удаляет и другой, например удаление единственной аренды клиента удаляет сведения о клиенте.
Что такое транзитивная зависимость? Приведите пример.
Это зависимость неключевого столбца от другого неключевого столбца, а не от ключа. В таблице address(address_id, city_id, city_name) столбец city_name зависит от city_id, а не от address_id. Решение — отдельная таблица city, после чего схема находится в 3НФ.
Когда стоит денормализовать схему?
Когда чтений намного больше, чем записей, и соединения стали измеренным узким местом — например, в отчетах, дашбордах и хранилищах данных. Избыточные данные храните вместе с понятным способом их синхронизации: триггером или обновлением по расписанию.