Регистр в SQL в разных СУБД
Урок 1.9 · Время чтения: ~9 мин
Регистр в SQL важен на трёх уровнях: ключевые слова, имена объектов и данные. Ключевые слова вроде SELECT не зависят от регистра ни в одной СУБД, а вот одна ли это таблица - Customer и customer - зависит от СУБД, от кавычек и иногда даже от операционной системы. В этом уроке вы узнаете правила популярных СУБД, классическую ловушку с именами в кавычках, то, как сравнение строк учитывает регистр, и стиль именования, который избавляет от всех этих проблем.
В уроке 1.8 вы видели, что СУБД следуют стандарту SQL, но у каждой свой диалект. Регистр - одно из самых заметных различий: запрос, который работает в SQL Server, в PostgreSQL падает с ошибкой relation "Customer" does not exist, а запрос, написанный на ноутбуке с Windows, не работает на сервере с Linux.
Если знать правила до первых запросов, не придётся часами искать таблицу, которая «точно есть».
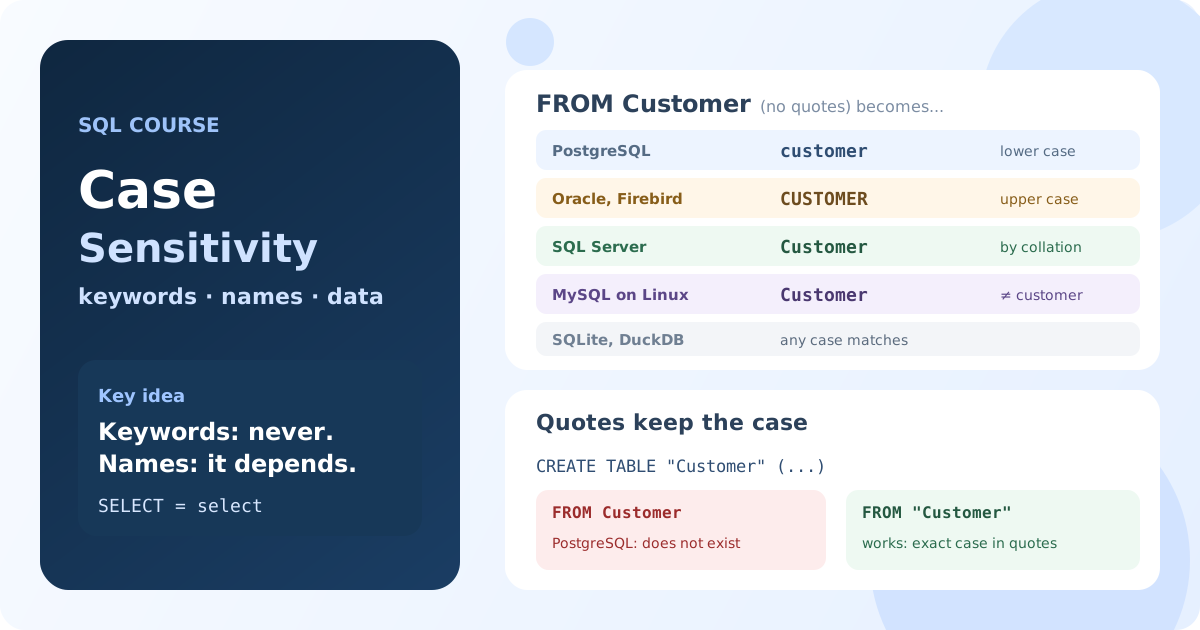
Три уровня регистра в SQL
Вопрос «чувствителен ли SQL к регистру?» может означать три разные вещи:
- Ключевые слова и имена функций:
SELECT,select,COUNT,count. - Идентификаторы: имена баз данных, таблиц, столбцов и псевдонимов, с которыми вы познакомились в уроке 1.7.
- Данные: равна ли строка
'abc'строке'ABC'в условииWHERE.
У каждого уровня свои правила, разберём их по очереди.
Ключевые слова SQL не зависят от регистра
Ключевые слова и имена встроенных функций можно писать в любом регистре в любой СУБД:
sElEcT title
FrOm film
WhErE film_id = 1;
Результат: ACADEMY DINOSAUR. MySQL, PostgreSQL, SQL Server, Oracle, Firebird и SQLite выполняют запрос при любом сочетании регистров.
Ключевые слова ЗАГЛАВНЫМИ буквами - лишь соглашение: так язык отделяется от имён таблиц и столбцов, и длинные запросы легче читать. В этом курсе ключевые слова пишутся заглавными, а имена строчными, и большинство руководств по стилю советуют то же самое.
Имена без кавычек: каждая СУБД приводит регистр по-своему
По стандарту SQL имя без кавычек переводится в верхний регистр, поэтому customer, Customer и CUSTOMER - одно и то же имя. СУБД реализуют эту идею по-разному.
PostgreSQL: имена становятся строчными
PostgreSQL переводит каждое имя без кавычек в нижний регистр, то есть делает противоположное стандарту:
SELECT Model, AIRCRAFT_CODE
FROM Aircrafts
WHERE aircraft_code = '773';
Результат: Boeing 777-300. Таблица хранится как aircrafts, а заголовки столбцов возвращаются как model и aircraft_code.
Псевдонимы тоже переводятся: SELECT model AS TotalModel вернёт столбец с именем totalmodel. Набранный вами регистр исчезает сразу при разборе запроса.
Oracle и Firebird: имена становятся заглавными
Oracle и Firebird следуют стандарту и переводят имена без кавычек в верхний регистр:
select first_name, Last_Name
from Employee
where emp_no = 2;
Результат в Firebird: Robert Nelson с заголовками FIRST_NAME и LAST_NAME. В Oracle с hr.Employees происходит то же самое.
Поэтому инструменты показывают таблицы Oracle и Firebird заглавными буквами: EMPLOYEES, EMPLOYEE.
SQL Server: решает collation
SQL Server вообще не меняет регистр имён. Он сохраняет регистр из CREATE TABLE и сравнивает имена по collation (сопоставлению) базы данных - набору правил сравнения текста.
Collation по умолчанию, например SQL_Latin1_General_CP1_CI_AS, не учитывает регистр (CI), поэтому эти имена совпадают:
select name, listprice
from PRODUCT
where productid = 680;
Результат: HL Road Frame - Black, 58. В AdventureWorks заголовки возвращаются так, как вы их набрали: name и listprice.
В базе, созданной с collation, учитывающим регистр (_CS_), Product и PRODUCT - разные имена. Такие базы редки, но встречаются, поэтому прежде чем на что-то рассчитывать, проверьте DATABASEPROPERTYEX(DB_NAME(), 'Collation').
MySQL и MariaDB: имена таблиц зависят от операционной системы
В MySQL и MariaDB база данных - это папка, а таблица - файл, поэтому правила регистра для баз и таблиц берутся из файловой системы. Ими управляет настройка lower_case_table_names:
| Значение | По умолчанию в | Имена таблиц |
|---|---|---|
0 | Linux | хранятся как написаны, сравниваются с учётом регистра |
1 | Windows | хранятся строчными, сравниваются без учёта регистра |
2 | macOS | хранятся как написаны, сравниваются без учёта регистра |
Песочница курса работает на Linux, поэтому неверный регистр имени таблицы - это ошибка:
SELECT title
FROM FILM
WHERE film_id = 1;
Результат: Table 'sakila.FILM' doesn't exist. С FROM film запрос работает.
На Linux Customer и customer могут быть даже двумя разными таблицами в одной базе. Псевдонимы таблиц подчиняются тому же правилу: FROM film F с WHERE f.film_id = 1 падает с ошибкой Unknown column 'f.title'.
А вот имена столбцов в MySQL и MariaDB не зависят от регистра на любой системе: SELECT TITLE, Film_ID FROM film работает.
SQLite и DuckDB: регистр не важен никогда
SQLite и DuckDB сравнивают имена без учёта регистра, даже в кавычках, и запоминают регистр, с которым объект был создан:
CREATE TEMP TABLE "Customer" ("FullName" text);
INSERT INTO "Customer" VALUES ('Orlando Gee');

SELECT fullname
FROM CUSTOMER;
Результат в SQLite и DuckDB: Orlando Gee под заголовком FullName. Вторую таблицу с именем customer создать нельзя: имя занято.
Имена в кавычках сохраняют регистр
Кавычки превращают имя в идентификатор в кавычках (delimited identifier): СУБД использует его ровно так, как оно написано, вместе с регистром, пробелами и зарезервированными словами. Стандарт использует двойные кавычки, MySQL - обратные кавычки, а SQL Server принимает ещё и квадратные скобки:
| СУБД | Имя в кавычках |
|---|---|
| PostgreSQL, Oracle, Firebird, SQLite, DuckDB | "Customer" |
| MySQL, MariaDB | `Customer` |
| SQL Server | [Customer] или "Customer" |
В PostgreSQL, Oracle и Firebird имя в кавычках чувствительно к регистру. Отсюда самая частая ошибка, связанная с регистром.
Ловушка "Customer" в PostgreSQL
Многие инструменты, ORM и скрипты миграций создают таблицы с именами в кавычках. Вот что происходит дальше:
CREATE TEMP TABLE "Customer" ("CustomerID" int, "FullName" text);
INSERT INTO "Customer" VALUES (1, 'Orlando Gee');

SELECT *
FROM Customer;
Результат: relation "customer" does not exist. Customer без кавычек превратился в customer, а таблица называется Customer.
Если имя создано в кавычках и с заглавными буквами, каждый запрос тоже должен брать его в кавычки с точно таким же регистром:
SELECT "FullName"
FROM "Customer";
Результат: Orlando Gee. Без кавычек SELECT FullName падает с ошибкой column "fullname" does not exist.
PostgreSQL даже подсказывает: Perhaps you meant to reference the column "Customer.FullName". У Oracle и Firebird зеркальная проблема: hr."employees" не находится, потому что таблица хранится как EMPLOYEES.
Двойные кавычки в MySQL - это строка
В MySQL и MariaDB двойные кавычки вообще не обозначают имя: по умолчанию это строка, как и одинарные кавычки:
SELECT "title"
FROM film
WHERE film_id = 1;
Результат: слово title, а не название фильма. MySQL возвращает текстовую константу 'title' для каждой строки.
Ошибки нет, поэтому промах легко не заметить. В MySQL используйте для имён обратные кавычки или включите режим ANSI_QUOTES, чтобы двойные кавычки работали по стандарту.
Регистр в данных: сравнение строк
Третий уровень - сами данные. Истинно ли 'abc' = 'ABC', зависит от СУБД и от collation столбца:
| СУБД | 'abc' = 'ABC' по умолчанию | LIKE | Поиск без учёта регистра |
|---|---|---|---|
| MySQL, MariaDB | истина | без учёта регистра | уже по умолчанию; BINARY или collation _bin для точного |
| SQL Server | истина (collation CI) | без учёта регистра | уже по умолчанию; COLLATE ..._CS_AS для точного |
| PostgreSQL | ложь | с учётом регистра | ILIKE, LOWER() |
| Oracle | ложь | с учётом регистра | UPPER(), LOWER() |
| Firebird | ложь | с учётом регистра | CONTAINING, UPPER() |
| SQLite | ложь | без учёта регистра (латиница) | COLLATE NOCASE, LOWER() |
| DuckDB | ложь | с учётом регистра | ILIKE, COLLATE NOCASE |
Одно и то же условие даёт разные результаты. В PostgreSQL в базе Bookings нет города 'moscow':
SELECT COUNT(*)
FROM airports
WHERE city = 'moscow';
Результат: 0. С WHERE lower(city) = 'moscow' или WHERE city ILIKE 'moscow' запрос находит 3 аэропорта Москвы.
В MySQL похожий запрос к Sakila сразу находит актёров:
SELECT COUNT(*)
FROM actor
WHERE last_name = 'davis';
Результат: 3, хотя фамилии хранятся как DAVIS. С WHERE BINARY last_name = 'davis' результат - 0.
Поэтому запрос, перенесённый из MySQL или SQL Server в PostgreSQL, может незаметно вернуть меньше строк. Если регистр данных не важен, скажите об этом в запросе явно: сравнивайте LOWER(столбец) со значением в нижнем регистре. Collation отвечает не только за регистр, но и за сортировку и диакритику, и ему будет посвящён отдельный урок курса.
Регистр в разных СУБД
| СУБД | Имена без кавычек | Имена в кавычках | 'abc' = 'ABC' |
|---|---|---|---|
| PostgreSQL | нижний регистр | с учётом регистра | ложь |
| Oracle | верхний регистр | с учётом регистра | ложь |
| Firebird | верхний регистр | с учётом регистра | ложь |
| SQL Server | как написаны, сравниваются по collation (обычно без учёта регистра) | так же, как без кавычек | истина при collation CI |
| MySQL, MariaDB | таблицы и базы: зависят от lower_case_table_names (на Linux с учётом регистра); столбцы: без учёта регистра | так же, как без кавычек | истина |
| SQLite | без учёта регистра | без учёта регистра | ложь |
| DuckDB | без учёта регистра | без учёта регистра | ложь |
Ключевые слова и имена функций во всех этих СУБД регистр не учитывают.
Правила именования, которые избавляют от проблем с регистром
Всю таблицу помнить не нужно, если соблюдать несколько правил:
- Называйте таблицы и столбцы строчными буквами с подчёркиваниями:
customer_order,total_amount. Такие имена значат одно и то же в любой СУБД и никогда не требуют кавычек. - Не создавайте имена в кавычках с заглавными буквами или пробелами. Если их создал инструмент, везде берите их в кавычки с точным регистром.
- Пишите каждое имя везде в одном регистре, даже там, где СУБД это прощает: тогда запрос, написанный в Windows или SQL Server, заработает и на Linux, и в PostgreSQL.
- Ключевые слова пишите заглавными ради читаемости: СУБД всё равно.
- В текстовых условиях решите, важен ли регистр, и запишите это явно через
LOWER(),UPPER()илиILIKE, а не полагайтесь на collation по умолчанию.
Другие советы по именованию собраны в уроке 10.1. С этими правилами вы готовы к следующему модулю, где начнёте получать данные с помощью SELECT.
Ключевые выводы:
- Ключевые слова и имена функций SQL не зависят от регистра ни в одной СУБД; заглавные буквы - соглашение о стиле.
- Имена без кавычек переводятся в нижний регистр в PostgreSQL и в верхний в Oracle и Firebird; SQL Server сравнивает их по collation базы.
- В MySQL и MariaDB имена таблиц на Linux чувствительны к регистру (
lower_case_table_names = 0), а имена столбцов - нет. - Имя в кавычках сохраняет регистр: таблицу, созданную в PostgreSQL как
"Customer", всегда нужно писать как"Customer". 'abc' = 'ABC'по умолчанию истинно в MySQL и SQL Server и ложно в PostgreSQL, Oracle, Firebird, SQLite и DuckDB.- Имена в стиле
snake_caseстрочными буквами и без кавычек работают одинаково везде.
Часто задаваемые вопросы
Чувствителен ли SQL к регистру?
Ключевые слова SQL - нет: SELECT и select везде одно и то же. Имена таблиц и столбцов зависят от СУБД: PostgreSQL, Oracle и Firebird приводят имена без кавычек к одному регистру, SQL Server использует collation, а имена таблиц MySQL следуют за операционной системой. Сравнение строк зависит от collation данных.
Чувствительны ли имена таблиц к регистру в MySQL?
На Linux - да: при lower_case_table_names = 0 по умолчанию FILM и film - разные таблицы. В Windows и macOS это одна таблица. Имена столбцов не зависят от регистра на любой системе, поэтому для надёжности называйте таблицы строчными буквами.
Почему PostgreSQL пишет, что relation does not exist, хотя таблица есть?
Скорее всего, таблица создана с именем в кавычках и заглавными буквами, например "Customer". PostgreSQL переводит Customer без кавычек в вашем запросе в customer, а это другое имя. Напишите имя в двойных кавычках с точным регистром: FROM "Customer".
Как искать без учёта регистра в PostgreSQL?
Используйте ILIKE вместо LIKE (WHERE city ILIKE 'moscow') или сравнивайте значения в нижнем регистре: WHERE lower(city) = 'moscow'. Для частых запросов индекс по lower(city) делает второй вариант быстрым.
Нужно ли писать ключевые слова SQL заглавными буквами?
СУБД всё равно, так что это вопрос стиля. Заглавные ключевые слова и строчные имена - самое распространённое соглашение: так структура запроса видна сразу. Главное - писать единообразно в рамках проекта.