Урок 1.5 · Время чтения: ~7 мин
Кроме чисел, текста и дат, в базах данных есть сложные типы данных для значений со внутренней структурой: документов, списков, файлов, уникальных идентификаторов, координат и векторов для AI-поиска. Этот урок — короткая экскурсия: что хранит каждый тип, пример значения и какие СУБД его поддерживают. Запоминать синтаксис не нужно — цель в том, чтобы узнавать эти типы, когда встретите их в таблице.
Сложные типы данных в SQL
В предыдущем уроке каждый столбец хранил одно простое значение: число, строку или дату. Некоторые данные так не укладываются: набор характеристик товара, скан договора, точка на карте. Для таких данных у баз есть специальные типы.
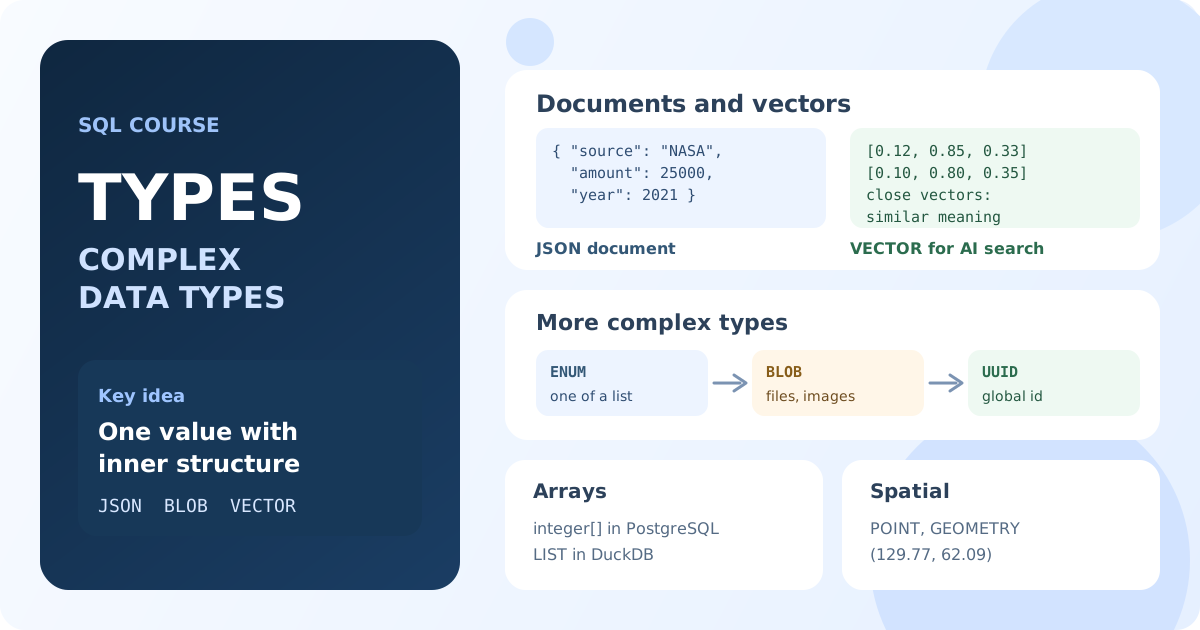
JSON: документы
Столбец JSON хранит целый документ с ключами, значениями, вложенными объектами и списками. В базе University исследовательский проект хранит свои гранты в одном JSON-столбце:
[{ "source": "Private Foundation", "amount": 244542.96, "year": 2020}]
- В MySQL и MariaDB есть тип
JSON; в PostgreSQL —jsonи более быстрый двоичныйjsonb; SQL Server и SQLite хранят JSON как текст и читают его JSON-функциями. - JSON подходит для атрибутов, которые отличаются от строки к строке или приходят из другой системы готовым документом.
XML — более старый формат документов с тем же назначением; для него в PostgreSQL и SQL Server есть тип xml.
Массивы и вложенные структуры
Массив — это список значений в одной ячейке, например [1, 2, 3]. PostgreSQL поддерживает массивы любого типа (integer[], text[]), а аналитические СУБД вроде DuckDB добавляют LIST, STRUCT и MAP. В MySQL, MariaDB, SQL Server и SQLite массивов нет: список кладут в JSON или, чаще, в отдельную таблицу, по строке на элемент.
ENUM и SET: фиксированный список значений
ENUM допускает ровно одно значение из списка, объявленного вместе со столбцом. В Sakila столбец film.rating имеет тип ENUM('G', 'PG', 'PG-13', 'R', 'NC-17'), поэтому фильм не может получить рейтинг вне этого списка. SET, тип MySQL и MariaDB, допускает любое сочетание значений из списка: film.special_features хранит значения вроде Trailers,Deleted Scenes.
В PostgreSQL перечисления создают отдельно (CREATE TYPE ... AS ENUM); в других СУБД используют обычный столбец с проверкой или справочную таблицу.
BLOB: двоичные данные
BLOB (Binary Large Object) хранит байты: изображения, PDF-файлы, архивы. В Sakila столбец staff.picture имеет тип MEDIUMBLOB и хранит фото сотрудника. Тип называется BLOB в MySQL, MariaDB и SQLite, bytea в PostgreSQL и VARBINARY(MAX) в SQL Server.
Большие файлы утяжеляют резервные копии и замедляют копирование базы, поэтому приложения часто хранят файлы в файловом хранилище, а в базе — только путь или URL в текстовом столбце.
UUID: уникальные идентификаторы
UUID — 128-битный идентификатор вида a1c7abde-ccc7-11f1-92da-da8de233f452, уникальный между таблицами, серверами и системами. Его используют, когда строки создаются во многих местах одновременно и общий счётчик завести нельзя. В PostgreSQL и MariaDB есть тип uuid, в SQL Server он называется UNIQUEIDENTIFIER, MySQL хранит UUID в CHAR(36) или BINARY(16).
Пространственные типы: точки и фигуры
Пространственные типы хранят геометрию: точки, линии и многоугольники. В базе Bookings у каждого аэропорта есть координаты coordinates типа point, например (129.77, 62.09) у Якутска. В MySQL и MariaDB есть GEOMETRY и POINT, в SQL Server — geometry и geography, а PostgreSQL получает полную поддержку от расширения PostGIS. Пространственные функции измеряют расстояния, находят, что лежит внутри области и какие объекты ближе всего.
VECTOR: эмбеддинги для AI-поиска
VECTOR — это список чисел фиксированной длины, например [0.1, 0.2, 0.3]. AI-модели превращают тексты, изображения и товары в такие векторы (эмбеддинги), так что похожие объекты получают близкие векторы. После этого база может найти строки, чьи векторы ближе всего к вектору запроса: «документы, похожие на этот вопрос». На этом построены семантический поиск и RAG-приложения.
- В MariaDB есть
VECTOR(n)начиная с версии 11.7, с функциями вродеVEC_DISTANCE_COSINE. - MySQL добавил
VECTORв версии 9, SQL Server — в версии 2025. - PostgreSQL получает векторы от расширения pgvector.
Сложные типы в разных СУБД
| Данные | MySQL | MariaDB | PostgreSQL | SQL Server | SQLite |
|---|---|---|---|---|---|
| Документ | JSON | JSON | json, jsonb, xml | текст, xml | текст |
| Список | — | — | массивы (integer[]) | — | — |
| Фиксированный список значений | ENUM, SET | ENUM, SET | CREATE TYPE ... AS ENUM | — | — |
| Двоичные данные | BLOB | BLOB | bytea | VARBINARY(MAX) | BLOB |
| Уникальный идентификатор | CHAR(36), BINARY(16) | UUID | uuid | UNIQUEIDENTIFIER | текст |
| Координаты | GEOMETRY, POINT | GEOMETRY, POINT | point, PostGIS | geometry, geography | — |
| Вектор | VECTOR (9.0+) | VECTOR (11.7+) | pgvector | VECTOR (2025) | — |
Когда использовать сложный тип
Сложный тип хорош, когда значение используется целиком или требует особого поиска: документ, который хранят и возвращают как есть, фотография, эмбеддинг для поиска похожих. Если вы часто фильтруете, соединяете или считаете по части значения — ключу внутри JSON, элементу массива, — этой части обычно место в отдельном столбце или таблице. Так запросы остаются простыми, а база может использовать обычные индексы.
Ключевые выводы:
- Сложные типы хранят значения со внутренней структурой: документы, списки, файлы, идентификаторы, координаты и векторы.
JSONхранит документы; в PostgreSQL есть ещёjsonb, массивы иxml.ENUMиSETограничивают столбец объявленным списком значений.BLOB,byteaиVARBINARYхранят двоичные файлы; большие файлы часто держат вне базы.UUIDдаёт идентификаторы, уникальные между системами; пространственные типы хранят точки и фигуры.VECTORхранит AI-эмбеддинги для поиска похожих; поддержка зависит от СУБД и её версии.
Часто задаваемые вопросы
Стоит ли хранить изображения в столбце BLOB?
Небольшие изображения — можно, но большие файлы раздувают базу и замедляют резервное копирование. Обычно файлы держат в файловом хранилище, а в базе сохраняют путь к ним.
Что лучше: JSON или отдельные столбцы?
Отдельные столбцы — для данных, которые есть в каждой строке и по которым фильтруют или соединяют. JSON — для атрибутов, которые отличаются от строки к строке или приходят готовым документом.
Что такое вектор в базе данных?
Список чисел фиксированной длины, который представляет смысл текста, изображения или другого объекта. У похожих объектов векторы близки, поэтому база может найти ближайшие к запросу.
Вопросы на собеседовании
Какие сложные типы данных вы знаете и когда их использовать?
JSON — для полуструктурированных документов, массивы — для списков в PostgreSQL, ENUM — для фиксированного набора значений, BLOB — для двоичных файлов, UUID — для глобально уникальных идентификаторов, пространственные типы — для координат, VECTOR — для эмбеддингов при поиске похожих. Каждый нужен, когда значение используется целиком или требует своих особых операций.
Чем плохо хранить данные в JSON вместо столбцов?
Значения внутри JSON труднее проверять, ограничивать, соединять и индексировать; запросы становятся длиннее, а ошибки типов обнаруживаются только при чтении данных.
Почему векторные базы данных важны для AI-приложений?
AI-модели представляют тексты и изображения в виде эмбеддингов. База с векторным типом и поиском ближайших соседей быстро находит самые похожие объекты — на этом построены семантический поиск и генерация с дополнением выборкой (RAG).