Урок 10.6 · Время чтения: ~10 мин
Полнотекстовый индекс (full-text index) — это индекс слов в текстовых столбцах: для каждого слова он хранит строки, в которых оно встречается. Он позволяет находить строки по словам и сортировать их по релевантности, а LIKE '%слово%' для этого приходится читать всю таблицу. В этом уроке вы создадите полнотекстовый индекс в MySQL, научитесь искать через MATCH … AGAINST в естественном и булевом режимах, узнаете правила, из-за которых некоторые слова не находятся, и посмотрите, как та же задача решается в PostgreSQL.
Полнотекстовые индексы в SQL
В предыдущих уроках вы узнали, как B-tree индексы ускоряют поиск по значению или по началу значения. Поиск слова в середине текста устроен иначе: WHERE description LIKE '%astronaut%' не может использовать B-tree индекс, потому что слово может начинаться в любом месте строки.
Именно для этого и нужны полнотекстовые индексы. Примеры для MySQL выполняются на таблице Sakila film_text, у которой уже есть полнотекстовый индекс; часть про PostgreSQL проверена на PostgreSQL 17.
Что такое полнотекстовый индекс
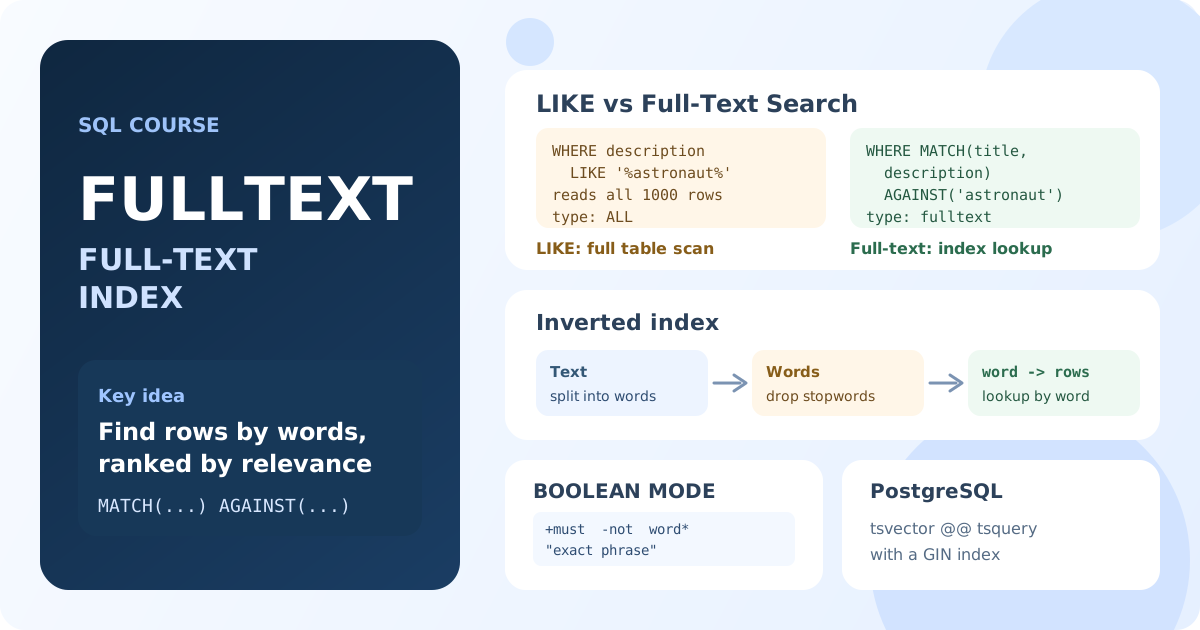
При создании полнотекстового индекса СУБД разбивает текст на слова (токены), отбрасывает слишком короткие и частые слова вроде «the» или «and» (стоп-слова) и строит инвертированный индекс: список слов, у каждого из которых — строки, где оно встречается.
| B-tree индекс | Полнотекстовый индекс | |
|---|---|---|
| Индексирует | значения столбца целиком | отдельные слова |
| Быстрый поиск | =, диапазоны, LIKE 'abc%' | слова и фразы в любом месте текста |
LIKE '%слово%' | не используется | тоже не используется |
| Порядок результата | по значению | по релевантности |
| Синтаксис MySQL | WHERE col = … | WHERE MATCH(col) AGAINST(…) |
Полнотекстовый индекс работает только со своим синтаксисом поиска: MATCH … AGAINST в MySQL, @@ в PostgreSQL. Обычный LIKE его никогда не использует.
Создание полнотекстового индекса в MySQL
Полнотекстовый индекс создают на столбцах типов CHAR, VARCHAR или TEXT:
CREATE FULLTEXT INDEX ft_film_description ON film (title, description);
То же самое делает ALTER TABLE film ADD FULLTEXT INDEX ft_film_description (title, description); или определение индекса внутри CREATE TABLE. Учебные базы на SQLtest доступны только для чтения, поэтому выполняйте эти команды в своей базе.
В Sakila такой индекс уже есть у таблицы film_text:
SHOW INDEX FROM film_text;
Результат: PRIMARY (тип BTREE) по film_id и idx_title_description (тип FULLTEXT) по столбцам title и description.
Поиск через MATCH … AGAINST
В MATCH перечисляют проиндексированные столбцы, в AGAINST — искомые слова:
SELECT film_id, title,
    ROUND(MATCH(title, description) AGAINST ('astronaut crocodile'), 3) AS score
FROM film_text
WHERE MATCH(title, description) AGAINST ('astronaut crocodile')
ORDER BY score DESC
LIMIT 5;
Результат: PHANTOM GLORY (4.239), STONE FIRE (4.196), ROAD ROXANNE, NEIGHBORS CHARADE (4.153) и LOVELY JINGLE (3.146). Фильмы, где есть оба слова, идут первыми.
Это естественный режим (natural language mode), он используется по умолчанию. Строка подходит, если в ней есть любое из слов: здесь 173 фильма содержат «astronaut» или «crocodile». Тот же MATCH … AGAINST в SELECT возвращает оценку релевантности, и по ней можно сортировать результат.
Список столбцов в MATCH должен в точности совпадать со списком столбцов полнотекстового индекса. MATCH(description) AGAINST ('astronaut') завершится ошибкой «Can't find FULLTEXT index matching the column list», потому что индекс построен по title и description вместе.
Булев режим
IN BOOLEAN MODE добавляет операторы для точного поиска:
| Оператор | Значение | Пример | Фильмов в film_text |
|---|---|---|---|
+ | слово обязательно | '+astronaut +crocodile' | 4 |
- | слова не должно быть | '+astronaut -crocodile' | 74 |
* | префикс | 'dino*' | 3 |
" " | точная фраза | '"mad scientist"' | 97 |
SELECT film_id, title
FROM film_text
WHERE MATCH(title, description) AGAINST ('+astronaut +crocodile' IN BOOLEAN MODE);
Результат: 4 фильма, в названии или описании которых есть оба слова.
Без операторов булев режим тоже находит строки с любым из слов, но не сортирует их по релевантности.
Полнотекстовый поиск и LIKE
Сравните планы двух запросов:
EXPLAIN SELECT film_id FROM film_text WHERE MATCH(title, description) AGAINST ('astronaut');

EXPLAIN SELECT film_id FROM film_text WHERE description LIKE '%astronaut%';
Результат: первый запрос использует индекс idx_title_description (тип доступа fulltext), второй читает все 1000 строк (тип ALL).
Кроме того, они находят разное:
LIKE '%cat%'находит любую подстроку: «cat», но и «category», и «Catherine». Полнотекстовый индекс находит целые слова.LIKEпроверяет один шаблон в одном столбце; полнотекстовый поиск ищет несколько слов в нескольких столбцах и ранжирует результат.- На таблице в миллионы строк
LIKE '%слово%'читает каждую строку, а полнотекстовый индекс — только список строк для слова.
Правила, которые удивляют новичков
Некоторые слова не находятся вовсе, и это не ошибка:
- Минимальная длина слова. Более короткие слова не индексируются: 3 символа в InnoDB (
innodb_ft_min_token_size), 4 в MyISAM (ft_min_word_len). Таблицаfilm_textхранится в MyISAM, поэтомуAGAINST ('cat')там ничего не находит, а в таблице InnoDB «cat» находится. - Стоп-слова. Частые слова вроде «the», «a», «and» пропускаются:
AGAINST ('the')возвращает 0 строк. - В MySQL нет словоформ. Индекс хранит слова как есть: «running» не находит «run». Для разных окончаний используйте префикс в булевом режиме:
'run*'. - Правило 50%. В естественном режиме MyISAM слово, которое встречается больше чем в половине строк, считается слишком частым и игнорируется.
Минимальная длина и список стоп-слов меняются настройками сервера, после чего индекс нужно перестроить.
Полнотекстовый поиск в PostgreSQL
В PostgreSQL нет слова FULLTEXT. Текст превращают в tsvector (список нормализованных слов), запрос — в tsquery, а оператор @@ проверяет совпадение:
SELECT to_tsvector('english', 'Runners should run slowly at first');
Результат: 'first':6 'run':3 'runner':1 'slowli':4. Слова приведены к основам, а «should» и «at» отброшены как стоп-слова.
Благодаря основам поиск «run» находит и «running», а «cats» — «cat»; MySQL так не умеет. Для скорости tsvector хранят в генерируемом столбце и индексируют через GIN — тип индекса PostgreSQL для полнотекстового поиска:
ALTER TABLE film
ADD COLUMN search tsvector
    GENERATED ALWAYS AS (to_tsvector('english', title || ' ' || description)) STORED;

CREATE INDEX film_search_idx ON film USING GIN (search);

SELECT title, ts_rank(search, query) AS rank
FROM film, websearch_to_tsquery('english', 'astronaut -crocodile') AS query
WHERE search @@ query
ORDER BY rank DESC
LIMIT 5;
Примечание: websearch_to_tsquery понимает синтаксис поисковиков — кавычки для фраз, or и - для исключения слова. ts_rank играет роль оценки релевантности MySQL.
В других СУБД свои средства: в SQL Server — полнотекстовый каталог и CONTAINS, FREETEXT, в SQLite — расширение FTS5. Для поиска по миллионам документов с учетом опечаток и синонимов используют отдельные поисковые системы, например Elasticsearch.
Когда нужен полнотекстовый индекс
Подходит:
- поиск по словам в описаниях, статьях, комментариях, названиях товаров;
- «строка поиска», где результаты должны сортироваться по релевантности;
- большие таблицы, на которых
LIKE '%слово%'стал медленным.
Не подходит:
- поиск по точному значению или по началу значения: с этим лучше справится B-tree индекс;
- короткие коды и значения короче минимальной длины слова;
- поиск произвольной подстроки внутри слова, например части артикула.
Ключевые выводы этого урока:
- Полнотекстовый индекс сопоставляет каждому слову строки, где оно встречается;
LIKE '%слово%'не использует ни B-tree, ни полнотекстовый индекс. - В MySQL его создают через
FULLTEXT INDEXи ищут черезMATCH(столбцы) AGAINST('слова'); столбцы должны в точности совпадать с индексом. - Естественный режим возвращает строки с любым из слов, отсортированные по релевантности; булев режим добавляет
+,-,*и фразы. - Короткие слова и стоп-слова не индексируются, а MySQL не учитывает словоформы: «running» не находит «run».
- В PostgreSQL используют
tsvector,tsquery, оператор@@и GIN-индекс, и там словоформы учитываются.
Часто задаваемые вопросы
Что такое полнотекстовый индекс в SQL?
Это индекс слов в текстовых столбцах: для каждого слова СУБД хранит строки, в которых оно встречается. Он делает поиск по словам быстрым и позволяет сортировать результаты по релевантности.
Почему LIKE '%слово%' не использует индекс?
B-tree индекс упорядочен по началу значения, а шаблон, начинающийся с %, может совпасть в любом месте строки, поэтому СУБД приходится читать каждую строку. Полнотекстовый поиск через MATCH … AGAINST или @@ использует полнотекстовый индекс.
Почему полнотекстовый поиск ничего не находит по короткому слову?
Слова короче минимальной длины (3 символа в InnoDB, 4 в MyISAM) и стоп-слова вроде «the» не индексируются. Ищите по более длинному слову, другим способом или измените настройки сервера и перестройте индекс.
Чем естественный режим отличается от булева?
Естественный режим находит строки с любым из слов и сортирует их по релевантности. Булев режим понимает операторы: + — обязательное слово, - — исключить слово, * — префикс, кавычки — фраза.
Вопросы на собеседовании
Чем полнотекстовый индекс отличается от B-tree индекса?
B-tree индекс хранит значения столбца целиком в отсортированном виде и подходит для поиска по равенству, диапазону и началу значения. Полнотекстовый индекс хранит отдельные слова со строками, где они встречаются, и подходит для поиска слов и фраз в любом месте текста с ранжированием по релевантности.
Как ускорить поиск с LIKE '%ключевое слово%' на большой таблице?
Добавить полнотекстовый индекс на столбцы, по которым ищут, и переписать запрос через MATCH … AGAINST в MySQL или через столбец tsvector, GIN-индекс и @@ в PostgreSQL. Проверить, что искомые слова не короче минимальной длины и не являются стоп-словами.
Почему полнотекстовый поиск может вернуть меньше строк, чем LIKE?
Полнотекстовый поиск ищет целые слова, а LIKE — подстроки, поэтому «cat» через LIKE находит и «category». Короткие слова, стоп-слова и, в MySQL, другие словоформы полнотекстовый индекс не находит вовсе.